

TavilyFreemium
Recherchez, extrayez, explorez et analysez le Web en direct pour des agents IA via une API
API Firecrawl : scraping web, tarifs et limites
Transformez des sites en Markdown propre ou en données structurées pour agents IA, RAG et automatisations.
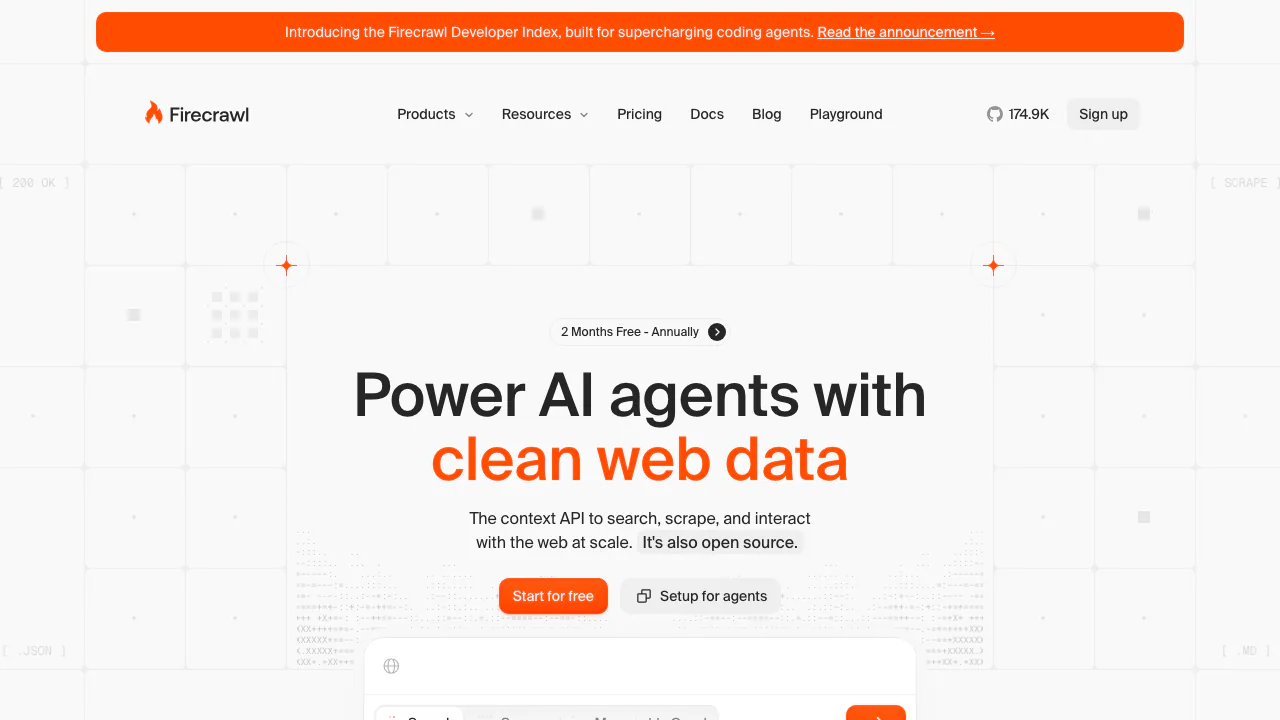
Firecrawl est une API de données web destinée aux développeurs qui alimentent un agent IA, un système RAG ou une automatisation avec des contenus récents. Elle peut rechercher sur le Web, extraire une page, explorer un site, recenser ses URL et renvoyer du Markdown nettoyé ou du JSON structuré.
Choisir le bon endpoint Firecrawl
Utilisez scrape pour une URL connue, crawl pour suivre plusieurs pages liées et map pour dresser la liste des URL. Search sert à découvrir des résultats, tandis que l’interaction navigateur vise les données accessibles après un clic, un formulaire ou un défilement. Le guide officiel des extracteurs aide à arbitrer portée et consommation.
Testez d’abord une page représentative, ne demandez que les formats utiles et contrôlez les champs, liens et URL source. Fixez ensuite profondeur, nombre de pages et concurrence. Dans un agent, considérez toujours le texte web comme une entrée non fiable et vérifiez les faits importants sur la source.
Crédits, confidentialité et responsabilités
Un quota gratuit mensuel permet de démarrer; les offres payantes augmentent crédits et concurrence. Le coût varie selon l’endpoint et les options. Consultez la grille tarifaire à jour avant d’estimer un usage en production.
Vous restez responsable des autorisations, du droit d’auteur, des données personnelles et des conditions du site ciblé. Vérifiez la politique de confidentialité et les options de conservation avant tout traitement sensible.
Firecrawl extrait-il les sites JavaScript ?
De nombreuses pages dynamiques sont prises en charge, mais les connexions, protections antibot et interactions complexes doivent être testées sur chaque cible.
Firecrawl est-il gratuit ?
Oui, un niveau gratuit comprend un quota mensuel de crédits. Les limites et coûts actuels figurent sur la page tarifaire officielle.
Outils similaires
API et infrastructure de modèles IA →
AIsaPayant
Un accès commun aux modèles et aux API de données pour vos agents.
LLM GatewayFreemium
Une API pour connecter les modèles et suivre leur coût
Experiential LabsFreemium
Un point d’accès commun pour les modèles IA, leurs routes et leurs coûts.
TrustedRouterPayant
Une passerelle compatible OpenAI pour router des requêtes entre modèles avec des contrôles de confidentialité vérifiables.
OpenRouterFreemium
Passerelle API unifiée pour modèles d'IA avancés