

Tavily免费+付费
通过一套 API 为 AI 智能体搜索、提取、爬取和研究实时网页
Firecrawl 网页抓取 API:功能、价格与使用限制
把网页转成适合 AI 智能体、RAG 与自动化使用的干净 Markdown 或结构化数据。
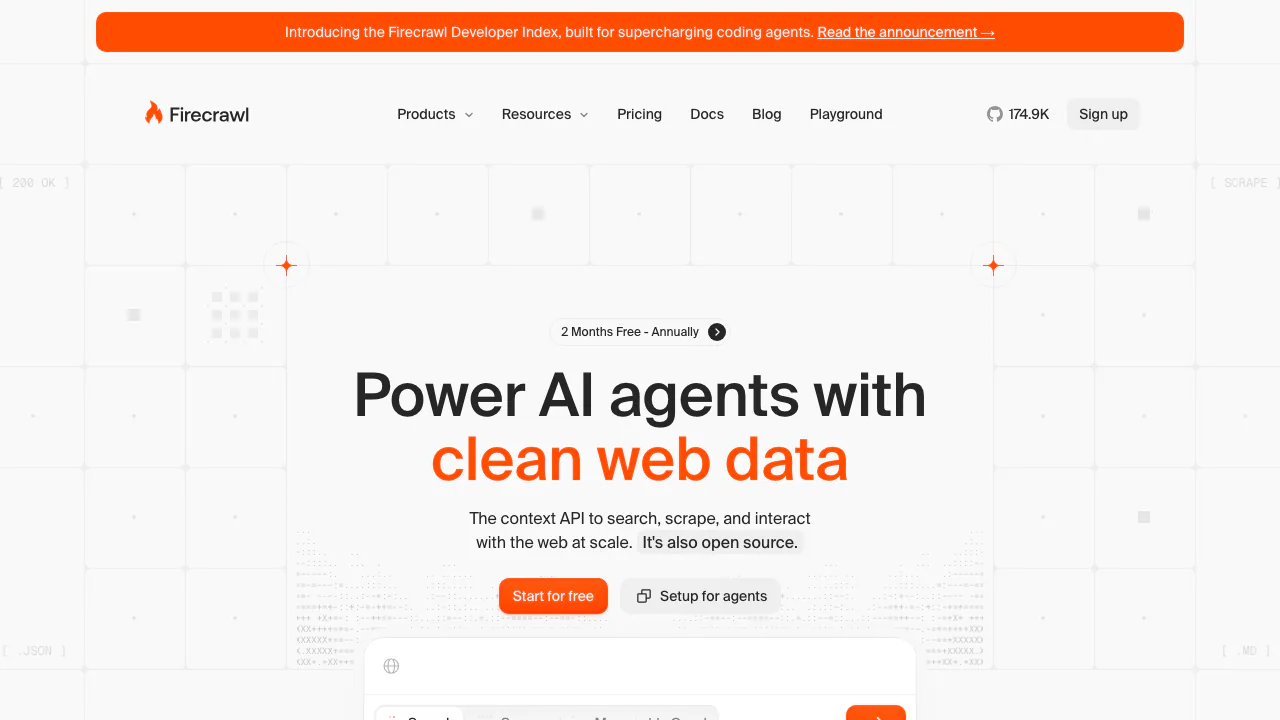
Firecrawl 是面向开发者的网页数据 API,适合为 AI 智能体、RAG 知识库和自动化流程补充较新的网页内容。它可搜索网页、抓取单页、遍历站点、发现 URL,并返回清洗后的 Markdown、链接、截图或结构化 JSON。
如何选择 Firecrawl 接口
已知目标 URL 时用 scrape;需要跟随站内链接时用 crawl;想先查看站点有哪些页面时用 map。Search 负责找来源,浏览器交互则处理必须点击、填写表单或滚动后才出现的数据。官方提取器指南说明了范围与积分差异。
建议先拿一张典型页面试跑,只请求应用实际需要的格式,并检查字段、链接和来源 URL;随后再设置页面数、深度和并发。网页文本可能夹带误导指令,进入智能体前应视为不可信输入,重要事实仍要回到原始页面核验。
积分、隐私与合规边界
Firecrawl 提供每月免费积分,付费方案增加额度、并发和支持。不同接口及高级选项消耗不同,正式上线前应查看实时价格表,不要沿用旧报价。
抓取权限、版权、个人信息和目标网站条款仍由使用者负责。处理敏感或受监管数据前,请阅读隐私政策,并确认企业数据留存选项。
Firecrawl 能抓取 JavaScript 网页吗?
它可处理许多动态渲染页面,但登录、反爬机制和复杂交互无法保证,必须在真实目标上测试。
Firecrawl 免费吗?
有按月限制积分的免费层级。当前额度与各接口成本以官方价格页为准。

AIsa付费
用一把 API Key,为智能体接入模型、联网研究和外部数据。
LLM Gateway免费+付费
统一接入多家大模型,管理路由、密钥与调用成本
Experiential Labs免费+付费
通过统一 API 连接多家 AI 模型,集中管理路由、预算与调用记录。
通过一个 OpenAI 兼容 API 调用多家模型,并以可验证隐私控制完成路由。
OpenRouter免费+付费
聚合 500+ 前沿大模型的统一 AI API 路由网关