

Tavily部分免費
透過一套 API 為 AI 代理搜尋、擷取、爬取和研究即時網頁
Firecrawl 網頁擷取 API:功能、價格與使用限制
將網頁轉成適合 AI 代理、RAG 與自動化使用的乾淨 Markdown 或結構化資料。
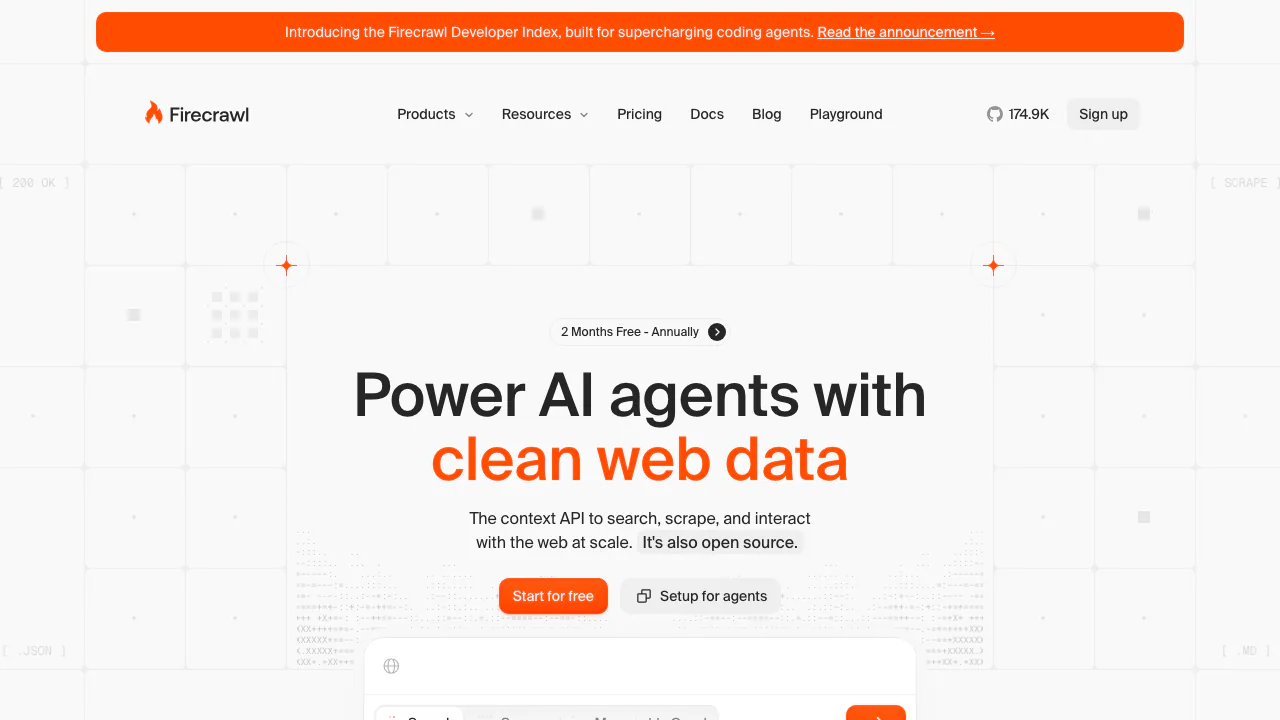
Firecrawl 是給開發者使用的網頁資料 API,適合替 AI 代理、RAG 知識庫與自動化流程補充較新的網站內容。它能搜尋網頁、擷取單頁、巡覽網站、發現 URL,並回傳整理過的 Markdown、連結、截圖或結構化 JSON。
如何選擇 Firecrawl 端點
已知目標 URL 時用 scrape;需要沿著站內連結處理多頁時用 crawl;想先盤點頁面時用 map。Search 負責尋找來源,瀏覽器互動則處理必須點擊、填表或捲動後才出現的資料。官方擷取器指南說明範圍與點數差異。
先以代表性頁面測試,只要求應用真正需要的格式,再檢查欄位、連結與來源 URL;之後才設定頁數、深度與並行限制。網頁文字可能帶有誤導指令,傳給代理前應視為不可信輸入,重要資訊仍須回到原始頁面確認。
點數、隱私與合規界線
Firecrawl 有每月免費點數,付費方案提高額度、並行量與支援。不同端點及進階選項用量不同,上線前請查看即時價格表。
擷取權限、著作權、個人資料與目標網站條款仍由使用者負責。處理敏感或受監管資料前,應閱讀隱私權政策,並確認企業資料保留選項。
Firecrawl 能擷取 JavaScript 網站嗎?
它能處理許多動態渲染頁面,但登入、反機器人與複雜互動仍須在實際目標測試。
Firecrawl 免費嗎?
有每月點數上限的免費方案;目前額度與各端點成本以官方價格頁為準。

AIsa付費
用一組 API Key,替 AI 代理串接模型、搜尋與外部資料。
LLM Gateway部分免費
統一串接多家模型,管理路由、金鑰與呼叫成本
以統一 API 串接多家模型,集中管理金鑰、請求路由與使用成本。
以一個 OpenAI 相容 API 連接多家模型,並用可驗證的隱私條件控制路由。
OpenRouter部分免費
聚合 500+ 前沿大模型的統一 AI API 路由閘道