
NavigeFreemium
Observer les dépenses, puis activer les contrôles adaptés aux appels de vos agents.
Llama : une IA locale pour discuter et connecter ses apps
Faites tourner des modèles ouverts sur votre ordinateur et utilisez-les dans vos applications.
À quoi sert Llama.app, simplement ?
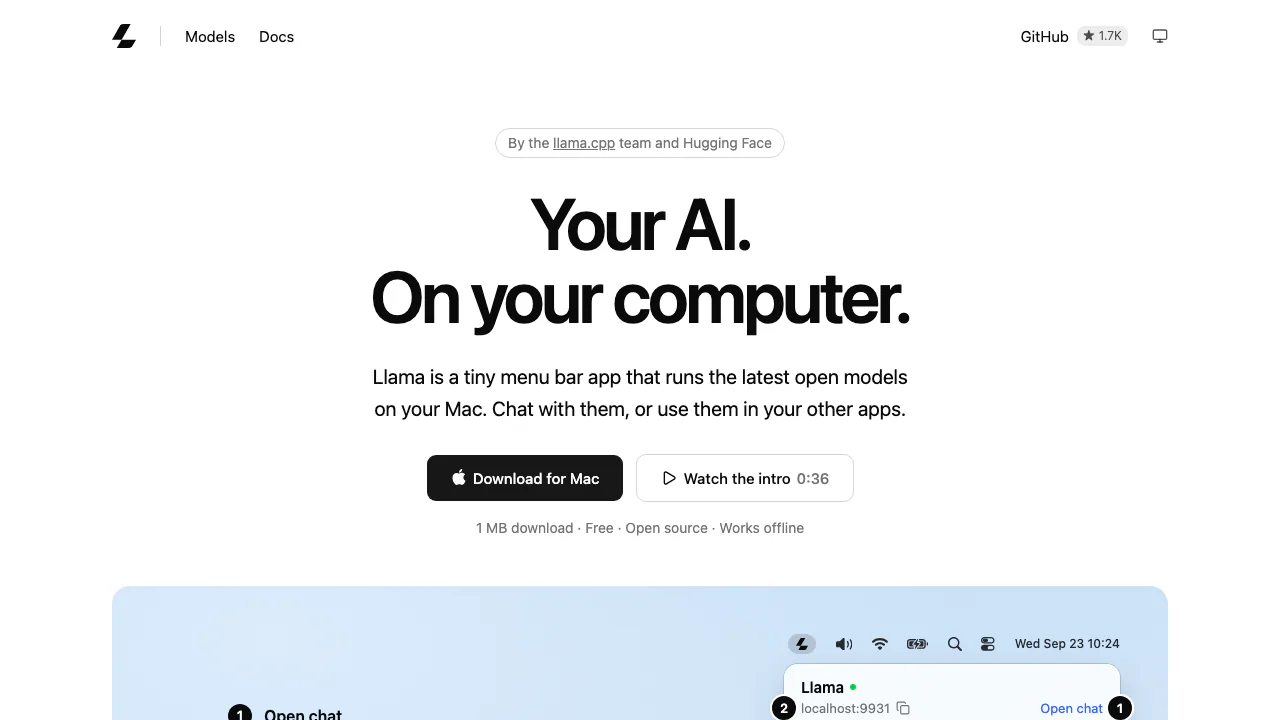
Llama.app permet de télécharger Llama, une application gratuite et open source qui exécute des modèles de langage sur votre ordinateur. Une fois le modèle installé, vous pouvez discuter dans une interface web ou le rendre accessible à vos autres applications par une API locale. Le site présente le projet comme celui de l'équipe llama.cpp et de Hugging Face.
L'intérêt est de disposer d'un moteur local commun pour la rédaction, l'analyse et les outils de développement. Les possibilités dépendent du modèle choisi : l'application organise son exécution, elle ne donne pas les mêmes aptitudes à tous les modèles.
Gratuité, confidentialité et limites pratiques
Vérification du 27 octobre 2026 : l'application est proposée gratuitement, sans facturation annoncée au token pour son API locale. Le stockage, la mémoire et l'électricité restent à votre charge. La licence MIT du logiciel ne remplace pas les conditions propres aux modèles téléchargés.
L'inférence locale fonctionne hors ligne lorsque les éléments nécessaires sont déjà présents. Les téléchargements, mises à jour et outils externes peuvent utiliser internet. Le dépôt Windows déclare ne pas envoyer de télémétrie. Le serveur est limité à l'ordinateur par défaut ; une ouverture au réseau modifie cette situation. La confidentialité d'un client ou d'un agent connecté doit également être examinée.
Installer une IA locale et lancer une première discussion
Téléchargez l'application Mac ou Windows 11 et ouvrez-la. Sur Mac, brew install --cask llama-app constitue une autre possibilité.
Depuis l'icône de la barre des menus ou de la zone de notification, téléchargez un modèle recommandé avec la flèche prévue. Sélectionnez ensuite ce modèle, choisissez une fenêtre de contexte adaptée à la mémoire et ouvrez la discussion. Envoyez une courte demande avant de passer à votre tâche réelle.
Le démarrage rapide officiel détaille ces étapes. Pour Linux, le site propose l'installation en ligne de commande.
Choisir un modèle adapté à sa mémoire
Le modèle et le contexte de conversation occupent tous deux de la mémoire. Un contexte plus long augmente les besoins ; la taille du téléchargement ne suffit donc pas à prévoir les performances.
Llama recommande des modèles selon la machine et règle automatiquement leurs paramètres. Consultez les indications du catalogue des modèles pour le modèle précis envisagé. Il n'existe pas de seuil unique valable pour tous.
Les poids sont conservés dans le cache Hugging Face partagé avec d'autres outils. Les modèles sont déchargés lorsqu'ils restent inactifs. Le petit téléchargement de l'application Mac ne comprend pas ces poids.
Travailler avec des fichiers et retrouver ses échanges
L'interface accepte les images et PDF avec les modèles de vision, ainsi que les MP3/WAV avec les modèles audio compatibles. Joignez un fichier pris en charge, demandez une extraction ou un résumé précis, puis contrôlez la réponse dans l'original.
La recherche de conversations, les branches de discussion et l'import/export JSON facilitent le suivi d'un travail. Un modèle purement textuel ne peut pas interpréter une image simplement parce que l'interface accepte des pièces jointes pour d'autres modèles.
Brancher ses applications sur une API locale
Un client compatible peut utiliser http://localhost:9931/v1. Récupérez l'identifiant effectif du modèle avec GET /v1/models, puis renseignez-le dans le client.
La documentation API décrit le streaming, les sorties structurées, les appels d'outils et un endpoint Messages compatible Anthropic. Dans un montage avec agent, Llama fournit le modèle ; le programme agent gère les actions et les outils. Évaluez cette combinaison sur vos tâches.
Questions fréquentes
Llama nécessite-t-il un abonnement ?
L'application est actuellement gratuite. Un service tiers connecté peut avoir sa propre tarification.
Peut-on discuter sans connexion ?
Oui, pour l'inférence locale après téléchargement. Cela ne rend pas les outils en ligne utilisables hors connexion.
Quelle mémoire faut-il prévoir ?
Cela dépend du modèle et du contexte. Les recommandations de la machine constituent le point de départ.
Un modèle local garantit-il la confidentialité de l'agent ?
Non. Il faut aussi vérifier les outils, le client et les accès réseau utilisés autour du modèle.
Ressources officielles et communauté
- Guide de l'interface web : pièces jointes et conversations.
- Guide des agents : raccordement des clients.
- Dépôt Mac et dépôt Windows : code, versions et signalement de problèmes.
Outils similaires
API et infrastructure de modèles IA →
EdgeeFreemium
Pilotez les modèles, compressez les tokens et suivez le coût de vos agents.
Together AIPayant
Appelez des modèles par API, adaptez-les à vos données et choisissez les ressources adaptées à votre application.
JevModelFreemium
Transformez du texte ou du JSON en catégories, scores et probabilités.
ReflectionGratuit
Intégrez Beam par API, développez avec Mirror ou hébergez le modèle.
shimFreemium
Masquez les données sensibles avant l'appel au modèle et suivez les dépenses.