

AIsa유료
하나의 API 키로 모델과 외부 데이터를 에이전트에 연결하세요.
Tavily 웹 검색 API 리뷰
AI 에이전트가 최신 웹을 검색·추출·크롤링·조사하도록 지원하는 단일 API
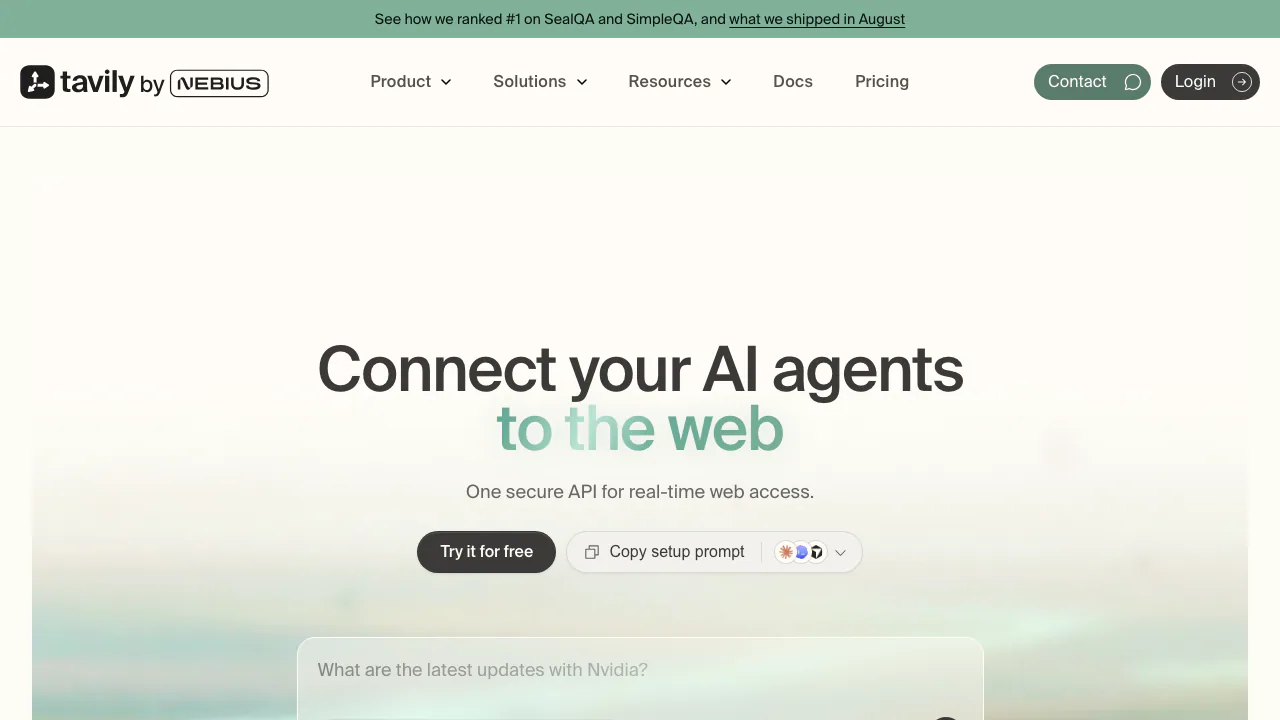
Tavily는 AI 에이전트와 검색 증강 생성을 위한 웹 데이터 API입니다. 검색, 페이지 추출, 사이트 구조 매핑과 크롤링, 긴 조사 작업용 엔드포인트를 제공합니다. 결과에는 제목, 출처 URL, 관련 본문, 점수와 선택적 생성 답변이 포함될 수 있습니다. 웹페이지를 찾고 해석하는 자체 인프라를 줄여 주지만 인터넷 내용을 검증된 사실로 바꾸지는 않습니다.
출처를 보존하는 검색 테스트를 만드세요
제품의 실제 질문 열 개를 고르세요. 모호한 표현, 최신 사건, 전문적 사실, 전제가 틀린 질문을 포함합니다. 검색 깊이, 주제, 기간, 언어와 도메인 필터를 의도적으로 설정하세요. 검색, 재정렬, 답변 생성 전 과정에서 각 발췌문에 원본 URL을 유지합니다. 유용한 결과는 문장만 자연스러운 것이 아닙니다. 검토자가 링크를 열고 근거 문단, 날짜와 발행 주체를 확인할 수 있어야 합니다.
공개 웹 발견에는 Search, 알려진 URL에는 Extract, 사이트 구조에는 Map, 범위가 정해진 다중 페이지 수집에는 Crawl을 사용하세요. 더 높은 변동 비용을 감수할 가치가 있는 작업에만 Research를 적용합니다. 요청 ID와 필요할 때 프로젝트 ID를 기록하고 캐시 기간, 타임아웃, 지출 상한, 429 및 서버 오류에 대한 백오프 재시도를 정하세요. API 키를 브라우저 코드나 모바일 바이너리에 넣지 말고 서버에서 호출하며 유출된 키는 즉시 교체합니다.
검색된 모든 페이지를 신뢰할 수 없는 입력으로 취급하세요. 프롬프트 주입, 복사된 오류, 악성 마크업이나 오래된 정보가 들어 있을 수 있습니다. 검색 본문을 시스템 지시와 분리하고 불필요한 태그를 제거하며 컨텍스트와 에이전트 도구를 제한하고 중요한 주장에는 출처를 요구하세요. 도메인 필터는 집중도를 높이지만 출처 편향도 만듭니다. 고정 벤치마크에서 관련성, 인용 범위, 최신성, 지연, 실패와 크레딧을 측정합니다.
크레딧과 검색 개인정보
Tavily는 크레딧을 사용합니다. 현재 크레딧 안내는 매월 무료 할당량, 유료 요금제와 사용량 결제를 설명합니다. Basic과 Advanced Search 비용이 다르고 Extract는 성공 URL과 깊이, Crawl은 매핑과 추출의 합, Research는 가변 한도입니다. 실제 엔드포인트 조합으로 월 비용을 예측하세요.
개인정보 처리방침에 따르면 Tavily는 검색 데이터와 업로드 문서를 수집하고 계약에 달리 정하지 않으면 일부 검색을 미래 응답 개선에 사용할 수 있으며 제한된 경우 외부 검색 인덱스 제공자에게 전달할 수 있습니다. 개인정보, 비밀, 고객 기록이나 내부 식별자를 검색에 넣지 마세요. 규제 대상 작업은 보관, 처리 지역과 삭제를 계약에서 확인해야 합니다.
Tavily는 무료인가요?
카드 없이 제한된 월간 무료 크레딧을 사용할 수 있습니다. 할당량과 비용은 변하므로 실시간 안내를 확인하세요.
Tavily가 정확성을 보장하나요?
아닙니다. 출처를 찾고 정렬하며 선택 답변이 요약할 뿐입니다. 애플리케이션에서 원문 확인, 인용과 충돌 처리가 필요합니다.
비슷한 도구
AI 모델 API 및 인프라 →
Firecrawl부분 무료
웹사이트를 AI 에이전트와 RAG용 정리된 Markdown 또는 구조화 데이터로 변환합니다.
LLM Gateway부분 무료
여러 모델의 API 연결, 요청 라우팅과 비용 분석
Experiential Labs부분 무료
하나의 API로 모델을 연결하고 키, 경로, 사용 비용을 관리합니다.
검증 가능한 개인정보 보호 조건으로 여러 모델을 연결하는 OpenAI 호환 AI API 게이트웨이입니다.
OpenRouter부분 무료
500개 이상의 선도적 AI 모델을 위한 통합 API 게이트웨이