브라우저 작업을 말로 지시하고 표와 실행 결과를 확인하세요.
Context.dev: AI 에이전트용 웹 스크래핑 API
페이지 수집, 사이트 크롤링, 검색과 변경 감지를 하나의 API로 AI 에이전트에 연결합니다.
쉽게 설명하면 Context.dev는 무엇을 하는 서비스인가요?
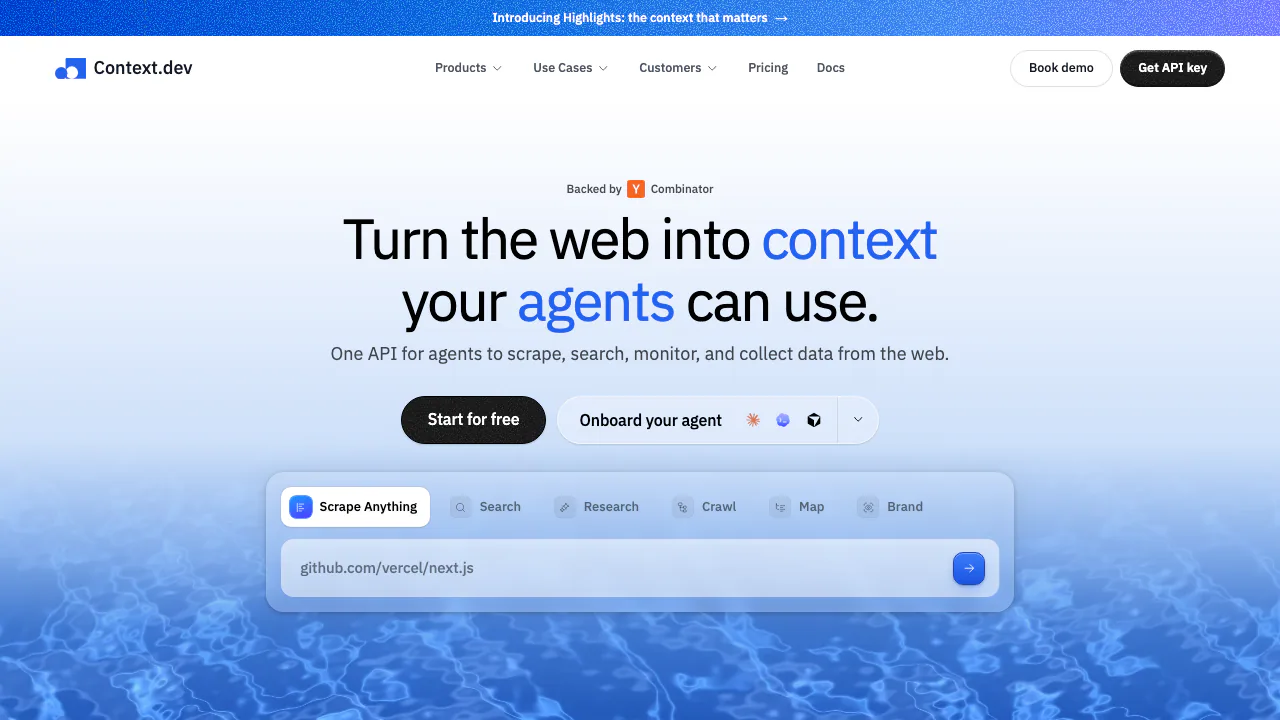
Context.dev는 프로그램이 웹사이트 자료를 가져오도록 돕는 웹 스크래핑 API입니다. 앱에서 주소를 보내면 마크다운, 렌더링한 HTML, 스크린샷 또는 지정한 데이터 필드를 받습니다. 브라우저와 프록시 운영은 서비스가 처리합니다. 마크다운은 제목과 목록 같은 구조를 남기는 텍스트 형식으로, AI가 읽을 자료를 준비할 때 유용합니다.
운영사는 Context Dev Inc.이며 AI 에이전트, 리서치 도구, RAG 데이터 수집을 구현하는 개발자에게 적합합니다. RAG는 답변 전에 관련 자료를 검색하는 방식입니다. 수집한 내용을 저장하고 색인하고 사용자에게 보여 주는 작업은 자신의 앱에서 구성해야 합니다.
필요한 결과에 맞춰 수집 방법 고르기
주소를 알고 있다면 Scrape로 페이지를 읽습니다. 본문에는 마크다운, 구조 확인에는 HTML, 시각 기록에는 스크린샷을 선택할 수 있고 JSON Schema에 맞는 필드 추출도 가능합니다. 한 요청에 여러 출력을 지정할 수 있지만 각각의 성공 여부를 확인해야 합니다. 자바스크립트 렌더링과 프록시는 기본 가격에 포함됩니다.
문서 사이트를 수집한다면 Map으로 URL을 발견한 뒤 필요한 경로를 선택하세요. Crawl은 링크를 따라가며 호출당 최대 500페이지의 마크다운을 반환하고 페이지 수, 깊이와 경로를 제한할 수 있습니다. 더 큰 작업은 비동기 Batches로 실행하고 폴링 또는 webhook으로 결과를 가져옵니다.
먼저 대표 페이지 몇 개에서 본문과 코드가 제대로 들어왔는지 살펴보고 출처 URL을 보존한 뒤 자체 RAG 색인으로 넘기세요. Scrape는 기본적으로 최대 3일 된 캐시를 사용할 수 있습니다. 새로 수집하려면 maxAgeMs: 0을 설정합니다.
검색과 조사 결과, 지속적인 변경 감지
Search는 검색어를 받아 관련 URL과 제목, 설명을 순서대로 반환하며 마크다운도 포함할 수 있습니다. Answers는 조사 작업과 예시 JSON 객체를 받아 출처 URL이 있는 구조화된 결과를 만듭니다. 중요한 사실은 원문에서 다시 확인하는 것이 필요합니다.
Monitors는 먼저 기준 상태를 만들고 일정에 따라 페이지, 사이트맵 또는 선택한 내용을 비교합니다. 텍스트 차이나 지침에 관련된 변화를 감지할 수 있습니다. 기준 실행이 완료됐는지 확인하고 webhook 서명을 검증하며 실패 실행도 살펴보세요. 첫 기준 수집은 변경 알림을 보내지 않습니다.
Brand는 도메인으로 회사 정보, 로고와 색상을 가져옵니다. Styleguide는 글꼴, 간격, 컴포넌트 스타일을 추출하므로 제품 온보딩과 브랜드 맞춤 화면에 활용할 수 있습니다.
첫 API 요청과 MCP 연결 절차
- 계정을 만들고 비밀 API 키를 서버에 보관합니다.
- 공식 시작 안내에서 cURL 또는 TypeScript, Python, Ruby, Go, PHP SDK를 선택합니다.
- Bearer 인증과 함께
https://api.context.dev/v1/web/scrape에 POST합니다. 본문에url과formats: { "markdown": true }을 넣고, 필요하면sharedParams.mainContentOnly를 설정합니다. markdown.success를 확인한 다음markdown.data를 사용합니다. HTTP 200이어도 개별 출력이 실패할 수 있습니다.- 실제 샘플을 검토한 뒤 수집 범위를 늘립니다.
호환 클라이언트는 MCP 설정 문서에 따라 https://mcp.context.dev/mcp에 OAuth로 연결합니다. 호출은 연결된 조직의 API 크레딧을 사용합니다.
무료 크레딧과 요금 계산
2026년 10월 15일 확인 기준 Free는 카드 없이 매월 1,000 API 크레딧을 제공합니다. 공개된 미국 달러 월 결제 가격은 Developer 19달러, Pro 99달러, Growth 299달러, Scale 499달러입니다. 월 크레딧은 각각 7,500, 125,000, 500,000, 1,000,000이며 Enterprise는 별도 견적입니다. 연간 결제와 구매 조건은 현재 요금표를 확인하세요. 원화 가격은 아닙니다.
일반 Scrape는 1크레딧부터 시작하고 브라우저 작업이 있으면 기본 2크레딧입니다. 성공한 JSON 추출에는 4크레딧이 추가됩니다. Logo Link는 별도 할당량으로 Free에 일회성 10,000요청이 있습니다. 부분 성공과 대상 페이지 404도 청구될 수 있습니다. Auto-Topup을 켜면 유료 블록이 추가될 수 있고 지출 알림은 강제 한도가 아닙니다. 실제 동시 실행과 속도 제한은 계정 대시보드에서 확인하세요.
데이터 보관과 재사용 권한
개인정보 처리방침은 적용되는 계약과 제한 아래 질의와 결과를 서비스 개선 및 모델 학습에 사용하는 것을 허용합니다. 일반 요청이 자동으로 무보관 처리되는 것은 아닙니다.
ZDR 문서에 따르면 조직 권한을 먼저 활성화하고 지원 요청마다 명시적으로 설정한 뒤 X-Context-ZDR: true를 확인해야 합니다. Batches, Monitors, Brand retrieval은 이 모드를 지원하지 않으며 ZDR에서는 PDF OCR이 생략됩니다. 자체 앱의 로그와 저장소도 관리해야 합니다. API 접근은 타사 페이지와 로고의 재배포 권리를 제공하지 않습니다.
자주 묻는 질문
결과가 비어 있으면 어떻게 확인하나요?
HTTP 상태만 보지 말고 각 출력의 success, 오류 코드와 데이터를 확인하세요. 여러 출력 중 일부만 성공할 수 있습니다.
마크다운과 JSON 중 무엇을 선택하나요?
읽을 본문이 필요하면 마크다운, 정해진 필드가 필요하면 스키마 기반 JSON 추출을 검토하세요. 중요한 필드는 추가 확인이 필요합니다.
무료로 시작할 수 있나요?
Free에 매월 1,000 API 크레딧이 있습니다. JSON 추출 등은 추가 크레딧을 쓰므로 처리 페이지 수는 달라집니다.
전체 문서 사이트도 수집할 수 있나요?
Crawl은 호출당 최대 500페이지를 처리합니다. 더 큰 사이트는 Batches로 비동기 수집하세요.