

AIsa付费
用一把 API Key,为智能体接入模型、联网研究和外部数据。
Tavily AI 网页搜索 API 评测
通过一套 API 为 AI 智能体搜索、提取、爬取和研究实时网页
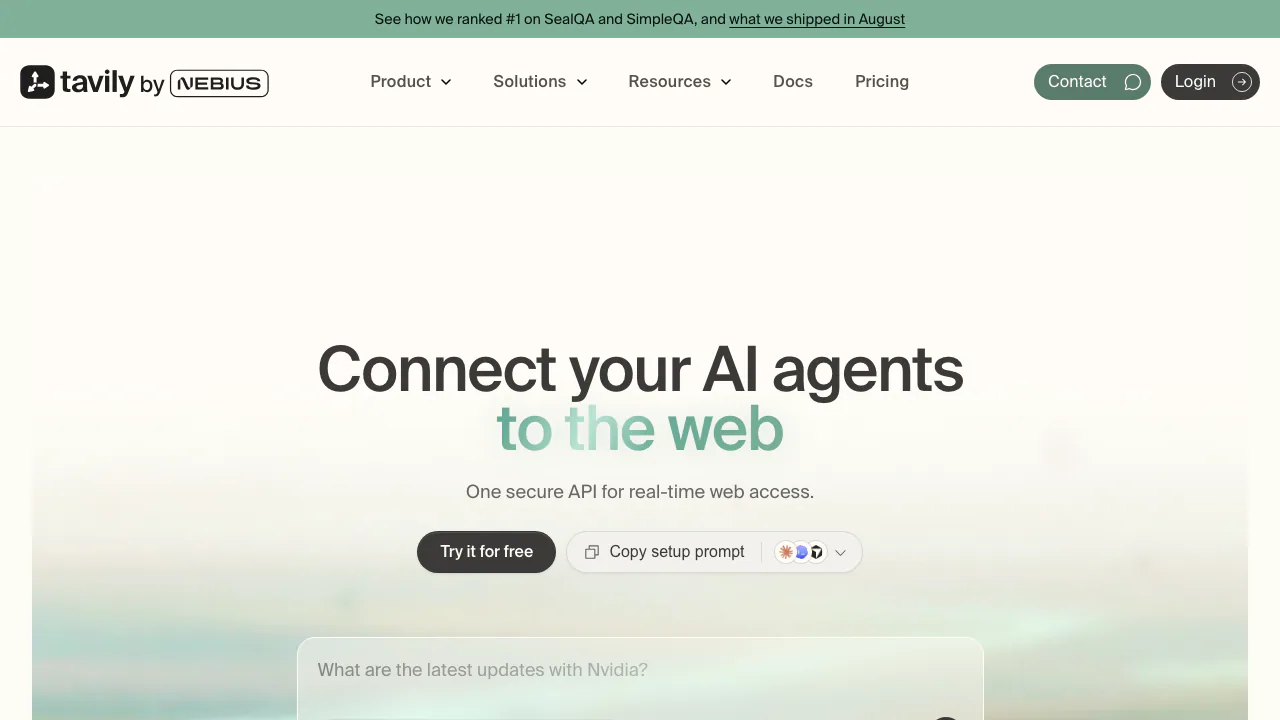
Tavily 是一套面向 AI 智能体和检索增强生成的网页数据 API。它提供搜索、页面提取、站点结构映射、爬取以及较长的研究任务。搜索结果可以包含标题、来源网址、相关正文、评分和可选的生成答案,能减少自行维护搜索与解析基础设施的工作。但它只是检索并排序网页内容,不会把互联网上的说法自动变成经过验证的事实。
建立保留来源链路的检索测试
从真实产品中选十个问题,包括含糊表述、刚发生的事件、冷门事实,以及一个前提本身错误的问题。根据任务明确选择搜索深度、主题、时间范围、语言和域名过滤条件。每段正文在检索、重排和生成答案的全过程都要携带原始 URL。好结果不只是读起来流畅;审核者还必须能打开来源、找到支持段落,并判断发布日期和权威性。
开放网页发现可用 Search,已知网址用 Extract,了解站点结构用 Map,收集限定范围内的多页内容用 Crawl;只有任务价值足以覆盖更高且浮动的成本时才用 Research。日志应保留请求 ID,必要时加入项目 ID。请设置缓存期限、超时、消费上限,并对 429 与服务器错误做退避重试。不要把 API 密钥放进浏览器代码或移动端安装包,应从服务端调用,并立即轮换泄露的密钥。
所有检索网页都应当作不可信输入。页面可能含有提示注入、转抄的错误结论、恶意标记或过期信息。把检索文本与系统指令隔离,清理不必要的标记,限制上下文长度和智能体可调用的工具,对重要结论强制保留引用。域名过滤能提高聚焦度,也可能造成来源偏差。上线前用固定测试集衡量相关性、引用覆盖、时效、延迟、失败率和额度消耗。
额度与查询隐私
Tavily 按 API 额度计费。当前额度说明列出每月免费额度、订阅和按量付费。Basic 与 Advanced Search 成本不同;Extract 取决于成功网址数和深度;Crawl 叠加映射与提取;Research 有浮动的最低和最高消耗。应按真实端点组合估算月成本,而不是只用套餐价除以请求数。
隐私政策说明 Tavily 会收集查询数据和上传文档;除非合同另有约定,部分查询数据可用于改进未来响应;在自有索引无法满足查询的有限情况下,还可能把查询交给第三方搜索索引提供商。不要在查询中放入个人信息、密钥、客户记录或内部标识。受监管场景应在合同中确认保留期限、处理地区和删除要求。
Tavily 可以免费试用吗?
可以,无需信用卡即可获得有限的每月免费额度。额度和端点成本会变化,请以实时说明为准。
Tavily 能保证答案准确吗?
不能。它负责检索和排序来源,可选答案只是摘要。应用仍需核验原文、保留引用并处理来源冲突。

Firecrawl免费+付费
把网页转成适合 AI 智能体、RAG 与自动化使用的干净 Markdown 或结构化数据。
LLM Gateway免费+付费
统一接入多家大模型,管理路由、密钥与调用成本
Experiential Labs免费+付费
通过统一 API 连接多家 AI 模型,集中管理路由、预算与调用记录。
通过一个 OpenAI 兼容 API 调用多家模型,并以可验证隐私控制完成路由。
OpenRouter免费+付费
聚合 500+ 前沿大模型的统一 AI API 路由网关