
Off Grid AIFreemium
Lokale KI für Gespräche, eigene Unterlagen und optionale Arbeitsgedächtnis-Funktionen
Overmind für Modelltraining und LLM-Fine-Tuning
Eigene Agent-Daten aufbereiten, Modelle trainieren und Ergebnisse prüfen.
Was macht Overmind einfach erklärt?
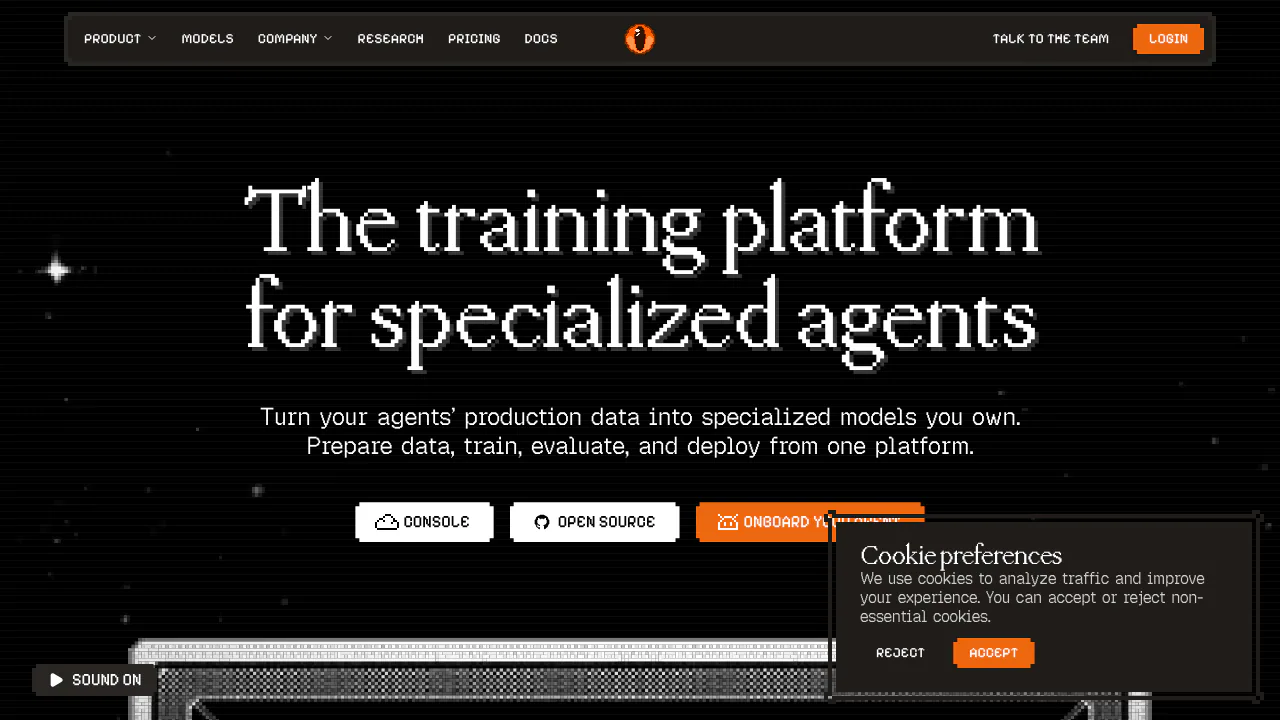
Overmind hilft Entwicklerteams, aus Beispielen ihrer KI-Anwendung ein spezialisiertes Modell zu trainieren. Produktionsbeobachtung, Datenaufbereitung, Fine-Tuning, Evaluation und Bereitstellung bleiben miteinander verbunden. Das ist etwa für Klassifikation, strukturierte Antworten oder Werkzeugaufrufe interessant. Die Plattform richtet sich an Teams, die Agenten oder KI-Anwendungen entwickeln und Verbesserungen anhand eigener Aufgaben nachweisen möchten.
Von einem fehlerhaften Ablauf zum Datensatz
Verknüpfen Sie Fähigkeiten aus dem Repository mit Produktions-Traces. So lassen sich Prompts, Werkzeugaufrufe, Tokenverbrauch, Laufzeit und Kosten untersuchen. Daten kommen über das Python-SDK, OpenTelemetry oder Importe aus Langfuse, LangSmith, Braintrust und Galileo.
Data Workshop nimmt auch Dateien und API-Zeilen an. Der Coding-Agent schreibt Python-Schritte, Overmind führt sie in einer Sandbox aus. Versionierte Zellen dokumentieren Änderungen; nachfolgende Läufe fixieren die verwendete Version. Prüfen Sie Duplikate, abgeschnittene Beispiele, Datenlecks und Aufgabenabdeckung.
Ein erstes Fine-Tuning nachvollziehbar durchführen
Der offizielle Modell-Workshop beschreibt diesen Ablauf:
- Coding-Agent verbinden, Projekt wählen und Beispiele mit gewünschten Antworten bereitstellen.
- Trainings-, Entwicklungs- und unabhängige Testdaten trennen; Bewertungskriterien festlegen.
- Kompatibles Modell, Trainingsmethode und erwartete Rechenkosten prüfen, dann den akzeptierten Lauf starten.
- Fortschritt verfolgen und Basis- sowie trainiertes Modell auf denselben zurückgehaltenen Beispielen vergleichen.
LoRA und vollständiges Fine-Tuning sind modellabhängig. Ein sinkender Trainingsverlust ist kein ausreichender Erfolgsnachweis.
Qualität mit einer unveränderten Vergleichsbasis messen
Evaluationen verbinden Modellbewerter mit deterministischen Prüfungen. Datensatz und Bewerter werden für einen Lauf fixiert. Untersuchen Sie konkrete Fehler und fehlende Antworten neben Mittelwerten; für Klassifikation stehen unter anderem Precision, Recall, F1 und Konfusionsmatrizen bereit. Auch Änderungen an Prompts, Werkzeugen und Code lassen sich testen, bevor Sie sich für weiteres Training entscheiden.
Bereitstellen und Gewichte mitnehmen
Chatmodelle lassen sich über einen OpenAI-kompatiblen Endpunkt nutzen. Eine einsatzbereite Bereitstellung und das Umschalten eines Fähigkeits-Alias sind getrennte Schritte. Prüfen Sie die Anwendung nach der Umstellung. Gewichte und Checkpoints können über Console oder CLI heruntergeladen werden. Native Entscheidungsmodelle verwenden dagegen einen eigenen Vertrag für typisierte Wahrscheinlichkeiten.
Self-Hosting mit klaren Betriebsgrenzen
Docker Compose ermöglicht eine eigene Plattforminstallation. Der aktuell unterstützte Trainingsbackend ist jedoch Modal; lokale Plattformdienste bedeuten keine vollständig lokale GPU-Ausführung. Die Lizenzübersicht unterscheidet AGPL-3.0 für die Plattform, MIT für SDK/CLI und eine kostenpflichtige kommerzielle Alternative.
Laut Datenschutzerklärung können ausgewählte Modell-, Evaluations-, Trainings- und Inferenzanbieter Inhalte verarbeiten. Ein Verbindungswiderruf löscht keine bereits gespeicherten Inhalte.
Tarife und Rechenbudget verstehen
Die Preisseite nennt am 29. Oktober 2026 folgende Dollarpreise:
- Free: $0 pro Monat, ein Sitz pro Projekt, alle Funktionen und einmalig $50 Guthaben.
- Pro: $120 pro Monat mit monatlich $120 Guthaben, unbegrenzten Sitzen und priorisiertem Support.
- Enterprise: individuelle Konditionen.
Training, Inferenz, Evaluation und Optimierung verbrauchen Guthaben. Traces, Datenaufbereitung sowie Console-, CLI- und MCP-Zugriff nicht. Ein Credit entspricht $0.01; ungenutztes Guthaben verfällt laut Preisseite nicht. Berücksichtigen Sie zusätzlich den laufenden Modellbetrieb.
Häufige Fragen
Kann ich mit eigenen Dateien statt Produktions-Traces starten?
Ja. Data Workshop unterstützt Dateien und API-Zeilen. Die Beispiele müssen zur Aufgabe und zum gewählten Modell passen; Produktions-Traces sind nicht die einzige Datenquelle.
Ist das Training im Free-Tarif unbegrenzt?
Nein. Alle Funktionen sind enthalten, Rechenläufe benötigen aber Guthaben. Das kostenlose Startguthaben wird einmal gewährt und ersetzt kein unbegrenztes Trainingsbudget.
Bedeutet Self-Hosting vollständig lokales Training?
Nein. Die eigene Installation benötigt konfigurierte externe Dienste und nutzt aktuell Modal für Training. Heruntergeladene Gewichte können anschließend anderswo betrieben werden.
Offizielle Anleitungen und Unterstützung
- Coding-Agent verbinden: Verbindung und Projekt prüfen.
- GitHub-Repository: Quellcode und Issues.
- Offizieller Discord: Community-Support.
- Team kontaktieren: technische Fragen und Unternehmenseinsatz.
Ähnliche Tools
KI-Modelltraining & Fine-Tuning →
PaddockKostenlos
Eigene Linux-Rechner für Coding-Agenten mit Desktop, Docker und Snapshots.
ContextGemKostenlos
Strukturierte Dokumentdaten mit Python extrahieren und Ergebnisse an ihren Quellen prüfen.
tabshKostenlos
Lokale Terminals und Agenten mit einer gemeinsamen Aufgabenübersicht
TelegramFreemium
Nachrichten, Communities und Bots auf Smartphone, Computer und im Browser.
NuvioKostenpflichtig
Nuvio: KI für Buchhaltung und Unternehmensfinanzen