
OvermindFreemium
Eigene Agent-Daten aufbereiten, Modelle trainieren und Ergebnisse prüfen.
ContextGem: strukturierte Daten aus Dokumenten extrahieren
Strukturierte Dokumentdaten mit Python extrahieren und Ergebnisse an ihren Quellen prüfen.
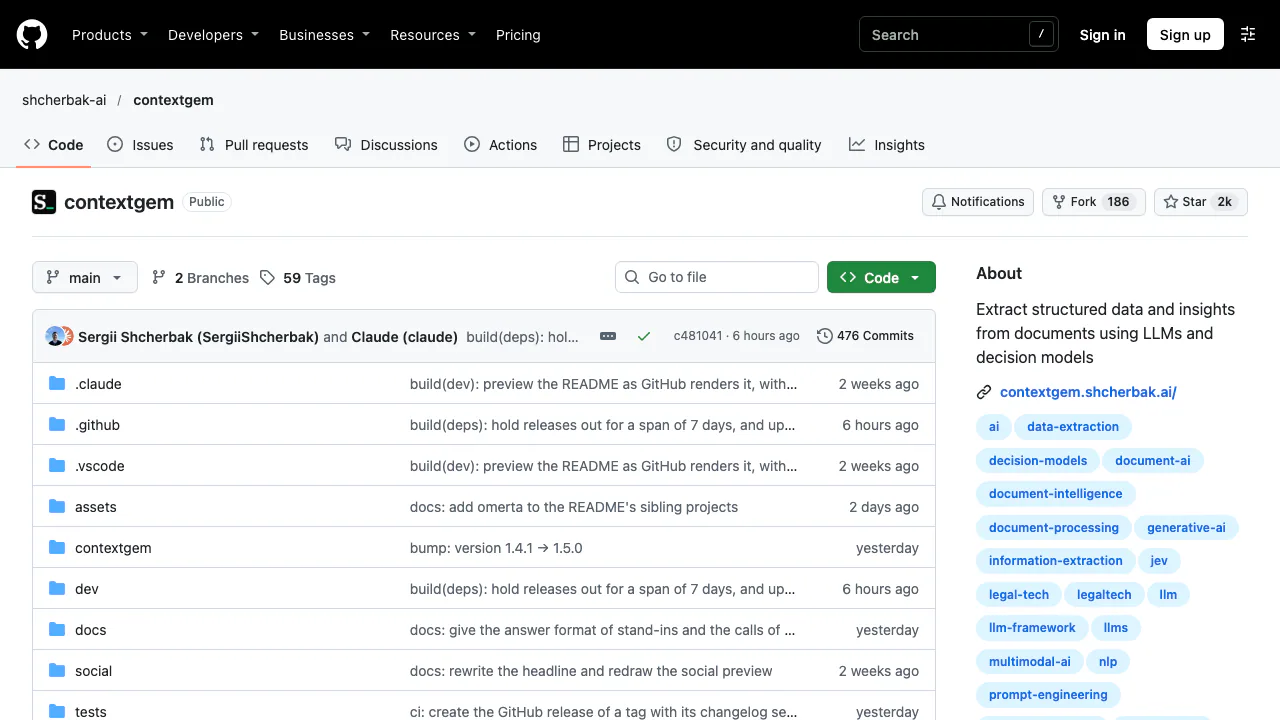
ContextGem ist ein kostenloses, quelloffenes Python-Framework von Shcherbak AI AS. Es extrahiert strukturierte Informationen aus Dokumenten mit LLMs und Entscheidungsmodellen. Entwickler beschreiben die gewünschten Inhalte; das Framework übernimmt dazugehörige Prompts, Datenmodelle und die Prüfung des Ausgabeformats.
Einfach erklärt: Wofür ist ContextGem da?
Stellen Sie sich Verträge vor, aus denen Zahlungsfristen, Kündigungsbedingungen und monatliche Gebühren übernommen werden sollen. Mit ContextGem definieren Sie diese Anforderungen einmal und verarbeiten Dokumente nach denselben Regeln. Statt nur einer Zusammenfassung erhalten Sie Werte, die eine Anwendung weiterverwenden kann.
Das Projekt ist ein Werkzeugkasten für Python-Anwendungen. Es richtet sich an Entwickler und Datenteams, die Dokumente nachvollziehbar auswerten möchten. Eine eigene Benutzeroberfläche, die Speicherung und die fachliche Freigabe gehören weiterhin zur jeweiligen Anwendung.
Einen ersten Extraktionsablauf aufbauen
Beginnen Sie mit einem kurzen Dokument und bekannten Sollwerten. So lässt sich feststellen, ob die Eingabe korrekt aufbereitet wurde und das gewählte Modell die Aufgabe erfüllt.
- Installieren Sie
pip install -U contextgem. Für Dateikonvertierung verwenden Siepip install -U "contextgem[docling]". - Übergeben Sie Text an
Document(raw_text=...). Dateien konvertieren Sie mit DoclingsDocumentConverter().convert(file); daraus entsteht mitDocument.from_docling(result.document)das Dokument. - Beschreiben Sie Themen und Felder als Aspects und Concepts. Wählen Sie passende Datentypen und aktivieren Sie benötigte Quellenreferenzen.
- Konfigurieren Sie
DocumentLLMmit Modell und Zugangsdaten oder lokalem Endpunkt. - Führen Sie
doc = llm.extract_all(doc)aus. Lesen Sieget_concept_by_name(...).extracted_itemsam zurückgegebenen Dokument aus und vergleichen Sie Werte und Belege. - Prüfen Sie fehlende Angaben und unterschiedliche Layouts, bevor Sie den Ablauf auf viele Dateien anwenden.
Der offizielle Schnellstart liefert vollständige Beispiele. Die Docling-Anbindung behandelt unter anderem PDF, DOCX, PPTX, XLSX und HTML sowie Dokumentstruktur und verfügbare Seitenreferenzen. Fehler bei der Konvertierung können die Extraktion beeinflussen.
Themenpassagen, Felder und Quellenbelege
Ein Aspect findet Originalpassagen zu einem Thema, etwa Zahlungsbedingungen. Ein Concept liefert einen Wert oder eine Bewertung, beispielsweise eine Frist oder ein Gebührenobjekt. Concepts können sich auf das gesamte Dokument oder einen Aspect beziehen; Unterthemen erlauben eine feinere Gliederung.
Zur Verfügung stehen Text, Zahlen, Datumswerte, Wahrheitswerte, Labels, Bewertungen und JSON-Objekte. Bei LLM-Extraktionen lassen sich Absatz- oder Satzreferenzen und bei Bedarf Begründungen anfordern. Damit können Prüfer zur Quelle zurückkehren. Ein formal gültiges Ergebnis mit Beleg ist dennoch keine Garantie für eine fachlich richtige Interpretation.
Lizenz, Modellkosten und Datenverarbeitung
Stand 29. Oktober 2026 ist das Framework unter Apache 2.0 kostenlos verfügbar; kommerzielle Nutzung unterliegt den Lizenzbedingungen. Cloud-APIs und lokale Rechenressourcen verursachen gegebenenfalls eigene Kosten. Es gibt hier keinen pauschalen Preis pro Dokument oder ein modellübergreifendes Freikontingent.
Laut Sicherheitsrichtlinie sammelt ContextGem keine Telemetrie. Dokumente und daraus erzeugte Prompts gehen über die in Ihrer Umgebung laufende LiteLLM-Bibliothek an die konfigurierten Modelle. Bei Cloud-Modellen gelten die jeweiligen Speicher- und Verarbeitungsbedingungen. Bei lokalen Modellen sollten Endpunkte und Cloud-Fallbacks geprüft werden. Abhängigkeiten, Satzsegmentierungsmodelle und Preisdaten können weiterhin öffentliche Downloads auslösen.
Lokale LLMs und Entscheidungsmodelle auswählen
Über LiteLLM unterstützt ContextGem dokumentierte Cloud-Anbieter sowie lokale Backends wie Ollama und LM Studio. LLMs eignen sich für offene Antworten, unterschiedliche Feldtypen und unterstützte Bildeingaben. Kleine Modelle müssen an eigenen Dokumenten auf die Befolgung der Extraktionsanweisungen geprüft werden.
Entscheidungsmodelle bearbeiten geschlossene Fragen mit Wahrheitswerten, Labels oder Bewertungsstufen und wählen Text-Aspects aus. Sie liefern Wahrscheinlichkeiten mit konfigurierbaren Schwellenwerten, erzeugen aber keinen freien Text. Ihre Fähigkeiten entsprechen nicht automatisch denen eines LLM für Bilder oder beliebige JSON-Ausgaben. Modellgruppen verteilen Aufgaben nach Rollen und ermöglichen Fallbacks.
Wiederverwendung und Grenzen bei Dokumentensammlungen
Mit ExtractionPipeline lassen sich Aspects und Concepts wiederverwenden. Dokumente, Pipelines und unterstützte Modellkonfigurationen können serialisiert werden. to_dict() und to_json() erleichtern die Übergabe; Datenbankzugriffe oder Tabellenexporte implementiert die eigene Anwendung.
Die Agent-Beispiele zeigen Metadatenextraktion beim Import, aufrufbare Extraktionswerkzeuge und Entscheidungspunkte. Die Ausgabesprache kann für Textwerte und Begründungen festgelegt werden, während Quellen in der Originalsprache bleiben.
ContextGem analysiert einzelne Dokumente gründlich, bei Bedarf absatzweise in Batches. Es durchsucht nicht selbst einen gesamten Dokumentbestand. Für dokumentübergreifende Suche wird ein zusätzliches Retrieval-System benötigt.
Häufige Fragen
Ist die Nutzung vollständig kostenlos?
Das Framework ist kostenlos. Modell-APIs, Hardware und Betrieb können separat berechnet werden; unbegrenzte kostenlose Inferenz ist damit nicht zugesagt.
Kann ContextGem Daten aus PDFs extrahieren?
Der dokumentierte Weg führt über Docling und Document.from_docling(result.document). Prüfen Sie die konvertierten Inhalte und anschließend die extrahierten Felder.
Sind lokale Modelle für vertrauliche Dokumente möglich?
Unterstützte Backends sind etwa Ollama und LM Studio. Modellqualität, Netzwerkzugriffe und mögliche Cloud-Fallbacks müssen bewusst konfiguriert werden.
Ersetzt es RAG für einen Dokumentbestand?
Es übernimmt die Analyse einzelner Dokumente. Bestandssuche und dokumentübergreifende Abfragen benötigen weitere Komponenten.
Offizielle Ressourcen und Community
- Installationsvoraussetzungen: Python 3.11–3.14, Intel-Mac-Ausnahmen und Alpine/musl-Grenzen.
- Unterstützte Modelle: Cloud- und lokale Backends.
- GitHub Discussions: Fragen zur Umsetzung.
- Fehler und Funktionswünsche: nachvollziehbare Meldungen.
- Migration auf Version 1: Änderungen für ältere Integrationen.
Ähnliche Tools
KI-Produktivitäts- und Dokumententools →
Off Grid AIFreemium
Lokale KI für Gespräche, eigene Unterlagen und optionale Arbeitsgedächtnis-Funktionen
PaddockKostenlos
Eigene Linux-Rechner für Coding-Agenten mit Desktop, Docker und Snapshots.
tabshKostenlos
Lokale Terminals und Agenten mit einer gemeinsamen Aufgabenübersicht
TelegramFreemium
Nachrichten, Communities und Bots auf Smartphone, Computer und im Browser.
OpenStatusFreemium
Website Monitoring und Statusmeldungen mit KI-Unterstützung