
TrustedRouterA pagamento
Gateway compatibile con OpenAI per instradare richieste tra modelli con controlli di privacy verificabili.
Experiential Labs: gateway AI per modelli e API
Accesso ai modelli, instradamento e controllo della spesa attraverso una sola API.
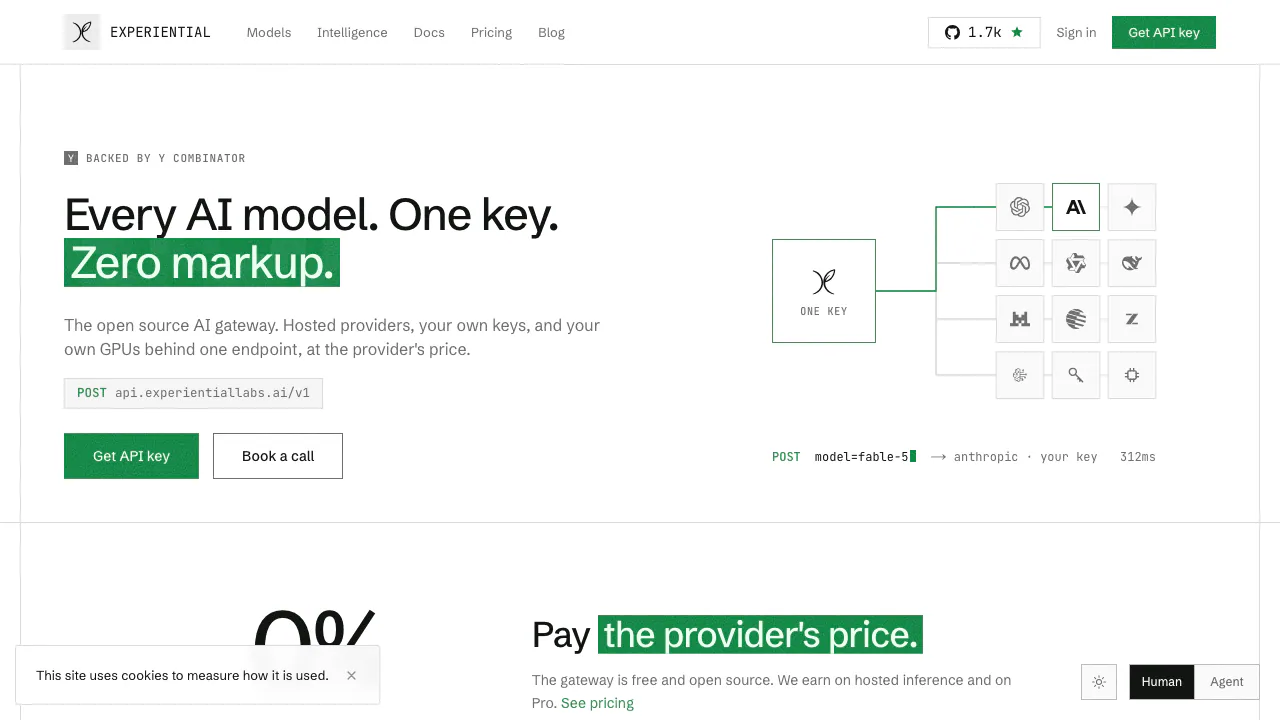
Experiential Labs è un gateway AI open source per chi integra più fornitori di modelli in applicazioni e agenti. Offre un endpoint comune, regole di instradamento, gestione delle chiavi e visibilità sui consumi. È disponibile come piattaforma ospitata e come software da eseguire sulla propria infrastruttura.
In parole semplici: a cosa serve questo sito?
È il punto di accesso a una sorta di centralino per le richieste AI. La tua applicazione indica il modello, il gateway trova un percorso configurato verso un fornitore e restituisce la risposta dopo aver applicato permessi e budget. Puoi così controllare diversi strumenti senza distribuire la gestione dei fornitori in ogni progetto.
Il sito descrive il servizio e rimanda alla piattaforma per catalogo, chiavi e utilizzo. L’operatore dichiarato è Resolute Labs AI, Inc., con il nome Experiential Labs. È adatto soprattutto a sviluppatori di prodotti, agenti e infrastrutture.
Dalla chiave API alla prima risposta
La guida introduttiva ufficiale documenta Chat Completions e Responses compatibili con OpenAI, anche in streaming.
- Accedi e crea una chiave in Settings → API keys. Copia il segreto mentre è visibile: viene mostrato una sola volta.
- Imposta
EXPLABS_API_KEYe l’indirizzo basehttps://api.experientiallabs.ai/v1nel client. - Scegli lo slug di un modello presente nel catalogo corrente e invia una breve richiesta di prova.
- Controlla risposta, percorso, token e costo nella console. Prova
stream: truese l’interfaccia deve mostrare il testo progressivamente.
Formati, contesto e capacità restano specifici del modello. Per OpenAI, Anthropic e Gemini viene verificata anche la regione dell’IP della richiesta. Il catalogo non garantisce l’accessibilità in ogni Paese; BYOK e fallback non eliminano questo controllo.
Gestire percorsi e consumi dei singoli agenti
Il provider waterfall è un elenco ordinato di distribuzioni che possono servire un modello. In caso di errori di capacità o trasporto, il gateway può tentare un altro percorso. Cambiare fornitore per lo stesso modello è diverso dal scegliere un altro modello in base al compito.
Chiavi separate, liste di modelli consentiti e limiti di budget aiutano a circoscrivere ogni flusso. I log mostrano percorso e consumo delle richieste. Un primo agente con budget contenuto consente di verificare concretamente la spesa prima di estendere l’integrazione.
Cercare risparmi nei dati di utilizzo
Intelligence analizza le tracce per valutare selezione dei modelli, cache, compressione dei prompt, batch ed effort di ragionamento. Può partire da Arize, Braintrust, LangChain, database o traffico del gateway.
Per progetti Enterprise è prevista anche la valutazione di un modello dedicato, addestrato tramite distillazione, reinforcement learning o fine-tuning supervisionato. Il modello viene verificato prima di servire richieste e richiede attivazione esplicita. I risultati dei casi pubblicati non sono promesse di risparmio per qualsiasi applicazione.
Free, Pro e fatturazione dei modelli
Al 6 settembre 2026, il listino pubblico in USD indica Free a 0 USD al mese con 500 crediti, Pro da 20 USD con 2.000 crediti ed Enterprise personalizzato. Un credito vale 0,01 USD e sui token instradati non viene applicato un ricarico. L’inferenza consuma comunque crediti oppure viene fatturata dal fornitore quando usi BYOK.
Il listino contiene una discordanza: la tabella assegna BYOK e modelli locali a Pro, mentre la FAQ parla di BYOK su tutti i piani. Verifica l’abilitazione nell’account; il prezzo mostrato dalla piattaforma all’acquisto prevale. Non è un preventivo in euro o comprensivo di imposte locali.
Hosting proprio e confini della privacy
Il repository ufficiale adotta Apache-2.0 e documenta uvx --from experiential exp run per avviare il gateway. Consulta i requisiti prima del deployment. Il software gratuito non comprende infrastruttura e inferenza, né definisce la licenza dei risultati dei modelli.
Le politiche di provider consentiti, ZDR e assenza di training presso determinati fornitori richiedono configurazione. La privacy policy del sito esclude account e richieste della piattaforma: non chiarisce la conservazione dei prompt API. Un gateway locale inoltra comunque i dati all’esterno se scegli API esterne. Mascheramento PII e difesa integrata da prompt injection sono indicati come non ancora disponibili.
Domande frequenti
Il piano gratuito offre inferenza illimitata?
No: include un’assegnazione mensile di crediti. Nessun ricarico sui token non significa assenza del costo del modello.
Posso mantenere il mio client OpenAI compatibile?
La procedura documentata cambia endpoint e chiave e usa lo slug del catalogo. Verifica poi funzioni, contesto e condizioni regionali del modello scelto.
Con il self-hosting i prompt restano sempre sul server?
Dipende dal percorso. Se il gateway usa un fornitore esterno, gli inoltra la richiesta anche quando il gateway è installato internamente.
Risorse ufficiali
- GitHub: codice, licenza e installazione.
- Discord collegato dal sito: accesso alla community.
- Stato del servizio: verifica delle interruzioni.
- Intelligence: analisi delle tracce e modelli dedicati.
Strumenti correlati
API e infrastruttura per modelli IA →
OpenRouterFreemium
Gateway API unificato e router per modelli di IA
LLM GatewayFreemium
Una sola API per modelli, instradamento e analisi dei costi
AIsaA pagamento
Una chiave API per collegare modelli e fonti di dati agli agenti.
TavilyFreemium
Cerca, estrai, scansiona e analizza il web aggiornato per agenti IA tramite una sola API
FirecrawlFreemium
Trasforma siti web in Markdown pulito o dati strutturati per agenti AI, RAG e automazioni.