
TrustedRouterDe pago
Gateway compatible con OpenAI para enrutar solicitudes entre modelos con controles de privacidad verificables.
Experiential Labs: pasarela de IA para varias API
Una API común para conectar modelos y controlar rutas, claves y consumo.
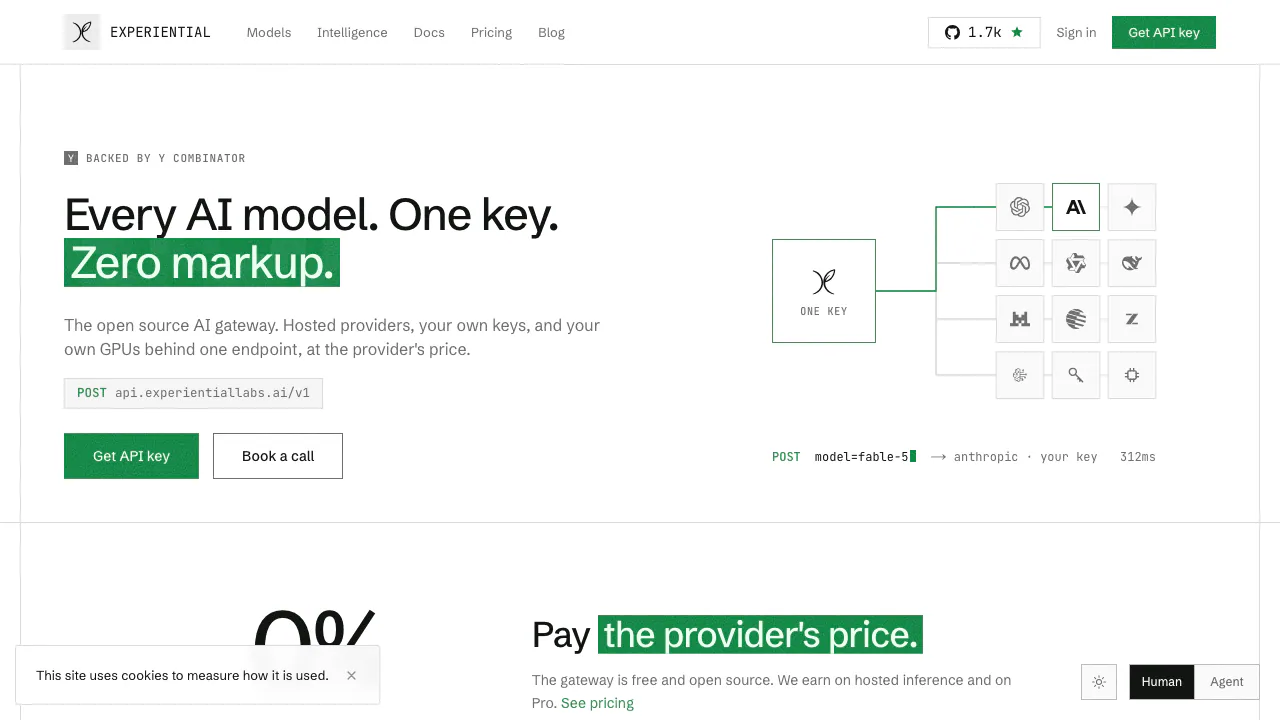
Experiential Labs es una pasarela de IA de código abierto para integrar varios proveedores de modelos en aplicaciones y agentes. Reúne el acceso mediante API, el enrutamiento y el control del gasto en un punto común. Se puede utilizar como plataforma alojada o desplegar el gateway en infraestructura propia.
Explicación sencilla: ¿para qué sirve esta web?
Imagina una recepción compartida para las peticiones de IA de tu producto. La aplicación indica qué modelo necesita; la pasarela busca una ruta configurada, aplica permisos y presupuesto, y devuelve la respuesta. Así puedes gestionar varios proveedores sin repartir toda esa lógica entre tus aplicaciones.
La web presenta el servicio y enlaza con la plataforma donde se administran claves, catálogo y consumo. Su operador es Resolute Labs AI, Inc., bajo el nombre Experiential Labs. Está orientado a desarrolladores y equipos que operan aplicaciones o agentes con distintos modelos.
Conectar una aplicación y comprobar el resultado
La guía oficial de inicio permite empezar con un cliente compatible con OpenAI:
- Inicia sesión y crea una clave en Settings → API keys. Guarda el secreto cuando aparezca: solo se muestra una vez.
- Configura
EXPLABS_API_KEYy la URL basehttps://api.experientiallabs.ai/v1. - Elige un identificador de modelo vigente en el catálogo y envía un mensaje breve de prueba.
- Comprueba la respuesta y revisa la ruta, los tokens y el coste en la consola. Para una respuesta progresiva, activa
stream: true.
Se documentan Chat Completions y Responses con streaming. Cada modelo conserva sus formatos y límites de contexto. Los modelos de OpenAI, Anthropic y Gemini también están sujetos a comprobaciones de región de la IP de entrada; aparecer en el catálogo no garantiza disponibilidad local.
Separar respaldo de proveedores y elección de modelo
Una cascada de proveedores contiene varias rutas ordenadas para servir un modelo. Si falla una por capacidad o transporte, la pasarela puede probar otra. Esto resuelve la disponibilidad de una ruta; la elección de un modelo diferente para una tarea es una decisión distinta.
Los límites de presupuesto, las listas de modelos permitidos y las claves separadas facilitan asignar consumo a cada agente o aplicación. Los registros muestran la ruta y el coste de las peticiones. Conviene validar primero un flujo con su propia clave y un presupuesto acotado antes de ampliar el despliegue.
Optimizar con trazas del trabajo real
La capa Intelligence analiza trazas para detectar oportunidades de caché, compresión de prompts, procesamiento por lotes, selección de modelos y ajuste del esfuerzo de razonamiento. Puede partir de Arize, Braintrust, LangChain, una base de datos o el propio tráfico de la pasarela.
La oferta Enterprise contempla modelos propios mediante destilación, aprendizaje por refuerzo o ajuste supervisado. Deben validarse antes de servir peticiones y requieren activación voluntaria. Los porcentajes de ahorro publicados en casos concretos no garantizan el mismo resultado para tu aplicación.
Créditos gratuitos y condiciones de pago
El 6 de septiembre de 2026, la página de precios muestra importes en USD: Free cuesta 0 USD al mes e incluye 500 créditos mensuales; Pro parte de 20 USD con 2.000 créditos; Enterprise se acuerda a medida. La página indica 0,01 USD por crédito y ningún recargo sobre los tokens enrutados.
La inferencia sigue teniendo coste: se descuentan créditos o el proveedor factura directamente si aportas tu propia clave, BYOK. Hay una contradicción pública: la tabla reserva BYOK y modelos locales para Pro, pero las preguntas frecuentes dicen que BYOK está disponible en todos los planes. Confirma la habilitación real en la plataforma. El precio al comprar prevalece y estas cifras no son una tarifa en euros ni una promesa sobre impuestos.
Alojamiento propio y tratamiento de datos
El repositorio oficial usa Apache-2.0. El comando de arranque documentado es uvx --from experiential exp run; consulta primero sus requisitos. El software gratuito no cubre servidores ni inferencia, y su licencia no establece los derechos de las respuestas de cada modelo.
Existen políticas de proveedores permitidos, enrutamiento con retención cero y proveedores que no entrenan con los datos. Son controles que deben configurarse. La política de privacidad pública solo cubre la web promocional, no las peticiones de la plataforma. No permite deducir un plazo general de conservación de prompts. Además, una instalación propia enviará contenido fuera si utilizas proveedores externos. El filtrado integrado de PII y la defensa frente a inyección de prompts figuran como pendientes.
Preguntas frecuentes
¿Free permite llamadas ilimitadas?
No. Ofrece un cupo mensual de créditos. No añadir recargo al token no elimina el coste de la inferencia.
¿Puedo conservar mi cliente compatible con OpenAI?
La conexión documentada cambia URL base, clave e identificador de modelo. Comprueba después capacidades, contexto y disponibilidad regional del modelo elegido.
¿Alojarlo por mi cuenta evita enviar datos a terceros?
Depende de la ruta del modelo. Una pasarela propia puede reenviar peticiones a API externas; revisa tanto la configuración como las condiciones de esos servicios.
Recursos oficiales
- GitHub: código, licencia y despliegue.
- Discord enlazado por el sitio oficial: acceso a la comunidad.
- Estado del servicio: incidencias.
- Intelligence: análisis de trazas y modelos propios.
Herramientas relacionadas
API e infraestructura de modelos de IA →
OpenRouterFreemium
Pasarela API unificada y enrutador de modelos de IA
LLM GatewayFreemium
Una API para conectar modelos y controlar el consumo
AIsaDe pago
Conecta modelos y datos externos con una sola clave API.
TavilyFreemium
Busca, extrae, rastrea e investiga la web actual para agentes de IA mediante una API
FirecrawlFreemium
Convierte sitios web en Markdown limpio o datos estructurados para agentes de IA, RAG y automatizaciones.