
TrustedRouterPago
Gateway compatível com OpenAI para rotear solicitações entre modelos com controles verificáveis de privacidade.
Experiential Labs: gateway de IA para modelos e APIs
Conecte modelos por uma única API e acompanhe chaves, rotas e gastos.
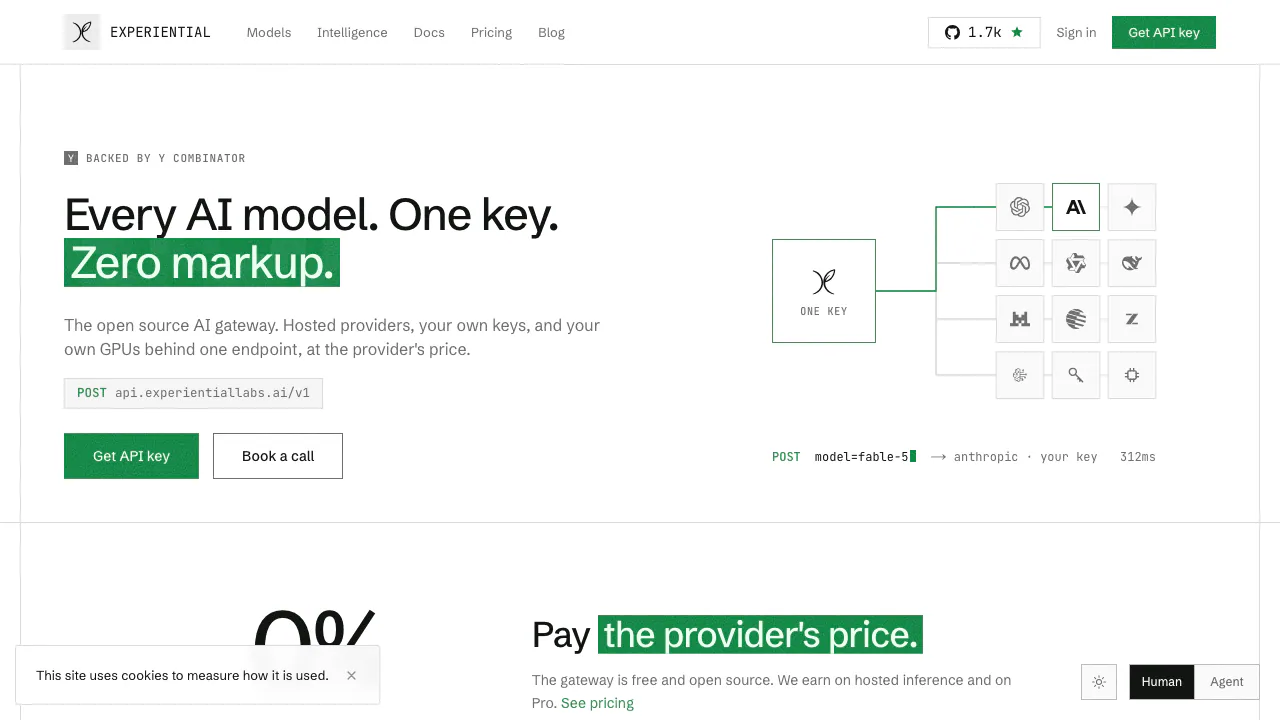
Experiential Labs é um gateway de IA de código aberto para desenvolvedores e equipes que usam vários provedores de modelos. A proposta é reunir acesso por API, roteamento e controle de gastos. Há uma plataforma hospedada e a opção de executar o gateway na sua própria infraestrutura.
Em linguagem simples: para que serve este site?
Pense em uma central de atendimento para as solicitações de IA do seu aplicativo. O aplicativo informa o modelo desejado; o gateway encontra uma rota configurada, verifica permissões e orçamento e devolve a resposta. Isso concentra a administração que, de outra forma, ficaria espalhada entre vários serviços.
O site apresenta o produto e leva à plataforma de modelos, chaves e consumo. A operadora informada é Resolute Labs AI, Inc., sob o nome Experiential Labs. O público principal são equipes que desenvolvem produtos com IA, agentes e infraestrutura para múltiplos projetos.
Faça a primeira chamada antes de migrar o fluxo completo
O guia oficial de início documenta Chat Completions e Responses compatíveis com OpenAI, com streaming.
- Entre na plataforma e crie uma chave em Settings → API keys. Copie o segredo na hora, pois ele aparece uma única vez.
- Configure
EXPLABS_API_KEYe usehttps://api.experientiallabs.ai/v1como URL base. - Escolha o identificador atual de um modelo no catálogo e envie uma mensagem curta.
- Confira a resposta, a rota, os tokens e o custo na interface. Use
stream: truepara testar a entrega progressiva.
Cada modelo mantém seus limites de contexto e formatos. Modelos OpenAI, Anthropic e Gemini passam por verificação da região do IP de entrada. A presença no catálogo não garante acesso em todos os países; BYOK e fallback preservam essas restrições.
Rotas de contingência e orçamento por aplicação
O provider waterfall é uma sequência ordenada de implantações capazes de atender um modelo. Em erros de capacidade ou transporte, outra rota pode ser tentada. Isso é diferente de selecionar um modelo alternativo para uma tarefa.
Chaves separadas, listas de modelos permitidos e tetos de gasto ajudam a controlar agentes e equipes. Os logs registram o caminho percorrido e o custo. Começar com um fluxo de orçamento limitado permite conferir o consumo real antes de liberar mais aplicações.
Otimização baseada nas suas próprias chamadas
A camada Intelligence avalia traces para encontrar oportunidades de cache, escolha de modelo, compressão de prompts, processamento em lote e esforço de raciocínio. As fontes citadas incluem Arize, Braintrust, LangChain, bancos de dados e o tráfego do próprio gateway.
No escopo Enterprise, também é possível avaliar um modelo próprio treinado por destilação, aprendizado por reforço ou ajuste supervisionado. Ele precisa ser validado antes de atender chamadas e só é ativado por escolha explícita. Ganhos de estudos de caso não são uma promessa de economia universal.
Créditos grátis e preços em dólar
Em 6 de setembro de 2026, a página de preços mostra Free a US$ 0 por mês com 500 créditos; Pro a partir de US$ 20 com 2.000 créditos mensais; Enterprise sob acordo. Um crédito corresponde a US$ 0,01, sem acréscimo sobre tokens roteados. A inferência continua consumindo créditos ou sendo cobrada diretamente pelo provedor quando você usa BYOK.
Existe divergência sobre o plano necessário: a tabela coloca BYOK e modelos locais no Pro, mas a FAQ diz que BYOK está em todos os planos. Confirme a liberação efetiva na conta. O preço exibido na plataforma na compra prevalece; não há aqui confirmação de cobrança em reais, impostos locais ou meios de pagamento brasileiros.
Hospedagem própria e privacidade
O repositório oficial usa Apache-2.0 e apresenta o comando uvx --from experiential exp run. Consulte os requisitos antes de executar. Código gratuito não inclui servidores nem inferência, e a licença do gateway não determina os direitos sobre saídas dos modelos.
As políticas de provedores permitidos, retenção zero nas rotas e não treinamento pelos fornecedores precisam ser configuradas. A política de privacidade pública cobre somente o site e exclui as chamadas da plataforma. Ela não estabelece um prazo de retenção dos prompts API. Mesmo hospedando o gateway, suas solicitações saem da rede se você escolher um provedor externo. Mascaramento integrado de PII e defesa contra injeção de prompts são descritos como ainda não entregues.
Perguntas frequentes
O plano Free permite uso ilimitado?
Não. Ele oferece uma quantidade mensal de créditos. Ausência de acréscimo por token não elimina o custo da inferência.
Posso manter meu cliente compatível com OpenAI?
A conexão documentada altera URL base e chave e utiliza o identificador do catálogo. Teste as funções e condições regionais do modelo escolhido.
Hospedar por conta própria mantém tudo dentro da empresa?
Depende da rota. APIs externas recebem os dados das solicitações encaminhadas a elas, mesmo com o gateway em infraestrutura interna.
Recursos oficiais
- GitHub: código, licença e instalação.
- Discord indicado no site: acesso à comunidade.
- Status do serviço: incidentes.
- Intelligence: análise de traces e modelos próprios.
Ferramentas parecidas
APIs e infraestrutura de modelos de IA →
OpenRouterFreemium
Gateway de API unificada e roteador para modelos de IA
LLM GatewayFreemium
Uma API para conectar modelos e acompanhar os custos
AIsaPago
Uma chave API para modelos, pesquisa e fontes de dados externas.
TavilyFreemium
Pesquise, extraia, rastreie e investigue a web atual para agentes de IA por uma API
FirecrawlFreemium
Converta sites em Markdown limpo ou dados estruturados para agentes de IA, RAG e automações.