서버리스 앱, 모델 API, 에이전트와 저장소를 연결하는 공식 개발 문서.
Together AI API로 모델을 연결하고 맞춤형으로 활용하기
앱에 AI 모델을 연결하고 추론, 미세 조정, GPU 작업에 맞는 실행 환경을 선택하세요.
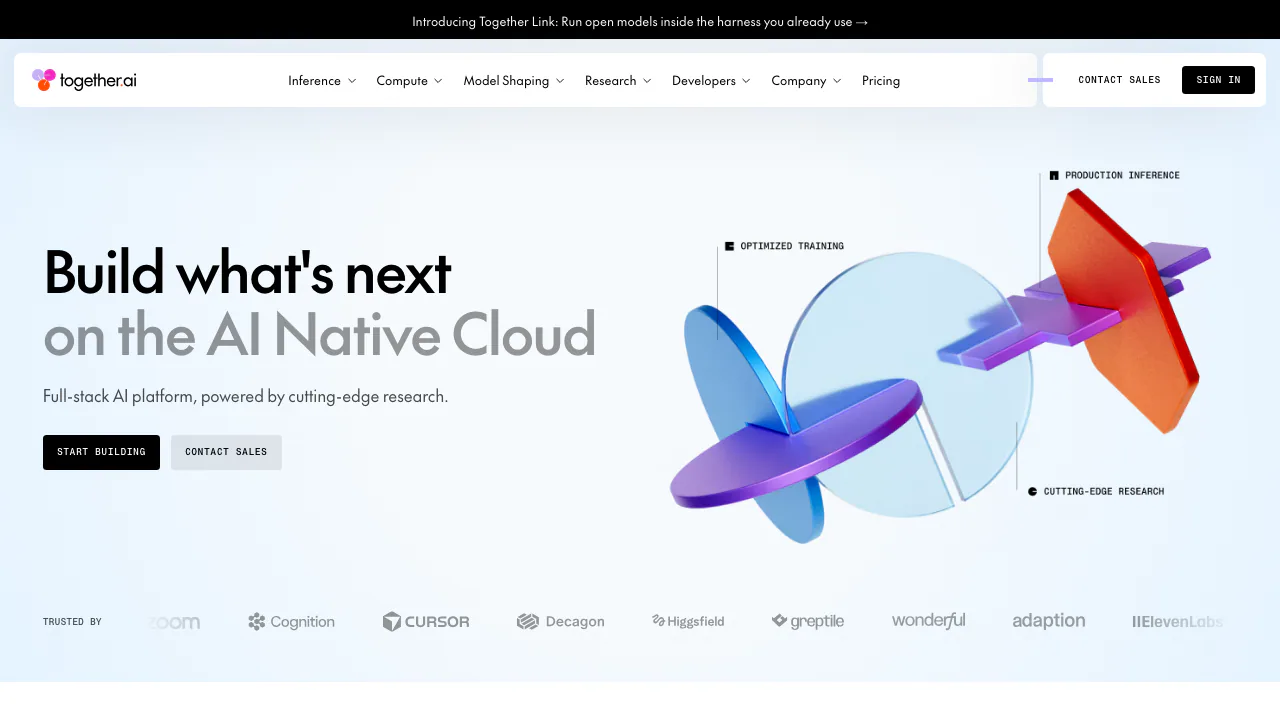
쉽게 설명하면 Together AI는 무엇인가요?
Together AI는 개발자의 앱 대신 클라우드에서 AI 모델을 실행하는 플랫폼입니다. 프로그램이 질문이나 텍스트, 지원되는 이미지 등을 보내면 선택한 모델이 답변이나 생성 결과를 돌려줍니다. 호스팅 API로 시작하면 GPU를 직접 구매하거나 모델 서버를 관리하지 않아도 됩니다.
운영사는 Together Computer, Inc.이며 개발자와 머신러닝 팀을 대상으로 합니다. 챗봇, 정보 추출, 생성 기능을 만들고 자체 데이터로 모델을 조정할 수 있습니다. 제품 화면, 업무 로직, 결과 품질 검증은 개발 팀이 담당합니다.
API 키 발급부터 첫 응답 확인까지
- 계정을 만들고 현재 크레딧 조건을 확인합니다. 프로젝트의 API keys 페이지에서 키를 만들고 보관합니다. 전체 키는 한 번만 표시됩니다.
- TOGETHER_API_KEY 환경 변수를 설정하고 공식 Python 또는 TypeScript SDK를 설치합니다. REST 요청도 사용할 수 있습니다.
- 현재 모델 목록에서 정확한 모델 ID를 선택하고 model과 messages를 포함한 채팅 요청을 보냅니다. 반환된 메시지 본문을 확인합니다.
- 실제 작업 예제로 품질, 지연 시간, 토큰 사용량을 비교합니다. 한국어로 쓸 경우 표현과 지시 수행 능력도 함께 점검합니다.
공식 시작 안내에 실행 가능한 예제가 있습니다. 지원되는 OpenAI SDK 메서드는 Together 키와 기본 주소 https://api.together.ai/v1, Together 모델 ID로 설정할 수 있습니다. 범위는 호환성 문서를 확인하세요.
지원 모델은 스키마에 맞춘 JSON을 반환할 수 있습니다. 함수 호출은 함수 이름과 인자를 제안하며 실제 검증과 실행은 앱이 맡습니다. 이미지 입력, 문맥 길이, 도구 지원은 모델마다 다릅니다.
요청 처리 방식과 용량 선택
Serverless는 실험과 가변적인 트래픽에 적합합니다. 성능은 최선 노력 방식으로 제공되며 수요가 높을 때 429나 503이 발생할 수 있습니다. 요청을 분산하고 대기 시간을 늘리는 제한된 재시도를 적용하세요. Serverless에서는 처리 지역을 선택할 수 없습니다.
즉시 답이 필요 없는 작업은 Batch를 고려할 수 있습니다. 요청마다 고유 custom_id가 있는 JSONL을 준비하고 업로드한 뒤 작업을 생성합니다. 상태를 확인하고 결과를 내려받아 ID로 원본과 연결하며 오류도 검토합니다. 배치 작업 안내에 형식과 절차가 나옵니다.
Provisioned Throughput은 합의된 성능 목표를 가진 용량 예약이고, Dedicated Model Inference는 전용 GPU 배포입니다. 이용률, 지연 시간, 지역 요구, 계약 조건을 함께 비교해야 합니다.
요금과 무료 사용의 범위
2026년 10월 12일 확인 기준, 셀프서비스는 선불 크레딧 방식이며 공식 결제 문서는 일반 무료 체험을 제공하지 않는다고 설명합니다. 최초 최소 구매액은 도움말과 개발 문서가 서로 다르므로 계정 결제 화면에서 확인하세요. 특정 모델의 요금이 0이라고 플랫폼 전체가 무제한 무료인 것은 아닙니다.
공개 요금은 미국 달러 기준입니다. 텍스트는 모델별 입력·출력 토큰 가격을 적용하고 미디어는 모델별 단위를 사용합니다. 준비된 전용 복제본은 대기 중에도 시간 비용이 발생할 수 있습니다. 학습, 이후 호스팅, 클러스터 저장소는 별도 항목입니다.
실제 사용량을 공식 요금표와 크레딧 규칙에 대입하세요. 불필요한 배포는 중지하거나 복제본 수를 줄이는 것이 좋습니다.
미세 조정은 처리한 학습·검증 토큰을 계산하며 모델, 방식, 적용되는 최소 요금 조건에 따라 비용이 달라집니다.
자체 데이터로 모델을 미세 조정하기
미세 조정은 LoRA와 전체 가중치 업데이트를 제공하며 지도 학습과 선호 데이터 기반 DPO를 지원합니다. 적합한 JSONL 또는 Parquet 데이터를 준비해 업로드하고 검증을 기다립니다. 기본 모델과 설정을 선택한 뒤 예상 비용을 확인하고 학습을 시작합니다.
완료 후 학습에 포함하지 않은 예제로 기본 모델과 비교하세요. 결과는 전용 엔드포인트에 배포하거나 체크포인트로 내려받을 수 있습니다. 미세 조정 시작 문서를 따라 진행하되, 품질 향상은 테스트로 확인해야 합니다.
더 큰 학습 작업에는 Kubernetes 또는 Slurm과 영구 저장소를 사용하는 GPU 클러스터가 있습니다. 단순 API 연결보다 인프라 운영 지식이 더 필요합니다.
저장과 학습 동의는 별개입니다
프롬프트와 응답 저장은 기본적으로 켜져 있습니다. 모델 학습에 사용하도록 허용하는 설정은 별도 동의 항목이며 기본적으로 꺼져 있습니다. 조직 관리자가 저장을 끄면 이후 추론 요청에 Zero Data Retention을 적용할 수 있고 passthrough 모델도 비활성화됩니다.
ZDR 문서에 따르면 결제 메타데이터와 계정 정보는 남습니다. Batch나 미세 조정을 위해 업로드한 파일도 직접 삭제할 때까지 보관됩니다. 이전 데이터가 소급 삭제되는 것은 아닙니다. 외부 공급자에게 전달하는 모델은 해당 공급자의 데이터 정책도 확인해야 합니다.
상업적으로 사용하기 전 모델별 라이선스와 서비스 약관을 검토하세요. 공개 모델이라도 사용 조건은 서로 다를 수 있습니다.
자주 묻는 질문
API 키는 어디에서 발급하나요?
프로젝트의 API keys 설정에서 만들고 환경 변수에 저장하세요. SDK나 REST 클라이언트에는 Together 키를 사용해야 합니다.
Together AI는 무료인가요?
일반 무료 체험이나 가입 크레딧을 전제로 계획하지 마세요. 현재 문서는 선불 접근을 설명하므로 계정 요건과 모델 가격을 확인해야 합니다.
같은 API에서 모델을 바꿀 수 있나요?
지원 엔드포인트에서는 유효한 모델 ID를 변경할 수 있습니다. 다만 입력 형식, 문맥 길이, JSON 및 도구 지원을 다시 확인하세요.
제 프롬프트로 모델을 학습하나요?
학습에는 별도 동의가 필요하고 기본 설정은 꺼져 있습니다. 저장은 기본적으로 켜져 있으므로 필요하면 조직 ZDR 설정을 바꾸고 업로드한 파일은 따로 관리하세요.
공식 자료와 개발자 커뮤니티
- 지원 센터: 도움말과 문의 접수.
- 서비스 상태: 장애 확인.
- 공식 GitHub: SDK와 예제.
- Discord 커뮤니티: 기술 질문.
- 공식 X 계정: 제품 소식.
비슷한 도구
AI 모델 API 및 인프라 →
FastRouter부분 무료
하나의 API로 모델 연결과 팀 사용 비용을 관리
teai.io부분 무료
하나의 API로 여러 AI 모델을 연결하고 크레딧 사용량을 관리하세요.
eu/jev부분 무료
문맥을 분류 항목, 확률과 순서가 있는 점수로 바꾸는 독립 API.
애플리케이션 코드가 바로 활용할 수 있는 유형화된 결과와 확률.
LLM Gateway부분 무료
여러 모델의 API 연결, 요청 라우팅과 비용 분석