Cloudflare DevelopersFreemium
Oficjalne przewodniki po aplikacjach serverless, modelach AI i usługach chmurowych.
Together AI API do uruchamiania i dostrajania modeli
Dodawaj modele AI do aplikacji i dobieraj zasoby do inferencji, dostrajania oraz treningu.
Prosto wyjaśnione: do czego służy Together AI?
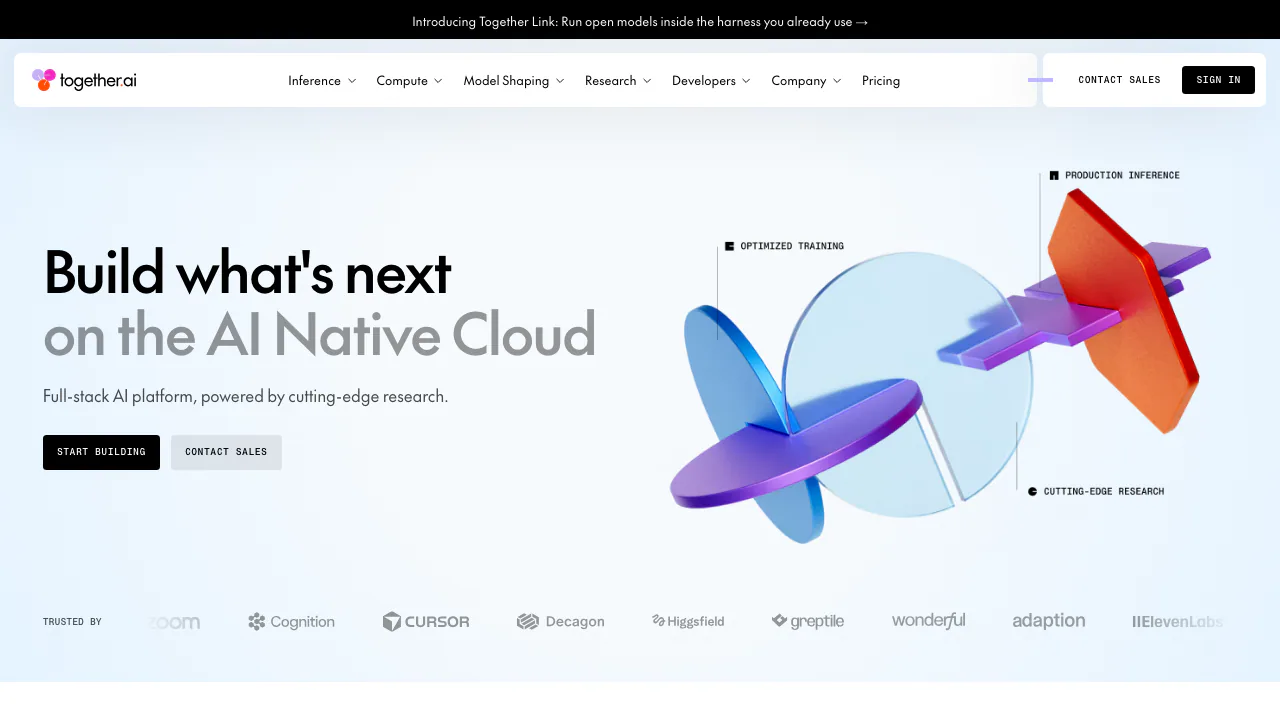
Together AI uruchamia modele sztucznej inteligencji w chmurze dla Twoich aplikacji. Program wysyła pytanie, tekst lub inne obsługiwane dane, a model zwraca odpowiedź albo wygenerowaną treść. Korzystając z hostowanego API, nie musisz kupować własnej karty GPU ani utrzymywać serwera modelu.
Platforma firmy Together Computer, Inc. jest przeznaczona dla programistów i zespołów uczenia maszynowego. Umożliwia budowanie asystentów, ekstrakcji informacji i funkcji generatywnych, a także dostrajanie modeli. Interfejs aplikacji, reguły biznesowe i ocenę jakości nadal przygotowuje Twój zespół.
Od klucza API do pierwszego wyniku
- Załóż konto, sprawdź wymagania dotyczące salda i utwórz klucz w ustawieniach API keys projektu. Zapisz go od razu: pełna wartość jest pokazywana tylko raz.
- Ustaw zmienną środowiskową TOGETHER_API_KEY i zainstaluj SDK Python lub TypeScript albo skorzystaj z REST.
- Wybierz aktualny identyfikator modelu i wyślij żądanie czatu z polami model i messages. Sprawdź treść odpowiedzi.
- Przetestuj rzeczywiste przykłady, porównując jakość, opóźnienie i zużycie tokenów.
Oficjalny przewodnik zawiera działające przykłady. Dla obsługiwanych metod SDK OpenAI ustaw klucz Together, adres bazowy https://api.together.ai/v1 oraz identyfikator modelu Together. Zakres obsługi opisuje dokumentacja zgodności.
Wybrane modele zwracają JSON zgodny ze schematem. Wywołania funkcji wskazują nazwę i argumenty, ale ich sprawdzenie i wykonanie należy do aplikacji. Obsługa obrazów, narzędzi oraz długość kontekstu zależą od modelu.
Dobierz sposób przetwarzania do ruchu
Serverless pasuje do prototypów i zmiennego ruchu. Wydajność jest zapewniana na zasadzie best-effort; przy dużym obciążeniu możliwe są błędy 429 i 503. Ogranicz nagłe serie żądań i stosuj ograniczone ponowienia z rosnącym czasem oczekiwania. W tej opcji nie wybierasz regionu przetwarzania.
Zadania, które mogą poczekać, można wysłać jako Batch. Przygotuj JSONL z unikatowym custom_id dla każdego żądania, prześlij plik, uruchom zadanie i sprawdzaj jego stan. Pobierz wyniki, dopasuj je po identyfikatorach i przejrzyj błędy. Szczegóły zawiera instrukcja Batch.
Provisioned Throughput rezerwuje przepustowość na uzgodnionych warunkach. Dedicated Model Inference wykorzystuje dedykowane GPU. Porównaj wykorzystanie zasobów, opóźnienia, region i zobowiązania umowne.
Cennik, środki przedpłacone i dostęp bez opłat
Stan na 12 października 2026 r.: samoobsługa korzysta z przedpłaconych środków, a oficjalne dokumenty nie oferują ogólnego bezpłatnego okresu próbnego. Centrum pomocy i dokumentacja podają różne minimalne kwoty pierwszego zakupu. Sprawdź kwotę na swoim koncie. Zerowa stawka jednego modelu nie oznacza bezpłatnego korzystania z całej platformy.
Publiczne ceny są w dolarach USA. Tekst jest rozliczany według stawek tokenów wejściowych i wyjściowych; multimedia mają własne jednostki. Gotowe repliki dedykowane są rozliczane czasowo także podczas bezczynności. Trening obejmuje przetworzone tokeny treningowe i walidacyjne, a późniejszy hosting jest osobny. Magazyn danych klastra również generuje koszty.
Użyj aktualnego cennika i zasad środków dla własnego obciążenia. Zatrzymuj zbędne wdrożenia lub zmniejszaj liczbę replik.
Koszt dostrajania zależy też od modelu, metody i obowiązujących opłat minimalnych.
Dostrajanie na własnych przykładach
Together obsługuje LoRA i pełne dostrajanie wag, a także uczenie nadzorowane oraz DPO na danych preferencji. Przygotuj odpowiedni JSONL lub Parquet, prześlij dane i poczekaj na walidację. Następnie wybierz model bazowy oraz parametry i sprawdź szacowany koszt.
Po treningu porównaj wynik z modelem bazowym na odłożonych przykładach. Model można wdrożyć na dedykowanym endpointcie lub pobrać jako checkpoint. Przewodnik dostrajania pokazuje cały proces. Poprawę jakości trzeba zmierzyć, nie zakładać.
Większe zadania mogą korzystać z klastrów GPU, Kubernetes lub Slurm i trwałego magazynu danych. Wymaga to większych kompetencji infrastrukturalnych niż zwykłe wywołanie API.
Co dzieje się z przesłanymi danymi?
Zapisywanie promptów i odpowiedzi jest domyślnie włączone. Wykorzystanie do treningu modeli wymaga odrębnej zgody, domyślnie wyłączonej. Administrator organizacji może wyłączyć zapis, uruchamiając Zero Data Retention dla kolejnych żądań inferencji. Wyłącza to również modele passthrough.
Dokumentacja ZDR wyjaśnia, że metadane rozliczeniowe i dane konta pozostają. Pliki przesłane do Batch lub dostrajania są przechowywane do czasu usunięcia. ZDR nie usuwa wcześniejszych danych wstecznie. Przy przekazywaniu żądań innemu dostawcy obowiązują także jego zasady.
Przed użyciem komercyjnym sprawdź licencję modelu oraz warunki usługi. Otwarte modele nie muszą mieć identycznych uprawnień.
Najczęstsze pytania
Gdzie utworzyć klucz API?
W ustawieniach API keys projektu. Przechowuj go w zmiennej środowiskowej i używaj z SDK lub klientem REST.
Czy Together AI jest darmowe?
Nie zakładaj ogólnego darmowego planu ani środków powitalnych. Aktualna dokumentacja opisuje przedpłatę; sprawdź wymagane saldo i stawkę wybranego modelu.
Czy jedno API obsługuje różne modele?
Tak, dla zgodnych endpointów możesz zmienić identyfikator modelu. Sprawdź jednak format danych, kontekst, JSON i obsługę narzędzi.
Czy prompty służą do treningu?
Tylko po odrębnej zgodzie, wyłączonej domyślnie. Zapis promptów jest innym ustawieniem i domyślnie działa; ZDR oraz usuwanie przesłanych plików wymagają osobnego sprawdzenia.
Oficjalne materiały i społeczność
- Pomoc techniczna: baza wiedzy i zgłoszenia.
- Status usług: informacje o awariach.
- GitHub: SDK i przykłady.
- Społeczność Discord: pytania techniczne.
- Together AI na X: aktualności produktu.
Podobne narzędzia
API modeli AI i infrastruktura →
FastRouterFreemium
Łącz modele przez jedno API i kontroluj wydatki zespołu
teai.ioFreemium
Łącz różne modele AI przez jedno API i kontroluj zużycie wspólnego salda.
eu/jevFreemium
Zamieniaj kontekst na kategorie, prawdopodobieństwa i oceny dla aplikacji.
TypeSafe AIPłatne
Typowane odpowiedzi i prawdopodobieństwa gotowe do użycia w kodzie.
LLM GatewayFreemium
Jedno API do modeli, routingu i kontroli kosztów