Workers、AI推論、エージェント、ストレージをつなぐ公式開発ガイド。
Together AI APIでモデルを呼び出し、用途に合わせて調整
AIモデルのAPI接続から追加学習、GPUクラスタまで、用途に合う実行環境を選べます。
やさしく解説:Together AIは何に使うサイト?
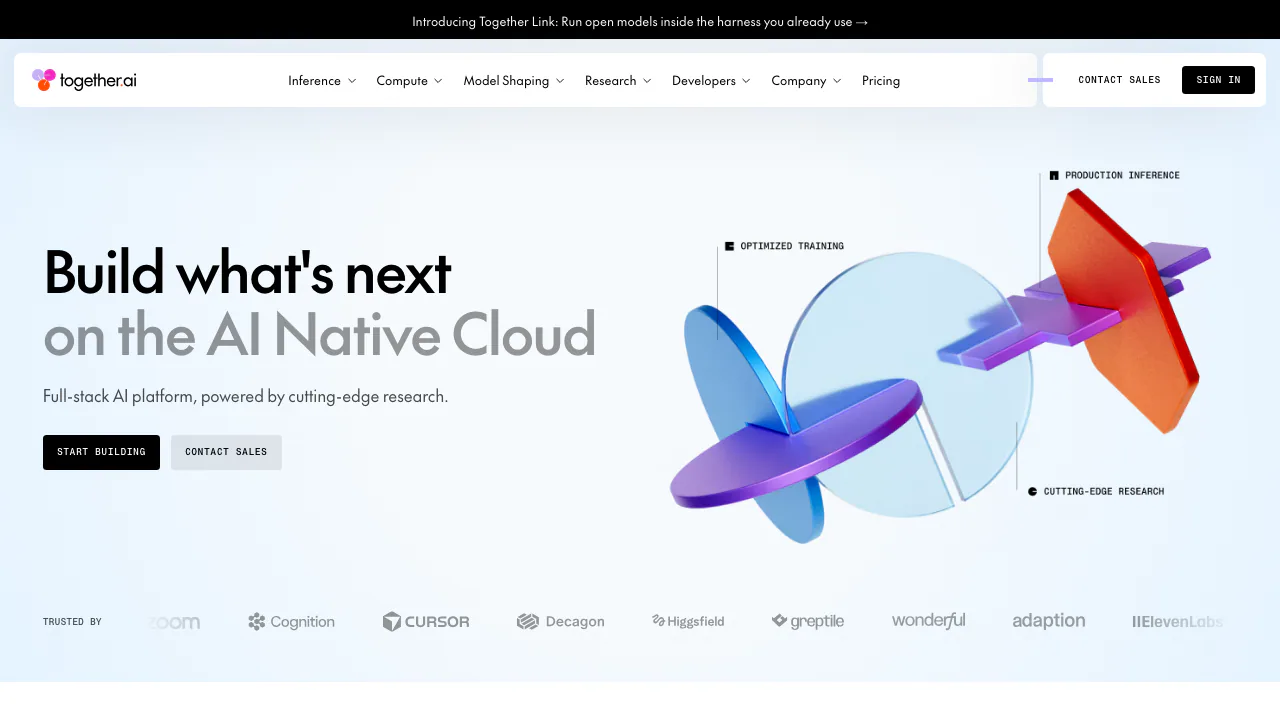
Together AIは、自分のアプリからAIモデルを利用できるクラウド基盤です。プログラムが質問や文章、対応する画像などを送ると、選んだモデルが処理して回答や生成結果を返します。ホストされたAPIから始める場合、自分でGPUを購入したり、モデル用サーバーを管理したりする必要はありません。
運営元はTogether Computer, Inc.です。開発者や機械学習チームが、アシスタント、情報抽出、生成機能などを実装する用途に向いています。独自データによる追加学習も可能ですが、アプリの画面、業務処理、回答の品質確認は開発側で用意します。
料金と無料利用の範囲を確認する
2026年10月12日確認。セルフサービスはプリペイドのクレジット方式で、公式課金資料は一般向けの無料トライアルを提供していないと説明しています。初回購入の最低金額はヘルプセンターと開発文書で異なるため、アカウントの課金画面で確認してください。特定モデルの料金がゼロでも、プラットフォーム全体が無制限に無料になるわけではありません。
公開料金は米ドルです。テキストはモデル別の入力・出力トークン料金、メディアは対応する単位で計算されます。専用環境の準備済みレプリカは待機中でも時間課金される場合があります。学習費用とその後のホスティング、GPUクラスタのストレージは別に見積もります。
実際の入力・出力量を公式料金表とクレジットの規則に当てはめ、不要なデプロイは停止または縮小しましょう。
追加学習では学習・検証で処理したトークンが数えられ、モデル、方式、最低料金などの条件も費用に影響します。
APIキーを取得して最初のリクエストを送る
- アカウントを作成し、課金画面でクレジットの条件を確認します。プロジェクトのAPI keys画面でキーを作成し、保存します。キー全体が表示されるのは一度だけです。
- 環境変数TOGETHER_API_KEYを設定し、公式PythonまたはTypeScript SDKを導入します。RESTからの直接利用もできます。
- 現在のモデル一覧からモデルIDを選び、modelとmessagesを含むチャットリクエストを送信します。返されたメッセージ本文を確認します。
- 実際の業務例で品質、応答時間、トークン消費を測定します。日本語で利用する場合は、表現や指示への追従も検証します。
公式クイックスタートに実行例があります。対応するOpenAI SDKのメソッドでは、Togetherのキー、ベースURL https://api.together.ai/v1、TogetherのモデルIDを設定できます。適用範囲は[互換性の説明](https://docs.together.ai/docs/inference/openai-compatibility)で確認してください。
対応モデルはスキーマに沿ったJSONを返せます。関数呼び出しでは関数名と引数が返り、検証と実行はアプリ側が担当します。画像入力、コンテキスト長、ツール対応はモデルごとに異なります。
Serverlessとバッチ、専用環境の使い分け
Serverlessは試作や変動するトラフィックに向いています。性能はベストエフォートで、混雑時には429や503が発生する場合があります。大量の同時送信を避け、待ち時間を増やしながら回数を制限して再試行します。処理リージョンは選べません。
即時回答が不要ならBatchを検討できます。リクエストごとに一意のcustom_idを付けたJSONLを用意し、アップロードしてジョブを作成します。状態を確認し、完了後に結果を取得してIDで照合し、エラーも確認します。バッチ処理の手順が参考になります。
Provisioned Throughputは契約上の目標を伴う処理能力の予約、Dedicated Model Inferenceは専用GPU上のモデル実行です。稼働率、遅延、リージョン要件、契約条件を比較して選びます。
独自データで追加学習する
ファインチューニングではLoRAまたは全パラメータの更新を選べ、教師あり学習や選好データを使うDPOに対応しています。用途に合うJSONLやParquetを作成してアップロードし、検証完了を待ってからモデルと設定を選び、費用見積もりを確認します。
完了後は学習に含めていない事例で元のモデルと比較します。専用エンドポイントへの配置やチェックポイントのダウンロードが可能です。追加学習の入門で流れを確認できますが、精度向上は実測で判断する必要があります。
大規模な学習処理にはKubernetesまたはSlurmと永続ストレージを備えるGPUクラスタもあります。API利用より多くの基盤運用知識が必要です。
データ保存と学習への同意は別の設定
プロンプトと応答の保存は初期状態で有効です。一方、モデル学習への利用は別のオプトインで、初期状態では無効です。組織管理者が保存を無効にすると、以後の推論リクエストにZero Data Retentionを適用でき、passthroughモデルも無効になります。
ZDRの説明では、課金メタデータとアカウント情報は保持されます。Batchや追加学習用にアップロードしたファイルも、削除するまで残ります。過去のデータをさかのぼって削除する設定ではありません。外部事業者へ転送するモデルには、その事業者のデータ方針も関係します。
商用利用前にはモデル個別のライセンスと利用規約を確認してください。オープンモデルでも利用条件は同一ではありません。
よくある質問
APIキーはどこで取得できますか?
プロジェクトのAPI keys設定で作成し、環境変数に保存します。SDKやRESTクライアントにはTogetherのキーを設定してください。
Together AIは無料で使えますか?
一般的な無料トライアルや登録特典を前提にしないでください。現在の資料はプリペイド利用を説明しているため、アカウント条件とモデルの料金を確認します。
同じAPIでモデルを切り替えられますか?
対応するエンドポイントで有効なモデルIDを変更できます。ただし入力形式、コンテキスト、JSON出力、ツール対応は再確認が必要です。
プロンプトはモデル学習に使われますか?
学習利用は別の同意が必要で、初期状態では無効です。保存は初期状態で有効なので、必要なら組織のZDR設定を変更し、アップロードファイルは別途管理します。
公式資料と開発者コミュニティ
- サポート窓口:ヘルプ記事と問い合わせ。
- サービス稼働状況:障害の確認。
- 公式GitHub:SDKと実装例。
- Discordコミュニティ:技術的な情報交換。
- 公式X:製品のお知らせ。
関連ツール
AIモデルAPI・インフラ →
FastRouter一部無料
複数モデルへの接続と利用コストを一つのAPIで管理
teai.io一部無料
複数のAIモデルを共通APIで利用し、円建てで使用量を管理。
eu/jev一部無料
文脈をカテゴリ、確率、順序のあるスコアへ変える独立API。
ソフトウェアが直接扱える型付きの判断と確率を返します。
LLM Gateway一部無料
複数モデルの接続、ルーティング、費用分析を一つに