Navige部分免費
先量測一次任務的成本,再啟用適合的預算與最佳化控制。
Llama:在電腦執行本地 AI 模型與 API
在自己的電腦執行開放模型,用瀏覽器對話,也能讓編輯器與代理程式共用本地 API。
白話解釋:這個網站可以幫你做什麼?
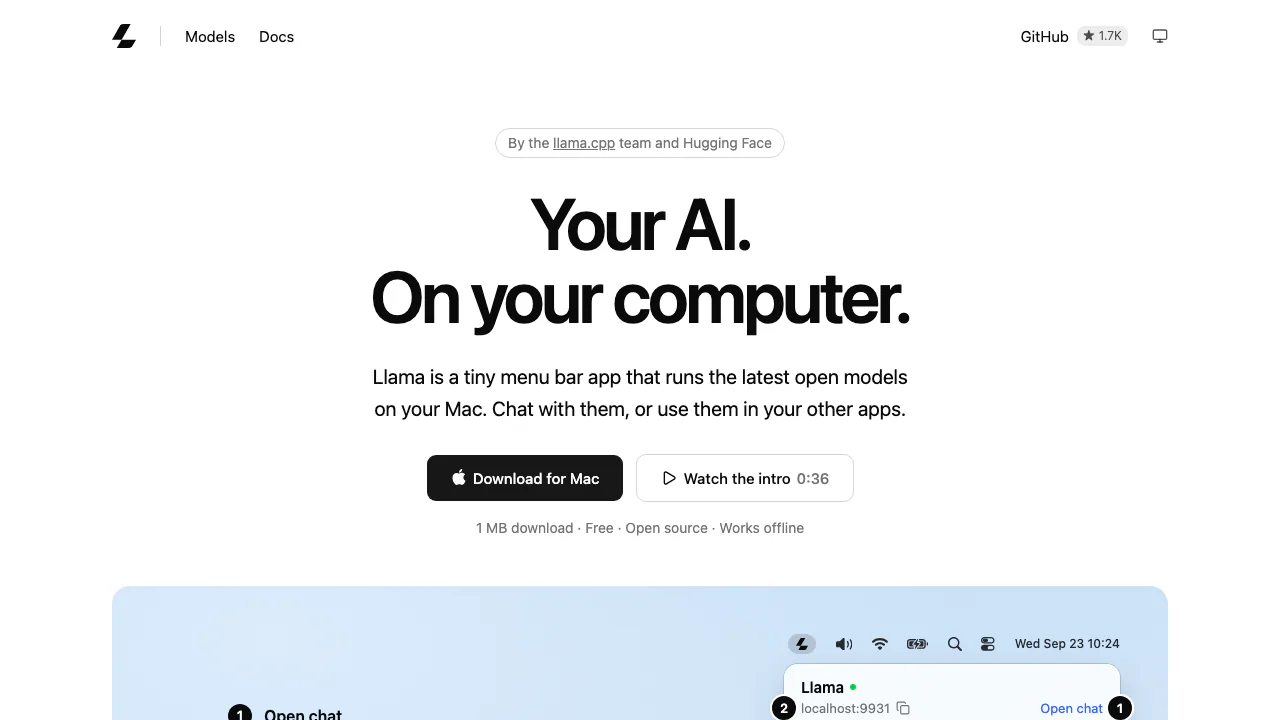
Llama.app 提供 Llama 的下載入口與操作文件。這款免費、開源的應用程式讓你在自己的電腦執行語言模型:下載模型之後,可以直接開啟瀏覽器聊天,也可以讓編輯器、聊天軟體或代理程式透過本地 API 使用模型。官網將專案介紹為由 llama.cpp 團隊與 Hugging Face 推出。
它可視為電腦上的模型執行與管理工具。模型決定回答品質及能理解的內容,Llama 則處理啟動、設定和應用程式連線。適合想用本地 AI 寫作、整理內容的人,也適合需要自備推論服務的開發者。
依記憶體、任務與上下文挑選模型
在挑選模型之前,先確認電腦能提供多少記憶體,以及你會處理多長的對話或文件。模型權重和上下文都會使用資源,因此「檔案能下載」與「任務能順暢完成」是兩個需要分別確認的條件。
Llama 會依硬體推薦模型並自動調整執行設定。官方模型目錄列出不同模型的記憶體建議,可作為挑選起點,不代表整個產品只有一個最低規格。建議以實際的繁體中文問題、程式碼或文件片段測試結果,再選定適合的模型。
下載的模型儲存在與其他工具共用的 Hugging Face 快取,閒置時會從記憶體卸載。官網標示的 Mac 應用下載約 1 MB、安裝約 4 MB,不包含模型權重;規劃磁碟空間時要另外計算模型檔案。
安裝本地 AI,完成第一次對話
- 下載並開啟 Mac 或 Windows 11 應用程式。Mac 也可使用
brew install --cask llama-app。 - 開啟選單列或系統匣圖示,按下推薦模型旁的下載箭頭。
- 下載完成後選取模型,依記憶體與對話需求選擇上下文視窗,再進入聊天。
- 先用短問題確認模型正常回覆,接著嘗試自己的工作內容。
官方快速入門提供操作說明。Linux 使用者可走命令列安裝流程,官網並未提供與 Mac 相同形式的 Linux 桌面應用。軟體和模型必須先備妥,才能測試離線推論。
用圖片與文件提問,保留實用對話
內建 Web UI 可讓視覺模型接收圖片及 PDF,也可讓支援音訊的模型接收 MP3/WAV。純文字模型不會因為放進 Llama 執行,就自動取得看圖或聽音訊的能力。
例如附加一份支援的 PDF,要求整理其中的日期與對應事項,再逐項對照原文;需要摘要時,先說明範圍與輸出格式。這樣比只丟入檔案、要求籠統分析,更容易檢查結果是否符合需求。
對話搜尋、分支與 JSON 匯入匯出,有助於重新找到先前的工作或備份聊天內容。Web UI 文件列出附件格式與對話管理方式。
讓編輯器與代理程式使用本地 API
若客戶端支援自訂 OpenAI 相容服務,可設定基礎位址為 http://localhost:9931/v1。先透過 GET /v1/models 查詢實際模型 ID,再在客戶端選取,避免引用不存在的範例名稱。
API 文件說明串流回覆、結構化輸出、工具呼叫,以及相容 Anthropic 的 Messages 端點。模型和客戶端是否適合某種工作,仍須分別測試,不能只看介面相容性。
在程式開發代理流程中,Llama 提供模型,獨立執行的代理程式負責工具與動作。代理程式接入指南提供設定範例,並建議至少 32k token 的上下文;更長的上下文也會增加資源需求。
免費、離線與隱私的實際界線
截至 2026 年 10 月 27 日,官方將應用程式列為免費、開源,未宣傳本地 API 的 token 計費方案。使用者仍須提供硬體、儲存與電力,另外串接的服務可能有自己的收費。
應用程式的 MIT 授權不等於所有模型都能採相同條件商用。官方目錄也有非商用標示,導入商業專案前應檢查選定模型的授權條件。
必要下載完成後,本地推論可離線運作。Windows 官方儲存庫聲明不傳送遙測,但下載模型與檢查更新仍可能連網。服務預設僅限本機存取;開放網路連線會改變此範圍。若接入其他客戶端、代理工具或外部服務,也要另外確認其資料處理方式。
常見問題
Llama 需要付費訂閱嗎?
目前應用程式免費,未公布本地推論訂閱或 token 費用。自備硬體和外部服務成本仍需自行考量。
沒有網路也能使用嗎?
可以進行本地推論,前提是軟體與模型已經下載。線上工具與更新功能則另外判斷。
要準備多少記憶體?
依模型和上下文長度而定,沒有適用全部情況的統一最低值。可先採用應用程式針對設備的推薦。
使用本地模型,代理程式就完全私密嗎?
不能直接推論。還要確認客戶端、工具呼叫、外部連線與網路開放設定。
官方資源與開發者社群
- Mac 官方儲存庫:程式碼、版本和問題回報。
- Windows 官方儲存庫:Windows 應用、隱私說明和發行版本。
- 命令列操作文件:GGUF 檔案、終端機聊天與執行參數。