
NavigeFreemium
Agentenkosten beobachten und gezielt Regeln, Budgets und Sparfunktionen aktivieren.
Llama: lokale KI für Chats und Anwendungen
Offene Sprachmodelle auf dem eigenen Rechner ausführen und mit anderen Apps verbinden.
Einfach erklärt: Wofür ist Llama.app da?
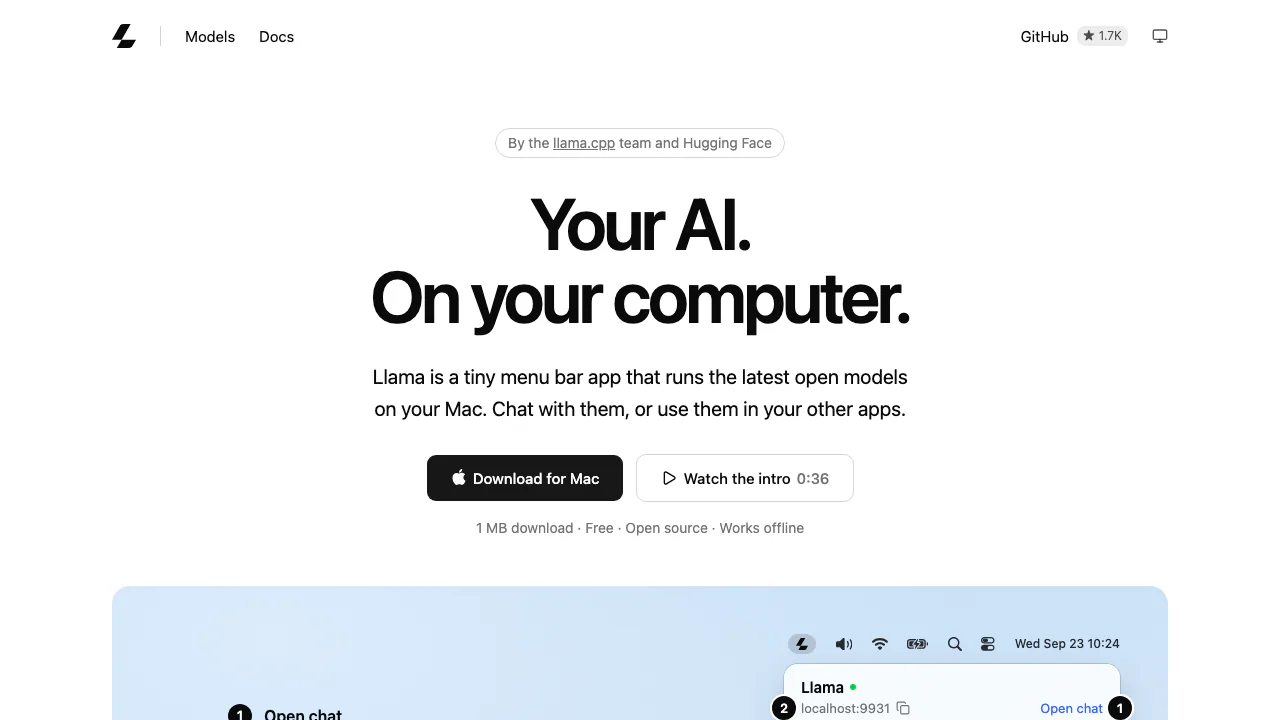
Über Llama.app erhalten Sie eine kostenlose, quelloffene Anwendung, mit der Sprachmodelle auf dem eigenen Computer laufen. Sie laden ein Modell herunter und unterhalten sich damit im Browser. Andere Programme können denselben lokalen Dienst über eine API nutzen. Hinter dem Projekt stehen laut Website das llama.cpp-Team und Hugging Face.
Das ist interessant für eigene Schreib- und Analyseaufgaben sowie für Entwickler, die lokale KI in Editoren oder Agenten verwenden möchten. Welche Antworten und Medien möglich sind, bestimmt auch das ausgewählte Modell.
Lokale KI installieren und den ersten Chat starten
Laden Sie die Mac-App oder die Windows-11-App herunter und öffnen Sie sie. Auf dem Mac ist außerdem die Installation mit brew install --cask llama-app möglich.
Öffnen Sie das Symbol in der Menüleiste beziehungsweise im Infobereich. Über den Downloadpfeil laden Sie eines der empfohlenen Modelle. Anschließend wählen Sie das Modell aus, legen ein zur Speicherausstattung passendes Kontextfenster fest und öffnen den Chat. Beginnen Sie mit einer kurzen Frage und prüfen Sie die Antwort, bevor Sie umfangreiche Aufgaben bearbeiten.
Die offizielle Kurzanleitung zeigt die Schritte. Für Linux verweist die Website auf die Kommandozeile, nicht auf eine gleichartige Desktop-Oberfläche.
Modelle passend zu Arbeitsspeicher und Aufgabe wählen
Modellgröße und Kontextlänge beanspruchen gemeinsam Speicher. Ein großes Kontextfenster kann deshalb auch dann problematisch sein, wenn die Modelldatei grundsätzlich auf den Rechner passt.
Llama schlägt passende Modelle vor und setzt Einstellungen automatisch. Der Modellkatalog nennt je nach Modell unterschiedliche Speicherempfehlungen. Daraus ergibt sich kein allgemeiner Mindestwert für sämtliche Aufgaben.
Modelle liegen im gemeinsamen Hugging-Face-Cache und werden bei Inaktivität aus dem Arbeitsspeicher entladen. Die kleine Downloadgröße der Mac-App umfasst nicht die zusätzlich benötigten Modellgewichte.
Mit Dateien arbeiten und Gespräche weiterverwenden
Die Weboberfläche nimmt Bilder und PDFs für geeignete Vision-Modelle sowie MP3/WAV für Modelle mit Audioeingabe an. Ein reines Textmodell kann dadurch keine Bilder verstehen.
Hängen Sie eine unterstützte Datei an und formulieren Sie eine überprüfbare Aufgabe, etwa das Herausziehen bestimmter Daten. Vergleichen Sie das Ergebnis mit der Vorlage. Suchfunktion, Gesprächsverzweigungen und Import/Export als JSON unterstützen das spätere Weiterarbeiten.
Editoren und Agenten über die lokale API verbinden
Für kompatible Clients lautet die Basisadresse http://localhost:9931/v1. Ermitteln Sie die tatsächliche Modellkennung über GET /v1/models und wählen Sie diese im Client aus.
Die API-Dokumentation beschreibt Streaming, strukturierte Ausgaben, Tool Calling und einen Anthropic-kompatiblen Messages-Endpunkt. Bei einem Coding-Agenten liefert Llama das Modell; der separat gestartete Agent verwaltet Werkzeuge und Aktionen. Nicht jede Modellkombination eignet sich gleich gut dafür.
Kosten, Datenschutz und Grenzen im Alltag
Stand 27. Oktober 2026 ist die Anwendung kostenlos. Für die lokale API bewirbt die Website keine Tokengebühren. Speicherplatz, Hardware und Strom bleiben eigene Kosten. Die MIT-Lizenz der App gilt nicht automatisch für heruntergeladene Modelle; deren Bedingungen sind gesondert zu prüfen.
Lokale Berechnungen funktionieren nach dem Download offline. Updates, neue Modelle und externe Werkzeuge können dennoch Verbindungen benötigen. Das Windows-Projekt erklärt, keine Telemetrie zu senden. Der Server ist standardmäßig nur vom eigenen Gerät erreichbar. Eine Freigabe ins Netzwerk und angeschlossene Programme verändern den Datenschutzumfang.
Häufige Fragen
Ist Llama dauerhaft kostenlos nutzbar?
Aktuell wird die App kostenlos angeboten. Daraus folgt keine Kostenfreiheit für Hardware oder zusätzlich eingebundene Dienste.
Funktioniert der Chat ohne Internet?
Ja, die lokale Inferenz funktioniert mit bereits vorhandenen Modellen offline. Onlinewerkzeuge sind davon getrennt.
Wie viel Arbeitsspeicher brauche ich?
Das hängt vom Modell und Kontextfenster ab. Nutzen Sie die Geräteempfehlungen statt eines pauschalen RAM-Werts.
Bleiben Daten bei Agenten ebenfalls lokal?
Das lässt sich aus dem lokalen Modell allein nicht ableiten. Prüfen Sie auch Client, Werkzeuge und Netzwerkfreigaben.
Offizielle Dokumentation und Entwicklercommunity
- Weboberfläche: Dateiformate und Gesprächsverwaltung.
- Agenten anbinden: Einrichtung kompatibler Clients.
- Mac-Repository und Windows-Repository: Quellcode, Releases und Fehlerberichte.
Ähnliche Tools
KI-Modell-APIs und Infrastruktur →
EdgeeFreemium
Coding-Agenten verbinden, Tokenverbrauch senken und KI-Kosten nachvollziehen.
Together AIKostenpflichtig
KI-Modelle per API nutzen, mit eigenen Daten anpassen und auf Cloud-GPUs bereitstellen.
JevModelFreemium
Text und JSON in definierte Kategorien, Bewertungen und Wahrscheinlichkeiten einordnen.
ReflectionKostenlos
Beam per API nutzen, mit Mirror programmieren oder selbst betreiben.
shimFreemium
Sensible Daten vor Modellaufrufen maskieren und KI-Nutzung nachvollziehen.