
JevModelFreemium
Transformez du texte ou du JSON en catégories, scores et probabilités.
OpenStatus : monitoring site web et page de statut
Monitoring et communication d’incident avec assistance IA
À quoi sert OpenStatus, simplement ?
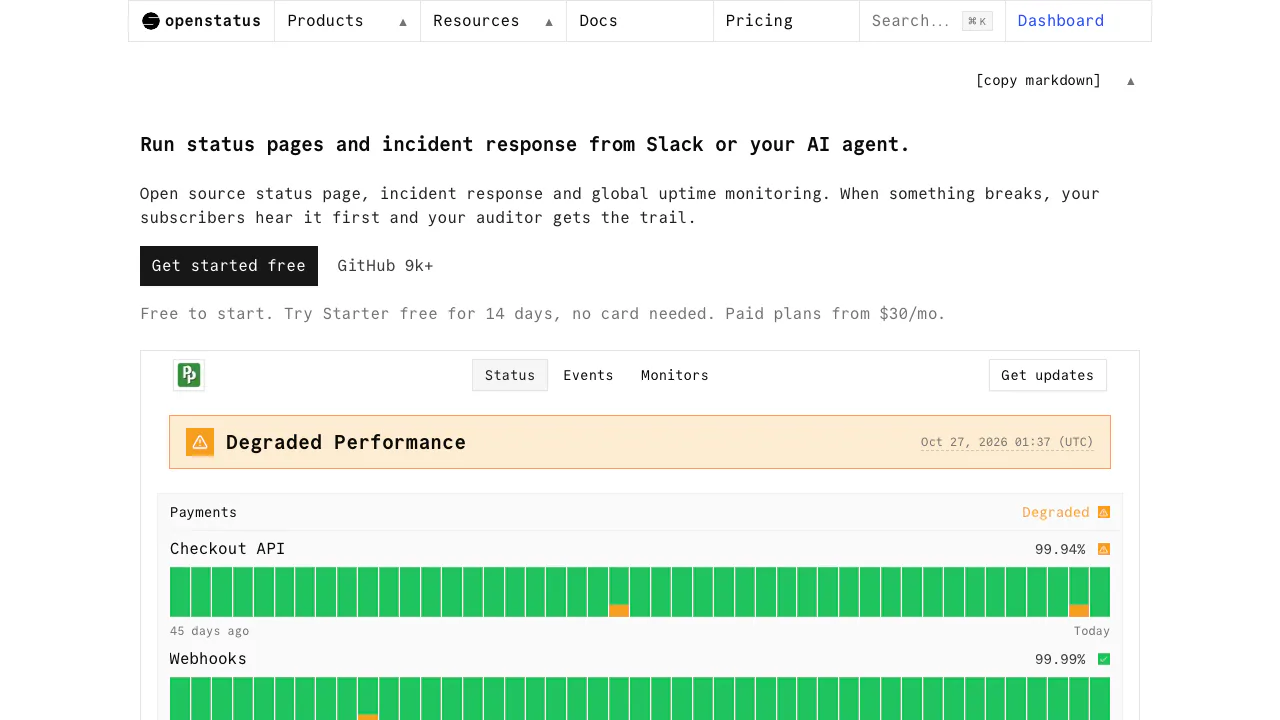
OpenStatus associe le monitoring de site web, une page de statut destinée aux clients et le suivi des incidents. Il vérifie régulièrement un site ou une API, aide à expliquer les interruptions aux utilisateurs et conserve une trace du travail de l’équipe.
Pour une petite équipe SaaS ou d’exploitation, l’intérêt est de relier la détection d’une panne à sa communication. L’IA peut préparer des messages et un compte rendu après incident ; une personne les vérifie. Le produit existe en service hébergé et en code ouvert pour un déploiement autonome.
Gratuit, essai et limites des offres
Vérification du 27 octobre 2026 : Hobby inclut un moniteur, une page de statut de trois composants et un intervalle minimal de dix minutes. L’essai Starter de 14 jours sans carte est distinct.
Les montants mensuels affichés en dollars américains sont de 30 dollars pour Starter, 100 pour Pro et 500 pour Scale. Starter comprend 20 moniteurs, des contrôles à la minute et six régions par moniteur ; Pro propose 50 moniteurs, 30 secondes et 28 régions. Domaine personnalisé, abonnés et agent Slack sont payants. Les tarifs officiels détaillent annuel, options et conditions de facturation ; le montant local final dépend du paiement.
Détecter les pannes et les API trop lentes
Un contrôle HTTP peut définir la méthode, les en-têtes et le corps de la requête. Des assertions vérifient le code HTTP, les en-têtes ou le contenu reçu. Un seuil de latence permet de signaler une dégradation avant le dépassement du délai maximal.
Le réseau hébergé couvre 28 régions chez Fly.io, Koyeb et Railway, avec un nombre de régions par moniteur lié à l’offre. Les mesures régionales et les durées DNS, connexion, TLS, premier octet et transfert facilitent l’analyse. Les alertes peuvent rejoindre Slack, Discord, le courriel, PagerDuty ou un webhook.
Passer du premier moniteur à une page de statut
- Préparez une URL publique et les critères d’une réponse correcte.
- Dans Monitors → Create Monitor, saisissez un nom et l’URL complète, puis réglez requête, assertions et intervalle.
- Enregistrez et vérifiez les graphiques de temps de réponse et de codes HTTP.
- Créez une page de statut avec titre et slug, puis ajoutez les services dans Components.
- Reliez les composants aux moniteurs et ouvrez la page publique pour contrôler le résultat. Les composants statiques restent gérés par les rapports et les maintenances.
Le tutoriel du premier moniteur détaille les écrans actuels. Les rapports publics donnent le contexte d’une panne, tandis que les maintenances planifiées préviennent les utilisateurs à l’avance.
Répondre à un incident depuis Slack ou un agent IA
Sur une offre payante, connectez Slack depuis Settings → Integrations, autorisez le bon espace et invitez le robot dans le canal. Mentionnez @openstatus pour consulter les contrôles ou demander un brouillon. Relisez le message, les services touchés et le choix de notification avant validation. Le guide Slack précise l’installation.
L’incident interne suit gravité, responsable, notes et chronologie. Le rapport public possède son propre statut : résoudre l’incident interne ne résout pas automatiquement la communication publique. Cette fonction est déployée progressivement par espace de travail. Après résolution, l’agent peut proposer un compte rendu à partir des traces disponibles, à modifier et approuver.
Avec MCP, un client IA se connecte par OAuth à un espace avec un accès en lecture ou en lecture-écriture. Les appels de publication exigent un choix explicite de notification ; le client gère la confirmation. CLI, API, SDK et Terraform sont également disponibles.
Hébergement autonome et données traitées
Le guide Docker Compose décrit l’auto-hébergement sous AGPL-3.0. La version complète nécessite ses propres sondes et une configuration analytique ; une version plus légère ne sert que la page de statut. Infrastructure et mises à jour restent à prévoir.
La politique de confidentialité mentionne les URL, en-têtes et corps de requête, identifiants d’intégration et notes d’incident. Les corps de réponse sont collectés si l’option est activée ; la conservation des mesures dépend de l’offre. Vérifiez les données sensibles et les droits des canaux avant raccordement.
Questions fréquentes
Comment fonctionne l’essai gratuit ?
L’essai Starter dure 14 jours et se lance dans Settings → Billing, sans carte. Sans moyen de paiement ajouté, l’espace revient ensuite à Hobby.
Que faire après une alerte de panne ?
Consultez les contrôles en échec, les régions et les réponses, puis vérifiez l’impact réel. Préparez un rapport public si nécessaire et gérez séparément l’avancement interne et le message client.
Une API qui répond 200 est-elle forcément en bonne santé ?
Non. Ajoutez des assertions sur le contenu et des seuils de latence. Le contrôle vérifie les conditions configurées, pas toute la logique métier ni une cause racine certaine.
Ressources officielles et communauté
- Documentation : guides et intégrations.
- GitHub : code, licence et problèmes.
- Discord officiel : échanges techniques.
- Compte X officiel : annonces.
- État du service : disponibilité.
- Contact : assistance et facturation.
Outils similaires
AIOps et réponse aux incidents →
Strawberry BrowserFreemium
Un navigateur de bureau avec des assistants IA pour la recherche, les réunions et les tâches à vérifier dans vos outils web.
KiwiGratuit
Des rappels au bon moment et des démarches après votre accord
Lexmount BrowserFreemium
Rechercher des pages, extraire leur contenu et piloter un navigateur distant
sideOSPayant
Commandes vocales, dictée locale et tâches sur Mac
BasedashPayant
Posez vos questions métier, vérifiez le SQL et construisez des tableaux de bord sur vos données.