
GleapPayant
Reliez les demandes clients aux enquêtes et aux correctifs à valider.
3AM : AIOps pour la gestion des incidents et les causes vérifiées
Enquêter sur les incidents et corriger avec des validations définies par votre équipe.
En clair : à quoi sert 3AM ?
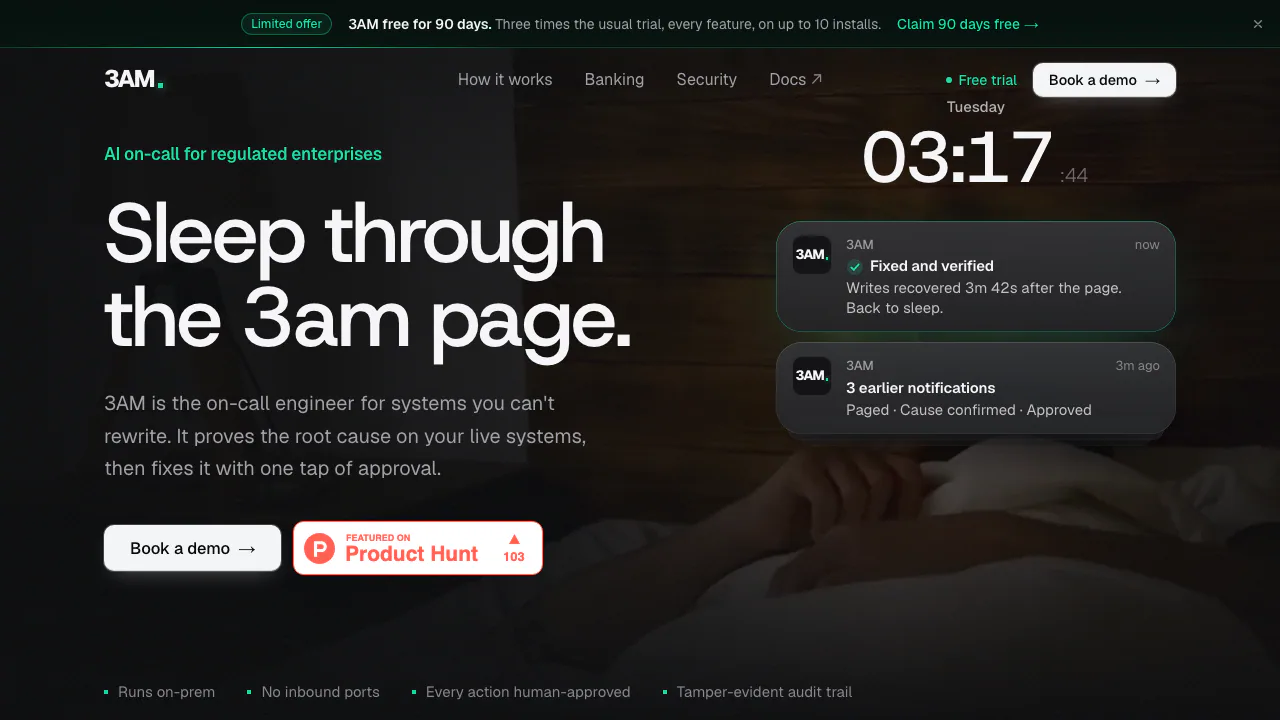
3AM est un outil AIOps de gestion des incidents, installé dans l'infrastructure de l'entreprise. Il reçoit des alertes, recherche leur cause à partir de preuves et prépare une correction. L'équipe détermine s'il doit seulement observer, demander une validation ou exécuter certaines actions autorisées.
Édité par 3AM Super Intelligence Inc., il vise les équipes SRE, plateforme et exploitation, notamment dans les organisations réglementées. Son intérêt est de documenter le passage du symptôme à une réponse vérifiable, avec des responsabilités clairement définies.
Déploiement interne : où vont les données ?
Les incidents et le journal d'audit signé, chaîné par hachage, sont conservés dans un volume local. Les identifiants des connecteurs peuvent être enregistrés dans des fichiers locaux à accès restreint ; ils sont masqués dans les traces d'audit et les éléments transmis aux modèles.
La documentation d'architecture et de sécurité précise cependant qu'un modèle hébergé à l'extérieur reçoit les preuves expurgées de l'enquête. Un traitement entièrement interne nécessite des modèles locaux ou un point de terminaison interne. La vérification de licence peut fonctionner hors ligne. En mode connecté, elle transmet des métadonnées de licence et d'usage, sans envoyer les journaux d'incident à l'éditeur. Les règles de conservation du prestataire de modèle restent à examiner.
Relier l'alerte à une cause démontrée
3AM vérifie les causes connues, puis examine les dépendances, déploiements, changements de configuration, métriques anormales et erreurs. Un runbook ou un modèle peut suggérer une piste ; seules des vérifications sur les systèmes réels permettent de qualifier une cause de démontrée dans le parcours normal de correction. Une hypothèse incertaine ou contestée est transmise à une personne.
Ainsi, des écritures refusées peuvent conduire à vérifier si une base primaire est passée en lecture seule. L'enquête doit établir le lien avec le symptôme et conserver les contrôles effectués. L'IA peut néanmoins se tromper ; les démonstrations de l'éditeur ne constituent pas un délai garanti pour tous les incidents.
Les connecteurs certifiés comprennent notamment Prometheus/Alertmanager, PagerDuty, Kubernetes, MySQL/PostgreSQL, Argo CD et des actions SSH contrôlées. Slack, Grafana et Datadog sont disponibles avec une certification en cours. Chaque connecteur dispose de capacités et de permissions propres. Une API HTTP JSON authentifiée permet également d'intégrer les fonctions de la console.
Définir la marge d'action par service
- Shadow enquête, répète et consigne les propositions sans rien modifier.
- L1 vérifie la cause, répète la correction, sollicite l'accord, exécute et contrôle le résultat.
- L2 autorise en plus des actions expressément considérées comme sûres sans validation individuelle, par exemple un redimensionnement borné ou un redémarrage progressif de Deployment sans état.
L'augmentation d'autonomie nécessite par défaut deux personnes différentes ; sa réduction est immédiate. L'arrêt global bloque les actions sans nécessairement interrompre le diagnostic. Ce périmètre doit être choisi avant de déléguer des changements de production.
Mener un premier pilote en observation
Le serveur doit fonctionner sous Linux x86_64 ou Kubernetes. Le minimum indiqué pour un essai est de 2 vCPU, 4 Go de RAM et 20 Go libres. Les modèles utilisent un GPU ou un endpoint, notamment interne compatible OpenAI ou OpenRouter ; pas d'inférence locale sur CPU. Les runtimes serveur natifs macOS, Windows et ARM ne sont pas pris en charge actuellement.
Avec le guide de démarrage :
- Installez sur Linux et récupérez le code d'essai dans votre messagerie professionnelle.
- Ouvrez le tunnel SSH indiqué et créez le premier propriétaire avec le jeton administrateur initial.
- Connectez Prometheus et Slack ; testez chaque connexion avant de l'enregistrer.
- Lancez Discover en conservant Shadow.
- Envoyez l'alerte de test documentée, consultez Incidents, puis supprimez la règle de test.
Une alerte artificielle sans cause réelle doit être remise à une personne. Comparez ensuite les propositions aux décisions de l'équipe avant de demander L1 pour certains services.
Essai et licence : vérifier la couverture
Vérifié le 20 octobre 2026 : l'offre limitée porte l'essai habituel de 30 à 90 jours, avec toutes les fonctions et jusqu'à dix installations, une fois par entreprise avec une adresse professionnelle.
Le guide des licences distingue Starter pour 50 services, Enterprise pour 250 services extensibles et jusqu'à dix installations, et Strategic sans limite de couverture. Toutes les offres incluent un nombre illimité de personnes. Aucun tarif monétaire universel n'est publié ; prix, assistance et durée sont à confirmer. Il s'agit d'une licence commerciale pour les opérations internes, pas d'une gratuité permanente.
Questions fréquentes
Que fait 3AM si la cause reste incertaine ?
Il transmet l'incident et les preuves recueillies à une personne. Une suggestion du modèle ne suffit pas à démontrer une cause.
Les corrections demandent-elles une validation ?
En L1, oui. Shadow n'apporte aucun changement. Le niveau L2, activé séparément, peut exécuter certaines actions sûres automatiquement.
Les données restent-elles toujours sur place ?
Les enregistrements sont locaux, mais un endpoint externe reçoit les éléments d'enquête masqués. Il faut donc examiner aussi le choix du modèle.
Ressources officielles
- Connecteurs : permissions, actions et certification.
- Référence HTTP API : authentification et intégration.
- Essai et démonstration : préparer un pilote et demander les conditions commerciales.
Outils similaires
AIOps et réponse aux incidents →
readywhenGratuit
Retrouvez les engagements pris par mail, en réunion ou dans les échanges.
ToriFreemium
Un support produit documenté, avec votre équipe dans la conversation.
Inbox ZeroFreemium
Triez les e-mails, préparez vos réponses et faites le ménage dans les newsletters.
Craft AgentsGratuit
Reliez vos agents IA aux fichiers, API, MCP et tâches web.
NitroStackFreemium
Un SDK TypeScript, des tests visuels et un hébergement pour vos outils MCP.