

AIsaBetaald
Eén API-sleutel voor modellen en externe gegevensbronnen.
LLM Gateway: model-API, routering en kosten
Eén API voor modeltoegang, routering en inzicht in kosten
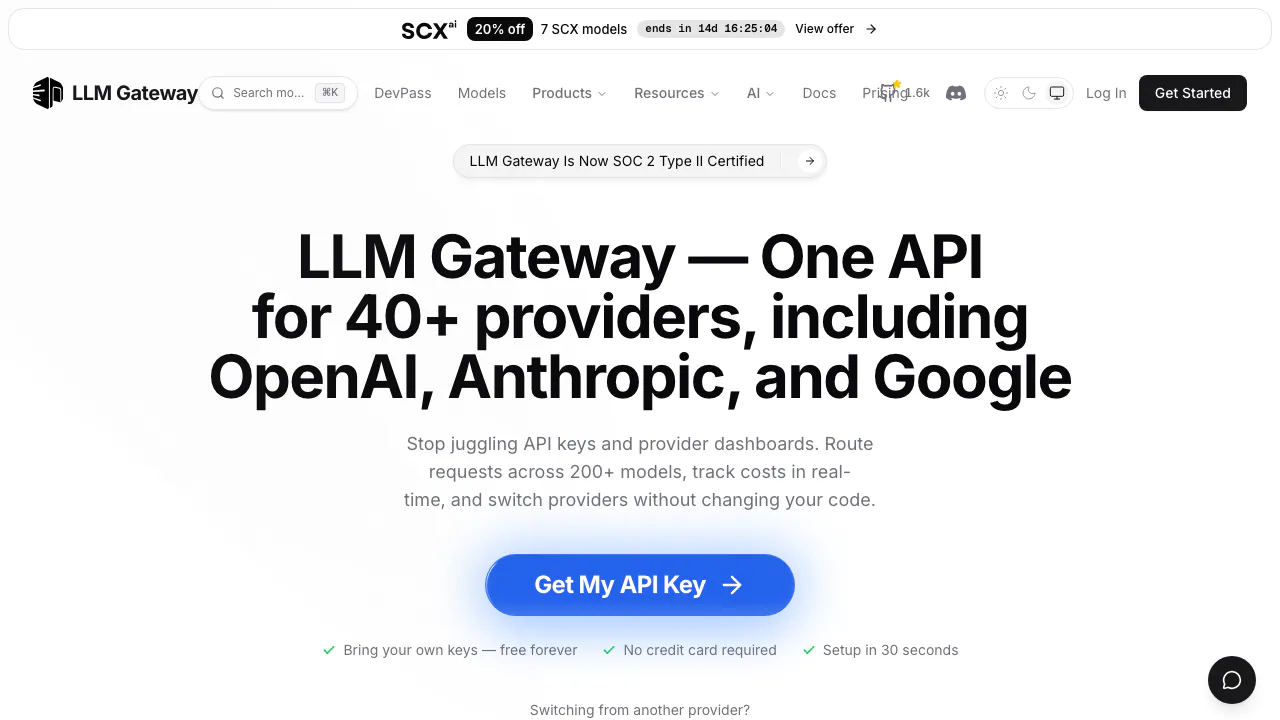
LLM Gateway is een opensource API-gateway waarmee ontwikkelaars meerdere aanbieders van taalmodellen op één toepassing aansluiten. De dienst bundelt routering, sleutels en gebruiksanalyses. Dat helpt wanneer afzonderlijke SDK's en facturatieoverzichten het beheer van een AI-product onnodig ingewikkeld maken.
Wat doet LLM Gateway in gewone taal?
Een klantenservice-app kan het ene model gebruiken om vragen te ordenen en het andere om antwoorden te schrijven. LLM Gateway ontvangt de aanvragen, stuurt ze door naar een modelaanbieder en geeft het resultaat terug. Tegelijk ontstaat een centrale plek om kosten en vertraging te bekijken.
De gateway is infrastructuur en geen zelfstandig taalmodel. Polar Lights LLC beheert het product. Het is vooral bedoeld voor ontwikkelaars en platformteams; de aparte Lounge biedt een browseromgeving om modellen uit te proberen.
Van API-sleutel naar een gecontroleerde aanvraag
Gebruik de officiële snelstart:
- Log in, maak een project en verkrijg een gateway-API-sleutel. Bewaar die aan de serverkant.
- Kies vooraf betaalde credits of voeg eigen aanbiedersleutels toe via Provider Keys. De gateway-sleutel en aanbiedersleutel hebben verschillende functies.
- Selecteer een beschikbaar model en controleer invoer, mogelijkheden en contextlimiet.
- Stel
https://api.llmgateway.io/v1in als basis-URL van een OpenAI-compatibele client. Een HTTP-aanvraag naar/chat/completionsbevatmodel,messagesen Bearer-authenticatie. - Controleer het antwoord en bekijk daarna aanbieder, tokens, vertraging en kosten in het dashboard.
Test herkenbare praktijksituaties voordat je productieaanvragen omzet. Dezelfde API-indeling betekent niet dat alle modellen dezelfde parameters en functies ondersteunen.
Modellen wisselen en fouten opvangen
Eén integratie maakt het eenvoudiger om modellen voor verschillende taken te vergelijken. Routering kan een beschikbare aanbieder selecteren en een mislukte aanvraag opnieuw proberen via een geschikte andere aanbieder. De routeringsregels blijven afhankelijk van beschikbare routes en limieten; ze garanderen geen foutloze dienst.
Gebruiksanalyses helpen dure modellen en trage aanvragen vinden. Limieten en toegangsregels per sleutel ondersteunen gescheiden toepassingen en beperkingen op modellen of aanbieders. Caching kan herhaald werk verminderen. Antwoordcaching in de gateway en promptcaching bij de aanbieder zijn echter verschillende systemen, met eigen voorwaarden en configuratie.
Wat betaal je voor gebruik?
Gecontroleerd op 10 september 2026: bij standaard gehost BYOK-gebruik zijn er geen platformkosten voor routering, maar betaal je de modelaanbieder voor inferentie. De prijs-FAQ noemt 5% kosten bij het kopen van credits. Optionele opslag van volledige inhoud kost daarnaast USD 0,01 per miljoen tokens. Voor kaarten van buiten de VS noemt de prijspagina 1,5% internationale kosten; Enterprise is op offerte.
Bekijk de actuele tarieven en reken met werkelijke invoer- en uitvoertokens. Een gratis account maakt betaalde modellen niet gratis. DevPass en chatabonnementen hebben aparte voorwaarden. De dollarbedragen zijn geen Nederlandse eurotarieven en bevestigen geen lokale betaalmogelijkheden.
Zelf hosten vraagt ook beheer
De self-hostingdocumentatie behandelt Docker, Compose en Kubernetes. De omgeving bestaat uit applicatiediensten, PostgreSQL, Redis en aanbiedersleutels. Je team beheert dan onder meer updates, back-ups en toegangsrechten.
De gateway gebruikt AGPLv3; enterprisefuncties in ee/ hebben een afzonderlijke commerciële licentie. Zelf hosten past bij teams die infrastructuurcontrole willen en de omgeving kunnen onderhouden. Het betekent niet dat modellen lokaal draaien: externe aanbieders blijven hun aanvragen zelf verwerken.
Bewaarbeleid en gebruikslimieten begrijpen
Standaard worden alleen metadata bewaard. Standaardorganisaties kunnen volledige inhoud laten opslaan. De Responses API vormt een uitzondering: opgeslagen antwoorden blijven onafhankelijk van deze instelling 30 dagen bewaard. Met store: false schakel je die opslag uit. Controleer de bewaarregels.
Volgens het privacybeleid gebruikt de gateway klantinhoud niet voor modeltraining. Gekozen aanbieders hanteren hun eigen beleid. Er gelden ook organisatie-, gelijktijdigheids- en aanbiederslimieten. Gratis modellen hebben quota die samenhangen met de creditstatus. Handel 429-antwoorden af met wachttijden en begrensde gelijktijdigheid.
Veelgestelde vragen
Is de gateway gratis?
BYOK-routering wel; modelgebruik kan bij de aanbieder kosten opleveren. Credits en optionele volledige opslag worden apart berekend.
Kan mijn bestaande OpenAI-client blijven werken?
Gebruik de compatibele API met de nieuwe basis-URL, gateway-sleutel en ondersteunde model-ID. Controleer modelgebonden functies eerst.
Blijft bij zelf hosten alles op mijn server?
Nee. Je host de gateway, terwijl een externe aanbieder doorgestuurde aanvragen blijft verwerken.
Worden prompts nooit opgeslagen?
Dat is te algemeen. Naast optionele inhoudsopslag heeft de Responses API een aparte termijn van 30 dagen en de optie store: false.
Officiële bronnen en ontwikkelaarscommunity
- Documentatie: API-functies en integratie.
- GitHub: code, licenties en problemen melden.
- Discord: vragen aan team en ontwikkelaars.
- Servicestatus: storingen en beschikbaarheid.
Vergelijkbare tools
AI-model-API’s en infrastructuur →
Experiential LabsFreemium
Beheer modelaanvragen, sleutels en verbruik via één gezamenlijke API.
TrustedRouterBetaald
Een privacygerichte, OpenAI-compatibele gateway voor meerdere AI-modellen en providers.
TavilyFreemium
Doorzoek, extraheer, crawl en onderzoek het actuele web voor AI-agenten via één API
FirecrawlFreemium
Zet websites om in schone Markdown of gestructureerde data voor AI-agents, RAG en automatisering.
OpenRouterFreemium
Geünificeerde API-gateway voor toonaangevende AI-modellen