

AIsaPayant
Un accès commun aux modèles et aux API de données pour vos agents.
LLM Gateway : API unifiée, routage et coûts
Une API pour connecter les modèles et suivre leur coût
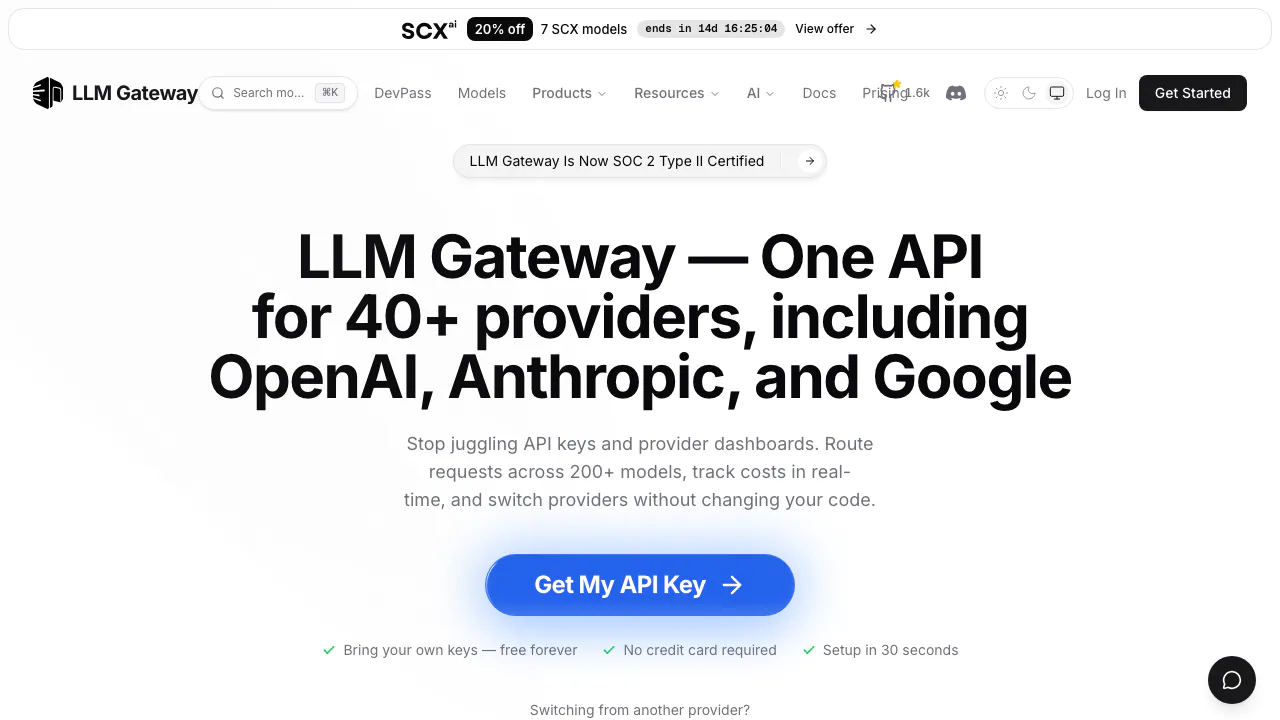
LLM Gateway est une passerelle API open source destinée aux applications qui utilisent plusieurs fournisseurs de modèles de langage. Elle centralise les appels, le routage et le suivi de consommation. Les équipes peuvent ainsi changer de modèle et analyser leurs dépenses sans multiplier les intégrations et tableaux de bord.
À quoi sert LLM Gateway, concrètement ?
Prenons une application d'assistance qui classe une demande avec un modèle, puis prépare une réponse avec un autre. Elle envoie ses requêtes à LLM Gateway. La passerelle les transmet au fournisseur choisi et renvoie le résultat, tout en permettant de consulter coût et latence.
Il s'agit d'une couche d'infrastructure, pas d'un modèle qui répond de façon autonome. Exploité par Polar Lights LLC, le service vise surtout les développeurs et les équipes plateforme. L'interface distincte Lounge permet également d'essayer des modèles dans un navigateur.
Brancher une application et vérifier le résultat
Le guide de démarrage détaille cette procédure :
- Se connecter au tableau de bord, créer un projet et récupérer une clé API de la passerelle. La conserver côté serveur.
- Utiliser des crédits ou enregistrer ses clés de fournisseur dans Provider Keys. Ces dernières servent à joindre le fournisseur, tandis que la clé du gateway authentifie l'application.
- Choisir un identifiant de modèle disponible et vérifier ses capacités ainsi que sa fenêtre de contexte.
- Définir
https://api.llmgateway.io/v1comme URL de base du client compatible OpenAI. Un appel HTTP à/chat/completionstransmetmodeletmessagesen JSON avec authentification Bearer. - Vérifier la réponse puis les tokens, le fournisseur, la latence et le coût dans le tableau de bord.
Testez des exemples représentatifs avant la mise en production. Une interface commune n'implique pas que tous les modèles acceptent les mêmes paramètres ou outils.
Comparer les modèles et prévoir les défaillances
L'intégration commune facilite l'évaluation de plusieurs modèles. Le routage peut choisir un fournisseur disponible et retenter un appel auprès d'une autre option admissible en cas d'erreur. Les règles de routage restent liées aux fournisseurs accessibles et à leurs limites : elles ne garantissent pas une disponibilité absolue.
Les analyses servent à repérer les modèles coûteux et les appels lents. Les plafonds et règles d'accès associés aux clés aident à isoler les applications et à restreindre les fournisseurs autorisés. Le cache peut éviter certains traitements répétés, mais le cache de réponses du gateway diffère du cache de prompts du fournisseur. Le gain dépend de la configuration et des requêtes.
Comprendre les frais avant de choisir
Vérification du 10 septembre 2026 : sur l'offre hébergée standard, le routage BYOK est sans frais de plateforme ; l'inférence reste facturée par le fournisseur. La FAQ tarifaire indique 5 % de frais lors de l'achat de crédits. La conservation facultative des contenus complets ajoute 0,01 USD par million de tokens. La page mentionne aussi 1,5 % de frais internationaux pour les cartes non américaines ; Enterprise est sur devis.
Consultez les tarifs actuels avec votre consommation réelle de tokens d'entrée et de sortie. Le compte gratuit ne rend pas tous les modèles gratuits. DevPass et les abonnements de chat ont leurs propres conditions. Les montants en USD ne constituent ni un tarif en euros ni une confirmation des moyens de paiement disponibles en France.
Auto-hébergement : contrôle et responsabilités
Le guide d'auto-hébergement propose Docker, Compose et Kubernetes. Le système comprend les services applicatifs, PostgreSQL, Redis et les identifiants des fournisseurs. Sauvegardes, mises à jour, exploitation et permissions deviennent la responsabilité de votre équipe.
Le code du gateway est sous AGPLv3 ; les fonctions d'entreprise du répertoire ee/ relèvent d'une licence commerciale distincte. Cette option convient aux équipes capables d'administrer leur infrastructure. Héberger la passerelle ne rend pas l'inférence locale : les appels vers un fournisseur externe restent traités chez lui.
Conservation des données et limites d'appels
Les métadonnées seules sont conservées par défaut. Les organisations standard peuvent activer la conservation complète. Attention à la Responses API : ses réponses stockées sont conservées 30 jours indépendamment de ce réglage ; store: false permet de désactiver ce stockage. Les règles de conservation expliquent cette exception.
La politique de confidentialité indique que le gateway n'utilise pas les contenus clients pour entraîner des modèles. Chaque fournisseur conserve ses propres règles. Vérifiez aussi les limites d'organisation, de concurrence et de fournisseur. Les modèles gratuits dépendent du statut des crédits ; les erreurs 429 nécessitent une temporisation et une concurrence maîtrisée.
Questions fréquentes
LLM Gateway est-il gratuit ?
Le routage BYOK l'est, mais l'inférence du fournisseur reste payante selon ses tarifs. Crédits et stockage facultatif entraînent des frais distincts.
Puis-je garder mon intégration OpenAI ?
L'API compatible s'utilise avec la nouvelle URL de base, une clé gateway et un modèle pris en charge. Testez ses capacités avant migration.
L'auto-hébergement garde-t-il tous les traitements chez moi ?
Non. Il héberge la passerelle, tandis qu'un modèle externe traite toujours les requêtes chez son fournisseur.
Les prompts ne sont-ils jamais stockés ?
Ce n'est pas une règle générale. La Responses API a notamment sa propre conservation de 30 jours, désactivable avec store: false.
Ressources officielles et communauté
- Documentation : intégration et fonctions API.
- GitHub : code, licences et signalement de bugs.
- Discord officiel : échanges avec l'équipe et les développeurs.
- État du service : incidents et disponibilité.
Outils similaires
API et infrastructure de modèles IA →
Experiential LabsFreemium
Un point d’accès commun pour les modèles IA, leurs routes et leurs coûts.
TrustedRouterPayant
Une passerelle compatible OpenAI pour router des requêtes entre modèles avec des contrôles de confidentialité vérifiables.
TavilyFreemium
Recherchez, extrayez, explorez et analysez le Web en direct pour des agents IA via une API
FirecrawlFreemium
Transformez des sites en Markdown propre ou en données structurées pour agents IA, RAG et automatisations.
OpenRouterFreemium
Passerelle API unifiée pour modèles d'IA avancés