

AIsaPago
Uma chave API para modelos, pesquisa e fontes de dados externas.
LLM Gateway: API unificada, modelos e custos
Uma API para conectar modelos e acompanhar os custos
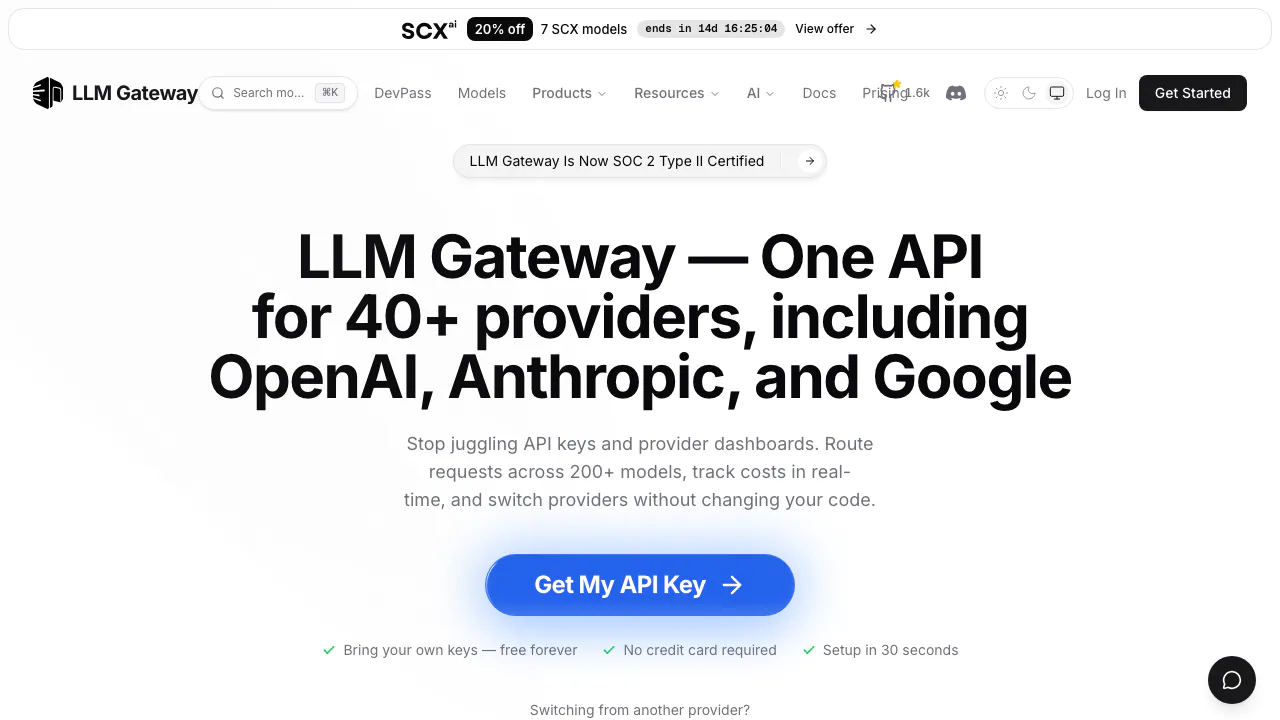
LLM Gateway é um gateway de API de código aberto para conectar aplicações a diferentes fornecedores de modelos de linguagem. Ele reúne roteamento, gerenciamento de chaves e análise de consumo, ajudando equipes que precisam comparar modelos e acompanhar gastos sem manter várias integrações separadas.
Para que serve o LLM Gateway, na prática?
Pense em um atendimento automatizado: um modelo classifica a solicitação e outro escreve a resposta. O aplicativo envia as chamadas ao LLM Gateway, que encaminha cada uma ao fornecedor e devolve o resultado. Nesse ponto central, também é possível consultar custo e latência.
Ele é uma camada de infraestrutura, não um modelo que responde sozinho. A operação é da Polar Lights LLC, com foco em desenvolvedores e equipes de plataforma. A interface separada Lounge permite experimentar modelos no navegador.
Conecte o aplicativo e confira a primeira chamada
O guia de início orienta o processo:
- Entre no painel, crie um projeto e obtenha uma chave de API do gateway. Armazene-a no servidor.
- Escolha créditos ou adicione suas chaves de fornecedores em Provider Keys. A chave do gateway autentica o aplicativo; a do fornecedor conecta a conta usada na inferência.
- Selecione um modelo disponível e confira suas capacidades, entradas e limite de contexto.
- Configure
https://api.llmgateway.io/v1como URL base do cliente compatível com OpenAI. Em HTTP, enviemodelemessagespara/chat/completions, com autenticação Bearer. - Verifique a resposta e depois confira fornecedor, tokens, latência e custo no painel.
Teste exemplos reais antes de migrar o tráfego de produção. Uma API compatível não torna iguais os parâmetros e recursos de todos os modelos.
Troque modelos e lide com falhas de fornecedores
A integração única facilita avaliar modelos para tarefas diferentes. O roteamento pode escolher um fornecedor disponível e repetir uma chamada com falha por outra alternativa elegível. As regras de roteamento dependem da disponibilidade e dos limites dos fornecedores; não garantem ausência total de falhas.
As análises ajudam a localizar modelos caros e chamadas lentas. Limites de uso e regras por chave permitem separar aplicativos e restringir modelos ou fornecedores. O cache pode reduzir trabalho repetido, mas o cache de respostas do gateway é diferente do cache de prompts do fornecedor. O benefício depende da configuração e da carga de trabalho.
Gratuito, BYOK e créditos: entenda a cobrança
Verificado em 10 de setembro de 2026: no serviço hospedado padrão, o roteamento BYOK não tem taxa de plataforma, e a inferência é paga diretamente ao fornecedor. A FAQ de preços informa taxa de 5% na compra de créditos. O armazenamento opcional de conteúdo completo adiciona US$ 0,01 por milhão de tokens. A página também lista taxa internacional de 1,5% para cartões de fora dos EUA; Enterprise exige cotação.
Consulte os preços atuais e estime tokens de entrada e saída. Conta gratuita não significa acesso gratuito a todos os modelos. DevPass e planos de chat têm regras próprias. Esses valores em dólar não constituem preço final em reais nem confirmação de todos os meios de pagamento no Brasil.
Quando hospedar na sua infraestrutura
A documentação de hospedagem própria oferece Docker, Compose e Kubernetes. A estrutura inclui serviços da aplicação, PostgreSQL, Redis e credenciais dos fornecedores. A equipe assume operação, backups, atualizações e permissões.
O gateway usa AGPLv3; funcionalidades empresariais em ee/ têm licença comercial separada. Hospedagem própria é adequada para quem precisa de controle e consegue operar a estrutura. Ela não executa automaticamente os modelos no seu servidor: fornecedores externos continuam processando as chamadas encaminhadas.
Confira retenção de dados e limites
Por padrão, são guardados metadados. Organizações padrão podem ativar o armazenamento completo. Há uma exceção na Responses API: respostas armazenadas ficam por 30 dias independentemente desse ajuste; store: false desativa esse armazenamento. Consulte as regras de retenção.
A política de privacidade diz que o gateway não treina modelos com o conteúdo dos clientes. Cada fornecedor aplica sua própria política. Também existem limites de organização, concorrência e fornecedor; a cota de modelos gratuitos depende do estado dos créditos. Trate erros 429 com espera e controle de chamadas simultâneas.
Perguntas frequentes
Posso usar de graça?
O roteamento BYOK é gratuito, mas o fornecedor pode cobrar pela inferência. Créditos e armazenamento completo opcional têm cobranças separadas.
Minha integração OpenAI pode continuar funcionando?
Use a API compatível com nova URL base, chave do gateway e modelo suportado. Teste os recursos específicos antes de migrar.
Hospedagem própria mantém todo o processamento local?
Não. Ela hospeda o gateway; modelos externos continuam processando requisições no fornecedor.
Os prompts nunca são armazenados?
Não é uma regra geral. A Responses API tem retenção própria de 30 dias e permite desativá-la com store: false.
Recursos oficiais e comunidade
- Documentação: API e integração.
- GitHub: código, licenças e problemas.
- Discord oficial: ajuda da equipe e comunidade.
- Status do serviço: incidentes operacionais.
Ferramentas parecidas
APIs e infraestrutura de modelos de IA →
Experiential LabsFreemium
Conecte modelos por uma única API e acompanhe chaves, rotas e gastos.
TrustedRouterPago
Gateway compatível com OpenAI para rotear solicitações entre modelos com controles verificáveis de privacidade.
TavilyFreemium
Pesquise, extraia, rastreie e investigue a web atual para agentes de IA por uma API
FirecrawlFreemium
Converta sites em Markdown limpo ou dados estruturados para agentes de IA, RAG e automações.
OpenRouterFreemium
Gateway de API unificada e roteador para modelos de IA