

AIsaPłatne
Modele i zewnętrzne dane dostępne przez jeden klucz API.
LLM Gateway: API modeli, routing i koszty
Jedno API do modeli, routingu i kontroli kosztów
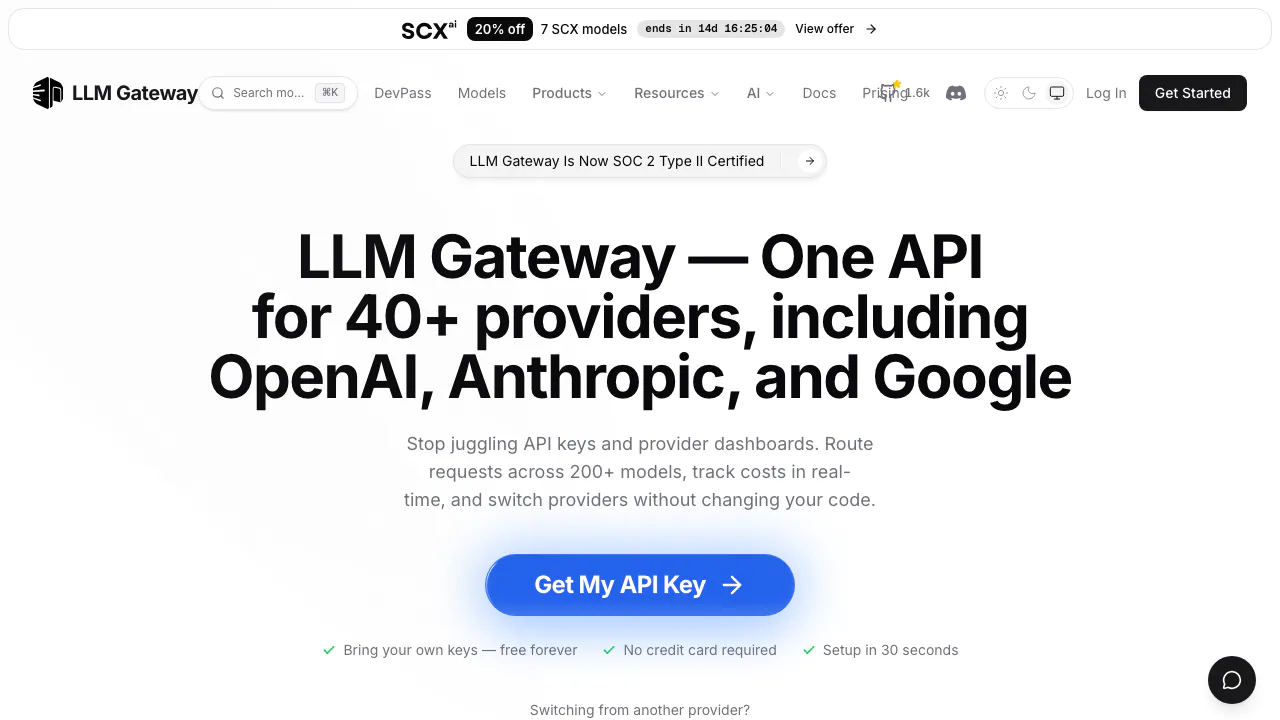
LLM Gateway to otwarta brama API dla aplikacji korzystających z wielu dostawców modeli językowych. Łączy routing, zarządzanie kluczami i analizę zużycia. Pomaga zespołom, które chcą zmieniać modele bez utrzymywania osobnych integracji i zestawiać koszty w jednym miejscu.
Do czego służy LLM Gateway? Prosty przykład
Aplikacja obsługi klienta może klasyfikować wiadomość jednym modelem, a przygotowywać odpowiedź drugim. LLM Gateway przyjmuje jej żądania, przekazuje je dostawcom i zwraca wyniki. Pozwala też sprawdzić koszt i czas pojedynczego wywołania.
To warstwa infrastruktury, a nie samodzielny model. Operatorem jest Polar Lights LLC. Głównymi odbiorcami są programiści i zespoły platformowe; osobny interfejs Lounge umożliwia testowanie modeli w przeglądarce.
Jak wykonać pierwsze żądanie
Skorzystaj z oficjalnego przewodnika:
- Zaloguj się, utwórz projekt i uzyskaj klucz API bramy. Przechowuj go po stronie serwera.
- Wybierz kredyty albo dodaj własne klucze dostawców w Provider Keys. Klucz bramy uwierzytelnia aplikację, a klucz dostawcy daje dostęp do konta u niego.
- Wybierz dostępny identyfikator modelu i sprawdź jego możliwości oraz limit kontekstu.
- Ustaw adres bazowy klienta zgodnego z OpenAI na
https://api.llmgateway.io/v1. Żądanie HTTP do/chat/completionszawieramodel,messagesi uwierzytelnienie Bearer. - Sprawdź odpowiedź, a następnie dostawcę, tokeny, opóźnienie i koszt w panelu.
Przetestuj typowe dane przed przeniesieniem ruchu produkcyjnego. Zgodność API nie oznacza identycznych funkcji wszystkich modeli.
Routing, ponawianie i kontrola aplikacji
Wspólna integracja ułatwia porównywanie modeli. Brama może wybrać dostępnego dostawcę, a po błędzie ponowić żądanie przez inną odpowiednią trasę. Dokumentacja routingu opisuje zasady; skuteczność zależy od dostępności dostawców i ich limitów, więc nie jest gwarancją nieprzerwanej pracy.
Analizy wskazują drogie modele i wolne wywołania. Limity zużycia oraz reguły dostępu dla kluczy pomagają oddzielić aplikacje i ograniczać dostępne modele lub dostawców. Cache może zmniejszyć powtarzaną pracę, lecz cache odpowiedzi bramy różni się od cache promptów dostawcy i zależy od konfiguracji.
Co jest bezpłatne, a za co zapłacisz?
Stan na 10 września 2026 r.: standardowa usługa hostowana nie pobiera opłaty za routing BYOK; koszt inferencji rozlicza dostawca. FAQ cenowe wskazuje 5% opłaty przy zakupie kredytów. Opcjonalne przechowywanie pełnej treści kosztuje dodatkowo 0,01 USD za milion tokenów. Dla kart spoza USA strona podaje 1,5% opłaty międzynarodowej. Enterprise wymaga wyceny.
Sprawdź aktualne ceny, uwzględniając tokeny wejściowe i wyjściowe. Darmowe konto nie zapewnia darmowych wywołań wszystkich modeli. DevPass i abonamenty czatu mają własne warunki. Kwoty w USD nie są cennikiem w złotych ani potwierdzeniem lokalnych metod płatności.
Własny hosting: większa kontrola i obowiązki
Instrukcja wdrożenia obejmuje Docker, Compose i Kubernetes. Potrzebne są usługi aplikacyjne, PostgreSQL, Redis i klucze dostawców. Zespół odpowiada za utrzymanie, kopie zapasowe, aktualizacje i uprawnienia.
Kod bramy jest na AGPLv3, a funkcje enterprise w ee/ mają osobną licencję komercyjną. Własny hosting pasuje do zespołów z kompetencjami operacyjnymi. Nie przenosi jednak modeli automatycznie na Twój serwer: zewnętrzny dostawca nadal przetwarza skierowane do niego żądania.
Retencja danych i limity przed produkcją
Domyślnie zapisywane są metadane; standardowa organizacja może włączyć pełne treści. Responses API ma wyjątek: zapisane odpowiedzi są przechowywane przez 30 dni niezależnie od tej opcji. Użyj store: false, aby wyłączyć ten zapis. Szczegóły zawierają zasady retencji.
Polityka prywatności deklaruje, że brama nie używa treści klientów do trenowania modeli. Dostawcy stosują własne zasady. Sprawdź też limity organizacji, równoległości i dostawców. Darmowe modele mają limity zależne od statusu kredytów. Obsługuj błędy 429 przez odczekanie i ograniczenie równoległych żądań.
Częste pytania
Czy LLM Gateway jest darmowy?
Routing BYOK jest bezpłatny, ale inferencja u dostawcy może kosztować. Kredyty i opcjonalne pełne przechowywanie są rozliczane oddzielnie.
Czy zachowam integrację OpenAI?
Możesz użyć zgodnego API po zmianie adresu, klucza i modelu. Najpierw sprawdź wymagane możliwości.
Czy własny hosting oznacza lokalne przetwarzanie wszystkiego?
Nie. Hostujesz bramę, natomiast zewnętrzny model nadal działa u dostawcy.
Czy prompty nigdy nie są zapisywane?
Nie jest to uniwersalna zasada. Responses API ma osobną retencję 30 dni i opcję store: false.
Oficjalne materiały i społeczność
- Dokumentacja: API i integracje.
- GitHub: kod, licencje i zgłoszenia.
- Discord: pomoc zespołu i programistów.
- Status usługi: informacje o awariach.
Podobne narzędzia
API modeli AI i infrastruktura →
Experiential LabsFreemium
Jedno API do modeli AI, z kontrolą kluczy, tras i kosztów wywołań.
TrustedRouterPłatne
Zgodna z OpenAI brama do wielu modeli, z routingiem dostawców i sprawdzalnymi kontrolami prywatności.
TavilyFreemium
Wyszukuj, wyodrębniaj, indeksuj i analizuj aktualny web dla agentów AI przez jedno API
FirecrawlFreemium
Zmieniaj strony w czysty Markdown lub dane strukturalne dla agentów AI, systemów RAG i automatyzacji.
OpenRouterFreemium
Zunifikowana brama API dla wiodących modeli AI