

AIsaDe pago
Conecta modelos y datos externos con una sola clave API.
LLM Gateway: API unificada, modelos y costes
Una API para conectar modelos y controlar el consumo
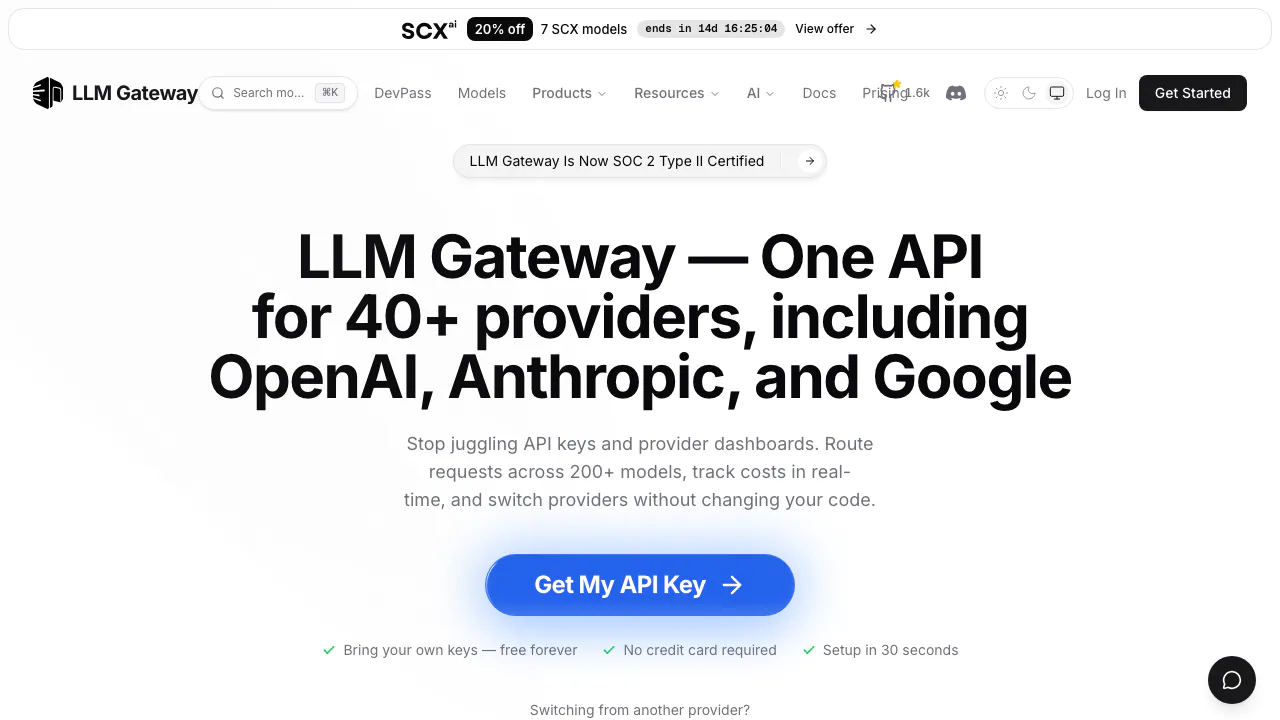
LLM Gateway es una pasarela API de código abierto que conecta aplicaciones con varios proveedores de modelos de lenguaje. Reúne el enrutamiento, las claves y el análisis del consumo para que un equipo pueda incorporar modelos sin mantener una integración y un panel de costes independientes para cada proveedor.
¿Para qué sirve LLM Gateway? Una explicación sencilla
Imagina un servicio de atención al cliente que usa un modelo para clasificar consultas y otro para redactar respuestas. La aplicación envía las solicitudes a LLM Gateway, que las dirige al proveedor correspondiente y devuelve el resultado. Esa capa intermedia también permite ver cuánto cuesta cada llamada y cuánto tarda.
No es un modelo que genere respuestas por sí solo. Es infraestructura para desarrolladores y equipos de plataforma, operada por Polar Lights LLC. La interfaz independiente Lounge permite probar modelos desde el navegador.
Cómo realizar la primera llamada
La guía de inicio permite seguir un recorrido concreto:
- Accede al panel, crea un proyecto y obtén una clave de LLM Gateway. Guárdala en el entorno del servidor.
- Elige créditos o añade tus claves de proveedor en Provider Keys. La clave de la pasarela identifica tu aplicación; la del proveedor permite acceder a tu cuenta de ese servicio.
- Selecciona un ID de modelo disponible y revisa sus entradas, capacidades y límites de contexto.
- Configura
https://api.llmgateway.io/v1como URL base de tu cliente compatible con OpenAI. Una petición HTTP a/chat/completionsdebe incluirmodel,messagesy autenticación Bearer. - Comprueba la respuesta y revisa proveedor, tokens, latencia y coste en el panel antes de mover tráfico real.
La compatibilidad simplifica la conexión, pero no iguala las funciones ni los parámetros de todos los modelos.
Cambiar modelos y gestionar fallos
Una API común facilita comparar modelos para tareas distintas. El enrutamiento puede seleccionar un proveedor disponible y reintentar una solicitud fallida mediante otra alternativa válida. Consulta las reglas de enrutamiento: la recuperación depende de los proveedores disponibles y no garantiza ausencia total de errores.
Las estadísticas ayudan a detectar modelos caros o llamadas lentas. Las reglas de acceso y límites de uso por clave permiten separar aplicaciones y controlar qué modelos o proveedores utilizan. La caché puede reducir trabajo repetido, aunque la caché de respuestas del gateway y la caché de prompts del proveedor son mecanismos diferentes, sujetos a configuración y compatibilidad.
Costes: BYOK, créditos y almacenamiento
Condiciones comprobadas el 10 de septiembre de 2026: el servicio estándar alojado permite BYOK sin comisión de enrutamiento, pagando la inferencia directamente al proveedor. Para créditos, la FAQ oficial indica una comisión del 5 % al comprarlos. Guardar el contenido completo de las solicitudes es opcional y añade 0,01 USD por millón de tokens. La página también indica un 1,5 % internacional para tarjetas no estadounidenses; Enterprise requiere presupuesto.
Revisa los precios actuales y calcula el consumo con tokens de entrada y salida reales. Una cuenta gratuita no convierte todos los modelos en gratuitos. DevPass y las suscripciones de chat tienen condiciones separadas. Estas cifras en USD no son una tarifa local en euros ni una confirmación de todas las formas de pago en España.
Cuándo alojarlo en tu infraestructura
La documentación de autoalojamiento ofrece Docker, Compose y Kubernetes. Necesitarás los servicios del gateway, PostgreSQL, Redis y credenciales de proveedores. Tu equipo asume operación, copias de seguridad, actualizaciones y permisos.
El gateway utiliza AGPLv3, con una licencia comercial separada para funciones empresariales de ee/. Autoalojarlo resulta útil si necesitas controlar la infraestructura y puedes administrarla. No significa ejecutar los modelos en tu servidor: las solicitudes dirigidas a proveedores externos siguen procesándose allí.
Privacidad y límites que conviene revisar
Por defecto se guardan metadatos; las organizaciones estándar pueden activar la conservación de contenidos completos. La Responses API tiene una excepción: sus respuestas almacenadas se conservan 30 días independientemente de ese ajuste. Utiliza store: false para desactivar ese almacenamiento. Consulta la política de retención técnica.
La política de privacidad afirma que el gateway no entrena modelos con contenidos de clientes. Los proveedores elegidos aplican sus propias políticas. También hay límites de organización, concurrencia y proveedor; el cupo de modelos gratuitos depende del estado de créditos. Gestiona las respuestas 429 con esperas y concurrencia controlada.
Preguntas frecuentes
¿Se puede utilizar gratis?
Sí, el enrutamiento BYOK es gratuito, pero la inferencia se paga al proveedor. Créditos y almacenamiento opcional tienen cargos propios.
¿Puedo conservar mi integración con OpenAI?
Puedes usar la API compatible cambiando URL base, clave e ID de modelo. Verifica las funciones específicas antes de migrar.
¿El autoalojamiento mantiene todo el procesamiento en local?
No. Aloja la pasarela; un modelo externo sigue procesando las solicitudes en su proveedor.
¿Nunca se guardan los prompts?
No es una regla universal. Además del almacenamiento opcional, la Responses API tiene su propia retención de 30 días y permite store: false.
Recursos oficiales y comunidad
- Documentación: funciones y conexión de la API.
- GitHub: código, licencias e incidencias.
- Discord oficial: ayuda del equipo y la comunidad.
- Estado del servicio: incidencias operativas.
Herramientas relacionadas
API e infraestructura de modelos de IA →
Experiential LabsFreemium
Una API común para conectar modelos y controlar rutas, claves y consumo.
TrustedRouterDe pago
Gateway compatible con OpenAI para enrutar solicitudes entre modelos con controles de privacidad verificables.
TavilyFreemium
Busca, extrae, rastrea e investiga la web actual para agentes de IA mediante una API
FirecrawlFreemium
Convierte sitios web en Markdown limpio o datos estructurados para agentes de IA, RAG y automatizaciones.
OpenRouterFreemium
Pasarela API unificada y enrutador de modelos de IA