

Mastra FactoryFreemium
Un espace commun pour déléguer le code et garder la maîtrise des changements.
HyperProbe : debugger IA de production et agent on-call
Debugger de production IA : état des variables live sans redéploiement
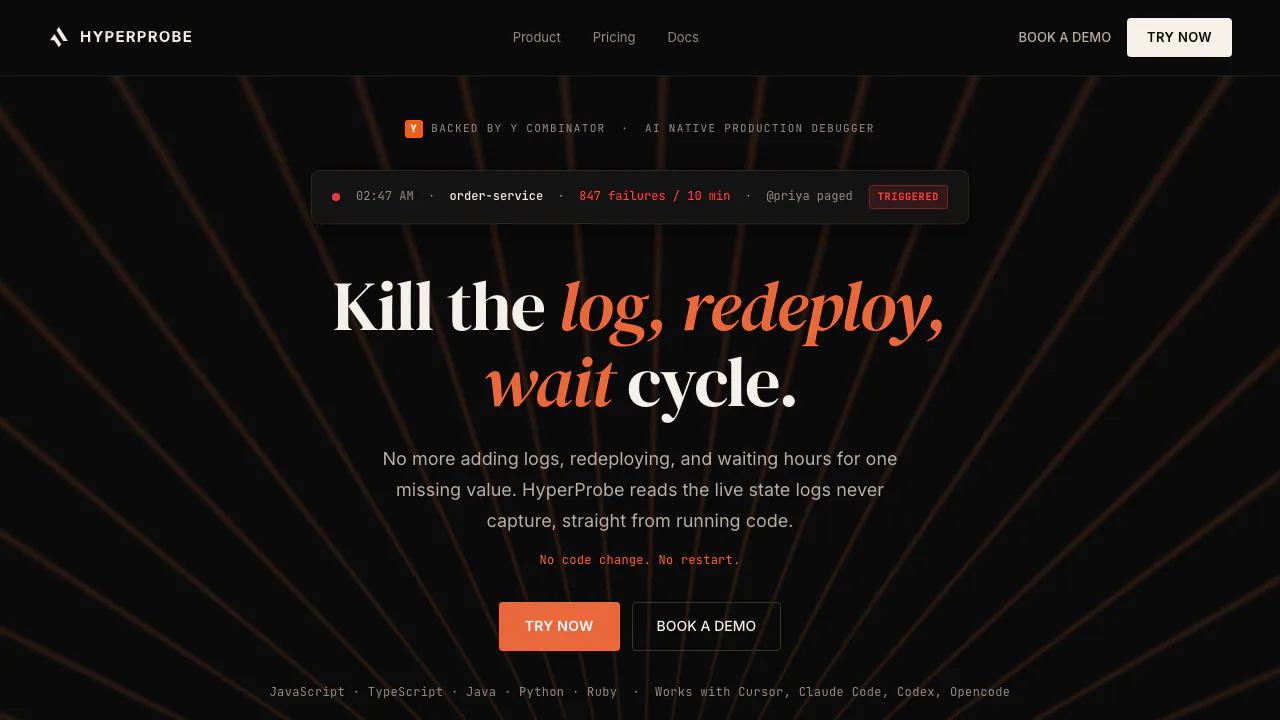
HyperProbe est un debugger de production natif IA, soutenu par Y Combinator. Il permet aux équipes backend d'aller de l'alerte à une cause racine confirmée grâce à des points d'arrêt virtuels en lecture seule sur du code en production, sans redéploiement ni redémarrage.
Qu'est-ce que HyperProbe ? En termes simples
HyperProbe répond à : quelle était la valeur des variables au moment de l'échec, quand les logs ne l'ont jamais enregistrée ?
Au lieu d'ajouter des logs, d'attendre la CI/CD et de redéployer, une sonde capture l'état des variables sur le trafic réel à la ligne suspecte, puis disparaît. Aucune pause de thread, aucun impact utilisateur.
C'est un débogueur non bloquant pour la production, pilotable par des agents de code via MCP (Cursor, Claude Code, Codex, Opencode).
Problèmes ciblés
Échecs silencieux, stack traces éloignées de la cause, exceptions avalées, conditions de course, dérive d'API tierces, code écrit par IA sans preuve runtime.
Fonctionnement des sondes
Lecture seule, non bloquantes, TTL, rate limit et expiration par hits. PII masquée dans l'agent, journal d'audit immuable.
Runtimes : JavaScript, TypeScript, Java, Python, Ruby.
Workflow agent on-call
Intégration PagerDuty, Datadog, Slack → plan → sonde → capture → RCA confirmée.
Tarifs (septembre 2026)
Facturation par service, sondes et captures illimitées.
- Free : 0 $, 1 service, cloud managé, 7 jours d'historique, MCP inclus
- Professional : 99 $/service/mois (79 $ annuel, min. 3 services)
- Enterprise : sur devis, self-hosted/VPC, gates d'approbation
Voir tarifs.
FAQ
Faut-il redéployer pour déboguer ?
Non. Le SDK injecte les sondes in-process.
Limite de sondes ?
Non — facturation par services instrumentés.
Tout en infra propre ?
Oui en Enterprise dans votre VPC.
Ressources officielles
Installation and first capture
Paste one prompt into your coding agent with the installation guide. The agent installs the in-process SDK, wires your entrypoint, enables source maps, and registers the MCP server. Official docs target 15 minutes to first capture. Architecture: SDK agent inside your service plus a broker/control plane (managed or self-hosted).
Integrations: PagerDuty, Datadog, Slack for alerts; Cursor, Claude Code, Codex, Opencode via MCP for agent-driven debugging; VS Code extension for manual probes.
Comparison: with vs without HyperProbe
Without HyperProbe, engineers grep logs, add print statements, wait for CI/CD, redeploy, and hope the failure reproduces—often 2+ hours for a one-line fix. With HyperProbe, the agent locates the frame, places a probe in background, captures on next matching request, and confirms RCA in under 10 minutes in published examples—without redeploy cycles.
More FAQ
What counts as one service?
One application with the SDK installed. Forty Kubernetes pods still count as one service. HyperProbe does not bill per host, container, traffic volume, or seat.
Can we start managed and move to self-hosted?
Yes. The SDK is identical; self-hosted changes where the control plane runs, not your instrumentation.
Which alert sources are supported?
PagerDuty, Datadog, and Slack per the product website. The agent reads logs and distributed traces to plan probe placement.
Does HyperProbe replace observability tools?
No. It complements logs and traces by capturing variable state those signals miss—especially silent failures and logic bugs without exceptions.
Outils similaires
Outils de codage et de développement d'IA →
PR LensFreemium
Comprendre l’architecture d’une pull request avant de lire le diff.
MonidFreemium
Trouver, vérifier et exécuter des outils avec un solde unique.
Kilo CodeFreemium
Un agent open source pour l’IDE, le terminal et le cloud
RevolteFreemium
Livraison logicielle agentique, de l’intention au changement vérifiable.
Visual Studio CodeFreemium
Éditeur de code extensible avec suggestions, chat et agents Copilot