把重复的网页操作交给 AI,得到可检查的表格与执行结果。
Context.dev 网页抓取 API:为 AI Agent 提供网页数据
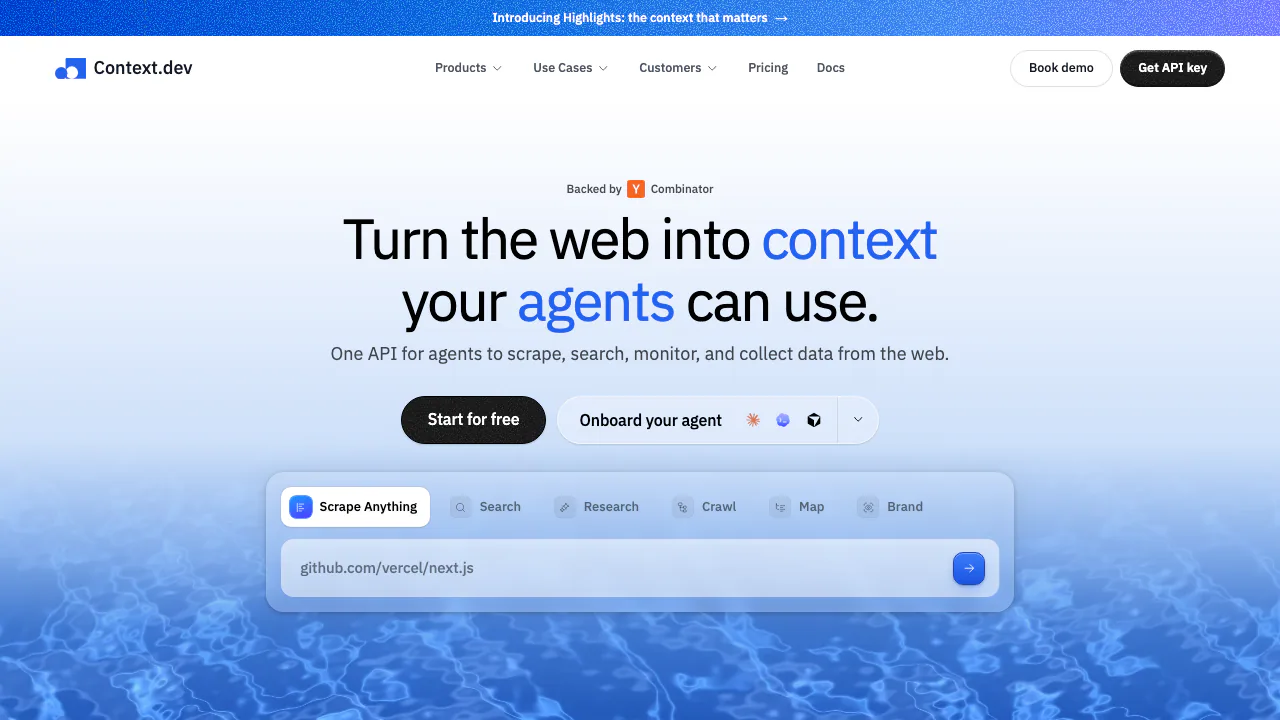
用一个 API 抓取、搜索和监控网页,将网站内容转成 AI 可用的 Markdown 与结构化数据。
通俗解释:Context.dev 是干什么用的?
Context.dev 是一个面向开发者的网页抓取 API。可以把它理解成应用程序的“网页资料采集员”:你的程序交给它一个网址,它负责访问页面,再把内容整理成 Markdown 文本、HTML、截图或结构化字段,交给后续程序使用。开发团队因此可以少维护一套浏览器、代理和抓取重试基础设施。
它由 Context Dev Inc. 运营,主要服务于 AI Agent、RAG 知识库采集、研究工具和网页变化监控。这里的 Markdown 是保留标题、列表等结构的文本格式;RAG 则是让 AI 回答前先检索相关资料的应用方式。Context.dev 提供其中的网页数据获取环节,后续存储、索引和答案展示仍由你的应用负责。
从单页到整站:应该选哪个抓取接口?
Scrape 适合已经知道网址的情况。 你可以请求网页正文、渲染后的 HTML、截图、图片信息,或者按照 JSON Schema 提取字段。需要给模型阅读文档时,通常优先考虑 Markdown;需要检查页面结构时选 HTML;需要保留视觉状态时选截图。JavaScript 渲染和代理包含在基础抓取价格内,但浏览器操作、JSON 提取等选项会影响积分消耗。
Map 负责找网址,Crawl 负责读取多页内容。 比如要采集一个产品文档站,可以先用 Map 发现页面,再按路径筛选真正需要的章节。Crawl 从起始网址跟随链接,一次最多返回 500 页 Markdown,可限制页数、深度和路径。规模更大的任务用 Batches 异步运行,通过轮询或完成通知取回结果。
实际接入 RAG 时,建议先抓取少量代表性页面,检查是否保留了正文和代码示例,再扩大采集范围,并保存来源网址。Scrape 默认可能复用三天内的缓存结果;价格、公告等对时效敏感的内容,可以通过 maxAgeMs: 0 请求重新获取。
搜索、带来源的答案与网页变化监控
不知道目标网页在哪时,用 Search 输入查询词,获取相关网址、标题和摘要,也可以同时取得页面 Markdown。需要围绕一个问题做资料研究时,Answers 接收任务和示例 JSON 结构,输出整理后的结果与来源链接。它与“从已知页面提取字段”是两种不同工作流,不能把研究答案当作已经逐项核实的数据库记录。
Monitors 可以定期检查页面、站点地图或网站关键内容,按文本差异或指定关注点判断变化,再通过带签名的 webhook 或 API 提供结果。例如,产品团队可以跟踪更新日志,研究工具可以追踪新增资料。首次运行用于建立基线,不会直接产生变化提醒;接入时应确认基线成功,并处理通知签名、重复事件和失败运行。
此外,Brand 可以从域名获取公司资料、Logo 和颜色;Styleguide 则提取字体、间距和组件样式等设计信息,适合自动化品牌展示和产品入门流程。
如何开始使用网页抓取 API?
- 注册账户并取得 API 密钥,把密钥保存在服务端,避免放进公开前端代码。
- 按官方快速入门选择 cURL,或 TypeScript、Python、Ruby、Go、PHP 官方 SDK。
- 向
https://api.context.dev/v1/web/scrape发送 POST 请求,用 Bearer 密钥鉴权,并提供目标url与formats: { "markdown": true }。按需要设置sharedParams.mainContentOnly,聚焦主要内容。 - 检查
markdown.success,确认成功后读取markdown.data。HTTP 200 不代表所有输出格式都成功;出错时保留请求 ID,查看对应错误信息。 - 样本符合要求后,再扩大到带范围限制的整站任务。
如果希望在支持远程 MCP 的 AI 工具中调用,可按MCP 接入文档连接 https://mcp.context.dev/mcp 并完成 OAuth 登录。调用会使用所连接组织的 API 积分。
免费额度、套餐与积分怎么计算?
截至 2026 年 10 月 15 日,官方公开的美元月付价格如下;年付、税费及结账条件以当前定价页为准。
| 套餐 | 月付价格(美元) | 每月 API 积分 |
|---|---|---|
| Free | 0 | 1,000 |
| Developer | 19 | 7,500 |
| Pro | 99 | 125,000 |
| Growth | 299 | 500,000 |
| Scale | 499 | 1,000,000 |
Enterprise 采用定制报价。免费版无需信用卡,但免费积分不等于任意操作都能执行 1,000 次:普通 Scrape 从 1 积分起,带浏览器操作的基础费用为 2 积分,成功的 JSON 提取再加 4 积分。Logo Link 使用独立配额,免费档包含一次性 10,000 次额度。
部分输出成功的请求以及目标页面返回 404 的情况也可能扣费,不能一概理解成“失败全免费”。付费档启用 Auto-Topup 后可能产生额外积分费用,支出提醒也不是硬性消费上限。实际并发与速率限制请查看自己的控制台,旧账户或定制方案可能不同。
数据隐私、零保留与内容使用边界
隐私政策允许在适用协议约束下,将查询和结果用于改进服务及训练模型。因此,普通调用不能直接理解成“默认不留存、不训练”。
零数据保留文档说明,ZDR 需要先取得组织级权限,再在支持的请求中明确启用,并检查响应头 X-Context-ZDR: true。Batches、Monitors、Brand retrieval 不支持这种请求模式,ZDR 下也会跳过 PDF OCR。应用自身的日志和存储仍需自行管理。
抓取接口能够取得第三方内容,并不代表你自动获得转载页面、重新分发图片或使用品牌标识的许可;结构化提取和研究结果也可能不完整,需要保留来源并检查关键字段。
常见问题
Context.dev 可以免费使用吗?
可以。Free 每月提供 1,000 API 积分,无需信用卡。实际能处理多少页面,取决于输出选项和接口计费;不要把免费积分直接等同于结构化提取次数。
能把整个网站转成 Markdown 吗?
可以使用 Crawl 读取多页,一次最多 500 页,并限制深度、路径和页数。更大的站点可使用 Batches 异步采集,再由应用接收和保存结果。
为什么返回 200,但某些字段没有内容?
Scrape 对每种输出单独标记成功状态。应检查该输出的 success、错误码和数据,不能仅凭 HTTP 状态判断完整成功。
接入 MCP 是否意味着数据默认零保留?
不意味着。MCP 是调用方式,ZDR 是另行启用的数据处理能力,还受到具体接口支持范围限制,两者应分别确认。