
TypelessFreemium
Trasforma idee dette a voce in testi modificabili
HydraDB: database a grafo e contesto per agenti AI
Database a grafo open source e livello di contesto per agenti AI
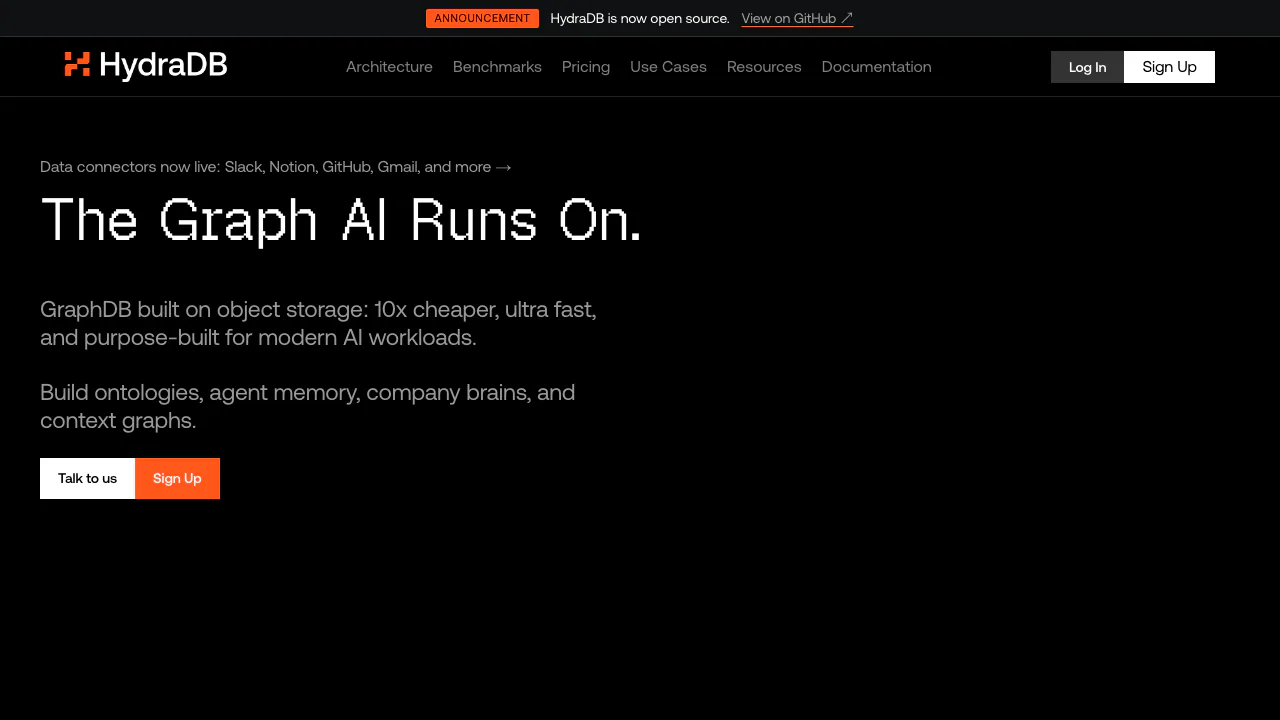
HydraDB è un database a grafo open source e una piattaforma di contesto gestita per team che sviluppano agenti AI con stato. Unisce relazioni a grafo, ricerca semantica, memoria, conoscenza e infrastruttura nativa per object storage, così l’applicazione recupera contesto collegato e non soltanto risultati vettoriali isolati.
In parole semplici: a cosa serve HydraDB?
HydraDB fornisce a un’applicazione AI una memoria strutturata. Può conservare preferenze dell’utente, sessioni precedenti, fatti estratti dai documenti e relazioni tra persone, progetti, eventi e concetti. Quando arriva una domanda, cerca tra queste fonti e restituisce il contesto pertinente con i relativi collegamenti.
È utile per chatbot e copiloti che devono ricordare gli utenti, comprendere relazioni o mantenere conoscenza nel tempo. È infrastruttura per sviluppatori, non un chatbot consumer già pronto.
Motore a grafo e architettura
Il nucleo open source è un database a grafo distribuito scritto in Rust. Il repository descrive un’architettura object-store-native: lo storage compatibile S3 è la fonte durevole, mentre memoria e NVMe sono livelli più rapidi. Supporta un sottoinsieme pratico di OpenCypher, Bolt 5.x compatibile Neo4j, API HTTP, letture coerenti tramite snapshot e attraversamento GraphBLAS.
Il servizio gestito aggiunge orchestrazione del contesto. Le query possono combinare filtri sui metadati, recupero semantico e per parole chiave, e attraversamento del grafo. I dati prestazionali sono benchmark del fornitore e vanno verificati con carichi reali.
Memoria degli agenti, conoscenza e grafi di contesto
HydraDB separa le memorie legate al singolo utente dalla conoscenza condivisa. Le memorie possono registrare preferenze, cronologia, identità o fatti esatti; l’inferenza opzionale ricava preferenze dalle interazioni. Documenti e altre fonti vengono acquisiti e collegati in un grafo di contesto.
Le query possono riguardare memoria, conoscenza o entrambe. Filtri, modalità veloce o di ragionamento e contesto del grafo permettono di bilanciare latenza e profondità. Gli utilizzi includono assistenza clienti, coding assistant, ricerca, conoscenza interna e prodotti “second brain”.
Integrazione per sviluppatori
Con una chiave API si crea un database, si importano conoscenza o memorie, si attende l’indicizzazione e si chiama l’endpoint di query. Sono documentati SDK Python e TypeScript e API REST per altri stack, oltre a MCP, Claude Code, CLI e OpenClaw.
Un proof of concept dovrebbe misurare modellazione delle entità, metadati, tempi di ingestione, qualità del recupero, cancellazione, osservabilità e isolamento dei tenant.
Open source e distribuzione
Il motore è disponibile con licenza AGPL-3.0 e può essere eseguito in container o Kubernetes. HydraDB offre anche cloud gestito, infrastruttura dedicata e opzioni self-hosted o BYOC nei piani superiori. Open source non significa cloud gratuito; chi integra o modifica il software dovrebbe valutare gli obblighi AGPL.
Prezzi
La pagina verificata il 4 settembre 2026 indicava Ship gratuito, Surge a 25 USD al mese con 2 GB inclusi e Scale a 399 USD al mese con 10 GB. Lo spazio extra era fatturato a parte ed Enterprise aveva prezzo personalizzato. Infrastruttura dedicata, documenti di conformità, supporto e self-hosting cambiano per piano.
Prezzi e limiti possono variare: per il budget considera dimensione del grafo, crescita degli indici, backup e costi operativi.
Dati, privacy e aspetti pratici
HydraDB è gestito da AGI Context, Inc. I termini distinguono il software scaricato dal servizio e trattano input e output AI come dati del cliente. Concedono inoltre diritti per erogare e migliorare il servizio, richiedono al cliente copie proprie e non garantiscono sicurezza o disponibilità assolute.
Prima di memorizzare dati sensibili, verifica termini, privacy, DPA, conservazione, cancellazione, regioni, backup e report di sicurezza. Controlla i connettori nel dashboard attuale, perché parti del sito possono indicare stati diversi.
Per chi è adatto HydraDB?
HydraDB è interessante per team che necessitano di memoria degli agenti basata su grafi, conoscenza collegata, contesto multi-tenant o un database a grafo orientato all’object storage. Può essere eccessivo per un semplice bot FAQ. Confrontalo in prova con database vettoriali, grafi tradizionali e database relazionali dotati di funzionalità di recupero.
Strumenti correlati
Database e infrastruttura di contesto per l’IA →
Frigade Assist APIA pagamento
Risposte sul prodotto e guide interattive per il tuo agente IA.
Mastra FactoryFreemium
Un flusso condiviso per assegnare lavoro agli agenti e verificare il codice.
Gojiberry AIA pagamento
Trova potenziali clienti B2B e prepara messaggi personalizzati per LinkedIn ed email.
MagicSlidesFreemium
MagicSlides trasforma un argomento, un testo o materiali esistenti in una presentazione AI da rivedere e modificare
RelaticleFreemium
Gestione di clienti e trattative con campi personalizzati e assistenza IA.