
Typeless部分免費
用說話完成訊息、郵件與文件草稿
HydraDB:面向 AI Agent 的圖資料庫與上下文層
面向有狀態 AI Agent 的開源圖資料庫與上下文基礎設施
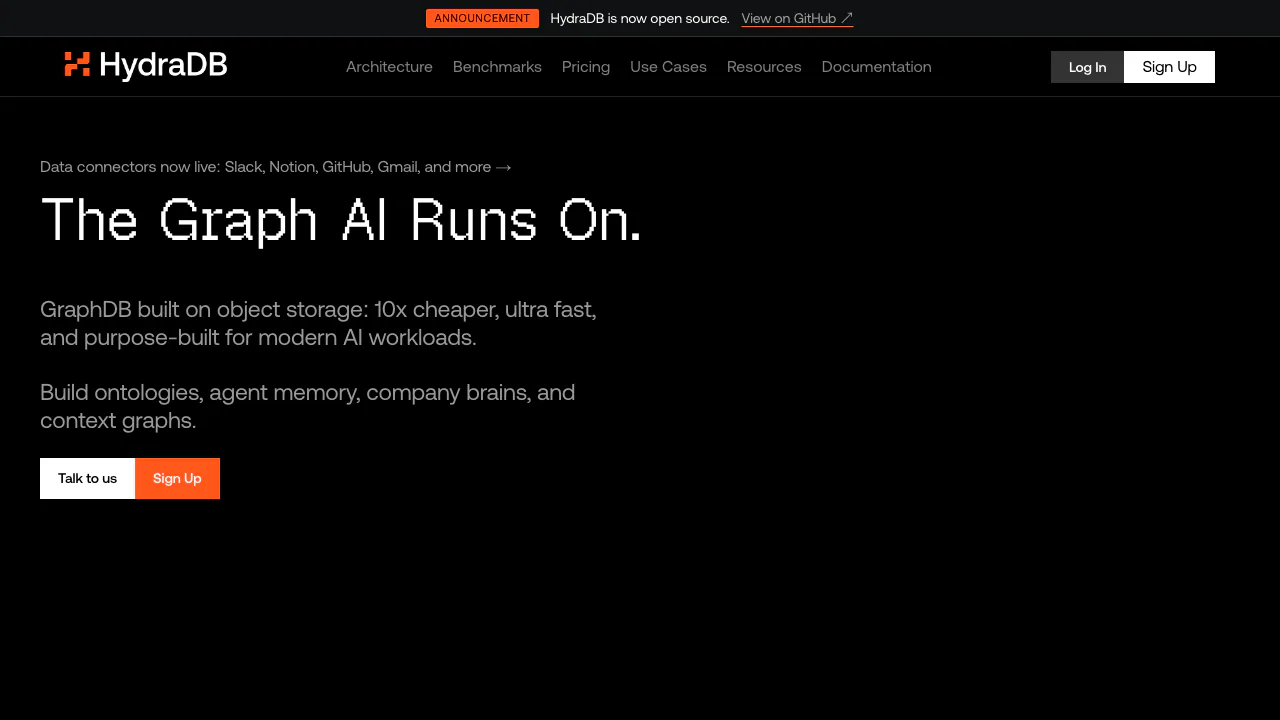
HydraDB 是一款開源圖資料庫,也提供面向有狀態 AI Agent 的託管式上下文平台。它結合圖關係、語意檢索、使用者記憶、共享知識與物件儲存原生架構,讓應用取得彼此相關的上下文,而不只是孤立的向量相似結果。
用白話說,HydraDB 是做什麼的?
可以把 HydraDB 想成 AI 應用的「結構化長期記憶」。它能保存使用者偏好、歷史對話、文件中的事實,以及人物、專案、事件和概念之間的關係。使用者再次提問時,應用可透過 HydraDB 找回相關內容與上下游連結。
因此,它適合需要記住使用者、跨資料理解關係或持續累積知識的聊天機器人、Copilot 與 Agent。HydraDB 是給開發者接入的資料庫與上下文基礎設施,並不是開箱即用的消費級聊天機器人。
圖資料庫核心與技術架構
HydraDB 的開源核心是以 Rust 撰寫的分散式圖資料庫。官方儲存庫說明,其架構以 S3 相容物件儲存作為持久資料來源,並用記憶體與 NVMe 作為較快的層級。它支援實用範圍的 OpenCypher、相容 Neo4j 的 Bolt 5.x、HTTP API、快照一致性讀取,以及基於 GraphBLAS 的圖遍歷。
託管產品在資料庫之上加入上下文編排。查詢流程可組合中繼資料篩選、語意與關鍵字檢索及圖遍歷。官網的效能數字屬於廠商基準測試,選型時應使用自己的圖規模、查詢與部署環境重新驗證。
Agent 記憶、知識與上下文圖
HydraDB 將使用者級記憶與共享知識分開保存。記憶可記錄偏好、經歷、身分或明確事實;啟用選擇性推論後,也能從互動中擷取偏好。文件和其他資料來源可被匯入、解析,並在上下文圖中建立關係。
查詢可以只搜尋記憶、只搜尋知識,或同時搜尋兩者。中繼資料篩選、快速與推理模式、可選圖上下文,使開發者能在延遲與結果深度之間取捨。常見場景包含客服 Agent、程式設計助手、研究 Copilot、企業知識助手與個人「第二大腦」。
開發者如何整合 HydraDB
使用託管服務時,先取得 API Key、建立資料庫、寫入知識或記憶、等待索引完成,再呼叫查詢端點。官方文件提供 Python 與 TypeScript SDK,也可透過 REST API 整合其他技術棧;另有 MCP、Claude Code、CLI 與 OpenClaw 的說明。
建議先以代表性資料做小型驗證,檢查實體建模、中繼資料、匯入與索引時間、召回品質、刪除機制、可觀測性及租戶隔離。
開源授權與部署選擇
開源核心採 AGPL-3.0 授權,可用容器或 Kubernetes 自行部署。HydraDB 也提供託管雲、專用基礎設施,以及較高方案中的自架或 BYOC。程式碼開源不代表託管雲免費;若要嵌入、修改或對外提供服務,應依分發模式審查 AGPL 條款。
價格與方案
截至 2026 年 9 月 4 日,價格頁列出免費 Ship、每月 25 美元且含 2 GB 的 Surge,以及每月 399 美元且含 10 GB 的 Scale;額外儲存另計,Enterprise 為客製價格。專用基礎設施、合規文件、支援與自架能力依方案不同。
價格和限制可能調整。估算成本時也要計入圖資料量、索引成長、備份與維運,並在採購前核對最新頁面。
資料、隱私與實務注意事項
HydraDB 由 AGI Context, Inc. 營運。條款區分下載軟體與託管服務,並將 AI 輸入與輸出視為客戶資料;同時授予營運和改進服務所需的使用權,要求客戶保留自己的副本,也不保證絕對安全或持續無故障。
儲存敏感或受監管資料前,應查看最新條款、隱私政策、DPA、保留與刪除控制、區域、備份及安全報告。官網不同區塊對連接器狀態的描述可能不同,正式採用前應以目前控制台與合約為準。
哪些團隊適合 HydraDB?
HydraDB 較適合需要圖原生 Agent 記憶、關聯知識檢索、多租戶上下文或物件儲存導向圖資料庫的開發團隊。若只是簡單 FAQ 機器人或小型語意搜尋,它可能過於複雜。可用同一測試集比較向量資料庫、傳統圖資料庫與具檢索擴充的關聯式資料庫。
相關工具
AI 資料庫與脈絡基礎設施 →
讓既有 AI 代理理解產品,並在使用者的操作畫面中提供導覽。

Mastra Factory部分免費
讓 AI 代理處理開發工作,讓團隊共同檢視計畫與程式碼。
找出合適的潛在客戶,為 LinkedIn 與電子郵件準備個人化訊息。
MagicSlides部分免費
MagicSlides 可把主題、文字與 PDF 轉成可編輯的 AI 簡報。了解文件轉投影片、Google 簡報操作、PowerPoint 匯出、付費限制及資料處理方式。
Relaticle部分免費
將客戶資料、銷售商機與後續工作串在一起的開源 AI CRM。