
TypelessFreemium
Fale suas ideias e receba um texto para revisar
HydraDB: banco de dados de grafos e contexto para agentes de IA
Banco de dados de grafos aberto e camada de contexto para agentes de IA
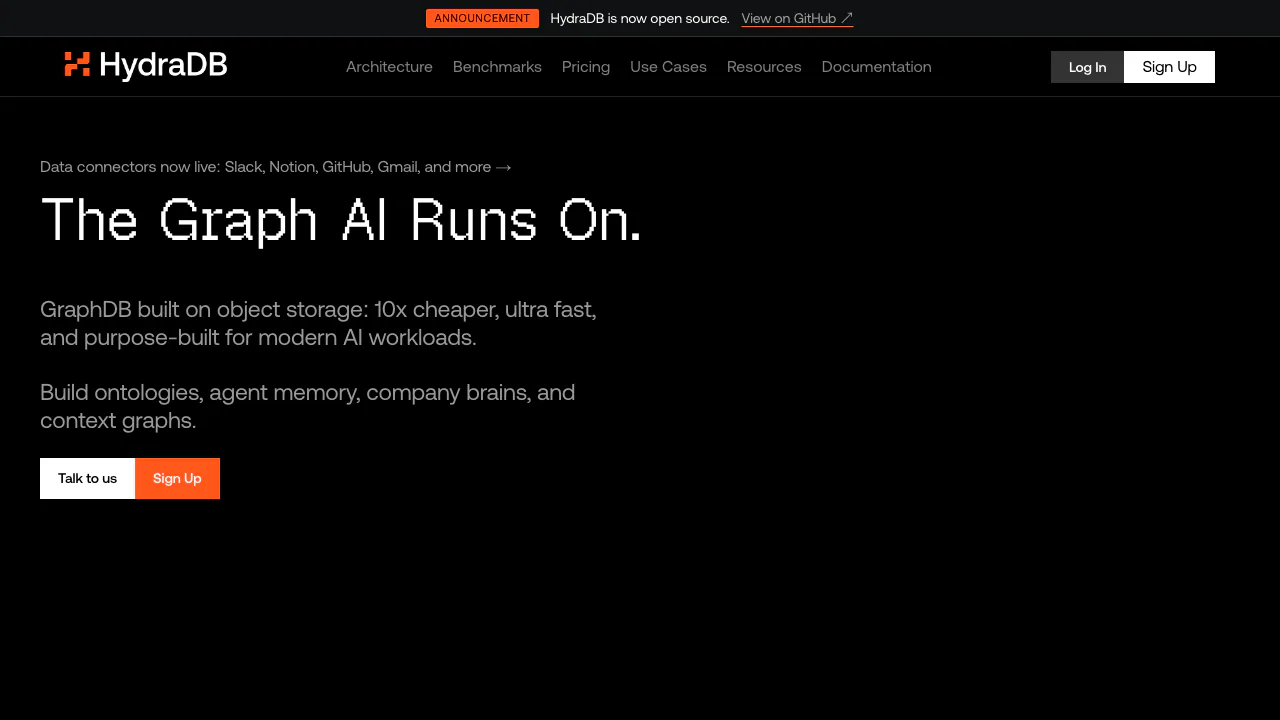
HydraDB é um banco de dados de grafos open source e uma plataforma gerenciada de contexto para equipes que criam agentes de IA com estado. Ele combina relações em grafo, busca semântica, memória, conhecimento e infraestrutura nativa de armazenamento de objetos para recuperar contexto conectado, não apenas correspondências vetoriais isoladas.
Em termos simples, para que serve o HydraDB?
O HydraDB dá uma memória estruturada a uma aplicação de IA. Ele pode guardar preferências do usuário, sessões anteriores, fatos extraídos de documentos e relações entre pessoas, projetos, eventos e conceitos. Diante de uma nova pergunta, pesquisa essas fontes e devolve contexto relevante com suas conexões.
Isso ajuda chatbots e copilotos que precisam lembrar usuários, compreender relações ou manter conhecimento ao longo do tempo. É infraestrutura para desenvolvedores, não um chatbot de consumo pronto.
Núcleo de grafos e arquitetura
O núcleo aberto é um banco de dados de grafos distribuído escrito em Rust. O repositório descreve uma arquitetura nativa de object storage: armazenamento compatível com S3 é a fonte durável, enquanto memória e NVMe formam camadas rápidas. Há suporte a um subconjunto prático de OpenCypher, Bolt 5.x compatível com Neo4j, APIs HTTP, leituras consistentes por snapshot e travessia GraphBLAS.
O produto gerenciado adiciona orquestração de contexto. Consultas podem combinar filtros de metadados, recuperação semântica e por palavra-chave e travessia do grafo. Os números de desempenho são benchmarks do fornecedor e devem ser reproduzidos com dados reais.
Memória de agentes, conhecimento e grafos de contexto
O HydraDB separa memórias vinculadas a usuários do conhecimento compartilhado. Memórias registram preferências, histórico, identidade ou fatos exatos; a inferência opcional pode extrair preferências de uma interação. Documentos e outras fontes são ingeridos e relacionados em um grafo de contexto.
Consultas podem pesquisar memória, conhecimento ou ambos. Filtros, modos rápido ou de raciocínio e contexto do grafo ajudam a equilibrar latência e profundidade. Casos de uso incluem suporte, assistentes de programação, pesquisa, conhecimento interno e produtos de “segundo cérebro”.
Integração para desenvolvedores
Com uma chave de API, o desenvolvedor cria um banco, ingere conhecimento ou memória, aguarda a indexação e chama o endpoint de consulta. A documentação inclui SDKs para Python e TypeScript e API REST, além de MCP, Claude Code, CLI e OpenClaw.
Em uma prova de conceito, avalie modelagem de entidades, metadados, tempo de ingestão, qualidade da recuperação, exclusão, observabilidade e isolamento de clientes.
Código aberto e implantação
O núcleo usa a licença AGPL-3.0 e pode rodar em contêineres ou Kubernetes. O HydraDB também oferece nuvem gerenciada, infraestrutura dedicada e opções self-hosted ou BYOC nos planos superiores. Código aberto não torna o serviço hospedado gratuito; quem integra ou modifica o software deve analisar a AGPL.
Preços
A página verificada em 4 de setembro de 2026 mostrava Ship grátis, Surge por US$ 25 mensais com 2 GB e Scale por US$ 399 mensais com 10 GB. Armazenamento excedente era cobrado à parte e Enterprise tinha preço personalizado. Infraestrutura dedicada, documentos de conformidade, suporte e auto-hospedagem variam por plano.
Preços e limites mudam; antes de orçar, confira a página atual e considere o tamanho do grafo, crescimento de índices, backups e operação.
Dados, privacidade e pontos práticos
O HydraDB é operado pela AGI Context, Inc. Os termos diferenciam software baixado e serviço gerenciado e tratam entradas e saídas de IA como dados do cliente. Também concedem direitos para operar e melhorar o serviço, atribuem ao cliente a guarda de cópias e não garantem segurança ou disponibilidade absolutas.
Antes de dados sensíveis, revise termos, privacidade, DPA, retenção, exclusão, regiões, backups e relatórios de segurança. Confirme conectores no painel atual, pois seções do site podem exibir estados diferentes.
Para quem o HydraDB é indicado?
É uma opção para equipes que precisam de memória de agentes nativa de grafos, recuperação de conhecimento conectado, contexto multi-tenant ou banco de grafos orientado a object storage. Pode ser excessivo para um bot FAQ simples. Compare em teste com bancos vetoriais, bancos de grafos tradicionais e bancos relacionais com extensões de recuperação.
Ferramentas parecidas
Bancos de dados e infraestrutura de contexto para IA →
Conhecimento do produto e orientação no aplicativo para seu agente de IA.

Mastra FactoryFreemium
Organize o trabalho dos agentes e revise as mudanças com sua equipe.
Gojiberry AIPago
Encontre potenciais clientes B2B e prepare abordagens personalizadas por LinkedIn e e-mail.
MagicSlidesFreemium
O MagicSlides transforma um tema, texto ou material existente em uma apresentação com IA que você pode revisar e editar
RelaticleFreemium
CRM de código aberto para acompanhar clientes, negócios e próximas ações.