
TypelessFreemium
Parlez pour rédiger vos messages et documents
HydraDB : base de données graphe et contexte pour agents IA
Base de données graphe open source et couche de contexte pour agents IA
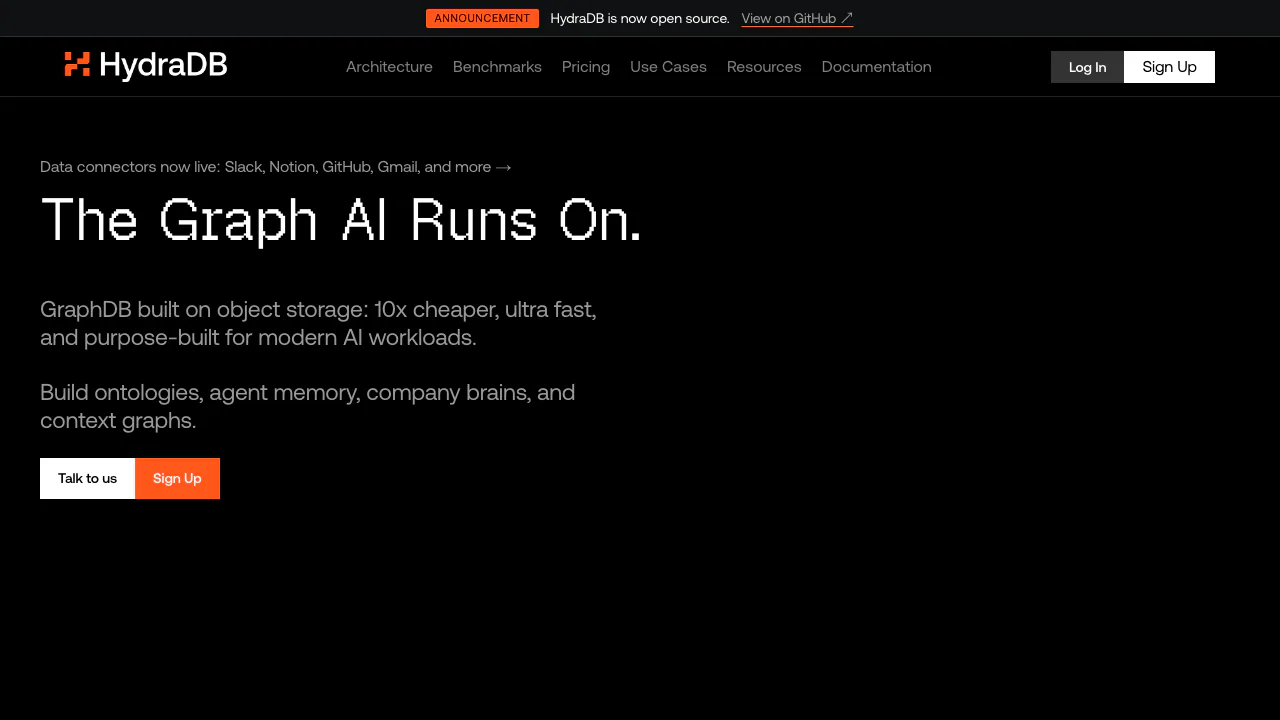
HydraDB est une base de données graphe open source et une plateforme de contexte managée destinée aux équipes qui développent des agents IA avec état. Elle réunit relations de graphe, recherche sémantique, mémoire, connaissances et infrastructure native du stockage objet afin de restituer un contexte relié plutôt que de simples voisins vectoriels.
En termes simples, à quoi sert HydraDB ?
HydraDB donne une mémoire structurée à une application d’IA. Elle peut conserver les préférences d’un utilisateur, les sessions passées, des faits issus de documents et les liens entre personnes, projets, événements et concepts. À chaque nouvelle question, elle recherche ces sources et renvoie le contexte pertinent avec ses relations.
Elle convient aux chatbots et copilotes qui doivent reconnaître un utilisateur, comprendre des liens ou maintenir des connaissances dans le temps. Il s’agit d’une infrastructure pour développeurs, pas d’un chatbot grand public prêt à l’emploi.
Moteur graphe et architecture
Le cœur open source est une base de données graphe distribuée écrite en Rust. Son dépôt décrit une architecture native du stockage objet : un stockage compatible S3 sert de source durable, tandis que la mémoire et le NVMe accélèrent l’accès. HydraDB prend en charge un sous-ensemble pratique d’OpenCypher, Bolt 5.x compatible Neo4j, des API HTTP, des lectures cohérentes par instantané et des parcours GraphBLAS.
Le service managé ajoute une orchestration du contexte. Les requêtes peuvent combiner filtres de métadonnées, recherche sémantique et lexicale, puis parcours du graphe. Les performances annoncées sont des tests du fournisseur ; elles doivent être vérifiées avec le volume et les requêtes du projet.
Mémoire d’agent, connaissances et graphes de contexte
HydraDB sépare les souvenirs propres à chaque utilisateur des connaissances partagées. Les souvenirs peuvent contenir préférences, historique, identité ou faits exacts ; une inférence facultative extrait des préférences d’un échange. Les documents et autres sources sont ingérés puis reliés dans un graphe de contexte.
Une requête peut viser la mémoire, les connaissances ou les deux. Filtres, modes rapide ou raisonné et contexte graphe permettent d’arbitrer latence et richesse. Les usages incluent support, assistants de code, copilotes de recherche, bases internes et produits de type « second cerveau ».
Intégration pour les développeurs
Avec une clé API, on crée une base, ingère connaissances ou souvenirs, attend l’indexation puis appelle l’API de requête. La documentation propose des SDK Python et TypeScript ainsi qu’une API REST. Des intégrations MCP, Claude Code, CLI et OpenClaw sont également décrites.
Un prototype réaliste doit contrôler la modélisation des entités, les métadonnées, le délai d’ingestion, la qualité des résultats, la suppression, l’observabilité et l’isolation des locataires.
Open source et déploiement
Le moteur est publié sous AGPL-3.0 et peut fonctionner en conteneur ou sur Kubernetes. HydraDB propose aussi un cloud managé, une infrastructure dédiée et, selon le forfait, l’auto-hébergement ou le BYOC. Le code ouvert ne rend pas le cloud gratuit ; les équipes qui intègrent ou modifient le logiciel doivent étudier l’AGPL.
Tarifs
La page vérifiée le 4 septembre 2026 affichait Ship gratuit, Surge à 25 $ par mois avec 2 Go inclus et Scale à 399 $ par mois avec 10 Go. Le stockage excédentaire était facturé séparément et Enterprise sur devis. Infrastructure dédiée, documents de conformité, support et auto-hébergement varient selon le forfait.
Les prix et limites peuvent évoluer. Pour budgéter, tenez compte des données du graphe, de la croissance des index, des sauvegardes et de l’exploitation.
Données, confidentialité et précautions
HydraDB est exploité par AGI Context, Inc. Les conditions distinguent le logiciel téléchargé du service managé et classent entrées et sorties IA comme données client. Elles accordent aussi les droits nécessaires au fonctionnement et à l’amélioration, demandent au client de garder ses propres copies et ne garantissent ni sécurité ni disponibilité absolues.
Avant des données sensibles, examinez les conditions, la politique de confidentialité, le DPA, la conservation, la suppression, les régions, sauvegardes et rapports de sécurité. Vérifiez les connecteurs dans le tableau de bord actuel, car certaines pages du site peuvent présenter des statuts différents.
À qui s’adresse HydraDB ?
HydraDB mérite une évaluation pour une mémoire d’agent native graphe, une recherche de connaissances reliées, un contexte multi-tenant ou une base graphe orientée stockage objet. Pour un simple bot FAQ, l’ensemble peut être surdimensionné. Comparez-le à une base vectorielle, une base graphe classique et une base relationnelle enrichie, sur un même cas d’usage.
Outils similaires
Bases de données et infrastructure de contexte IA →
Frigade Assist APIPayant
Des réponses produit et des parcours guidés dans votre agent IA existant.
Mastra FactoryFreemium
Un espace commun pour déléguer le code et garder la maîtrise des changements.
Gojiberry AIPayant
Repérez des prospects B2B pertinents et préparez des prises de contact personnalisées.
MagicSlidesFreemium
MagicSlides transforme un sujet, un texte ou des documents en une présentation IA à relire et à modifier
RelaticleFreemium
Un CRM open source pour suivre les relations clients et les prochaines actions commerciales.