
Typeless一部無料
話したアイデアを、見直して使える文章に
HydraDB:AIエージェント向けグラフデータベース
ステートフルAIエージェント向けのオープンソース・グラフデータベース
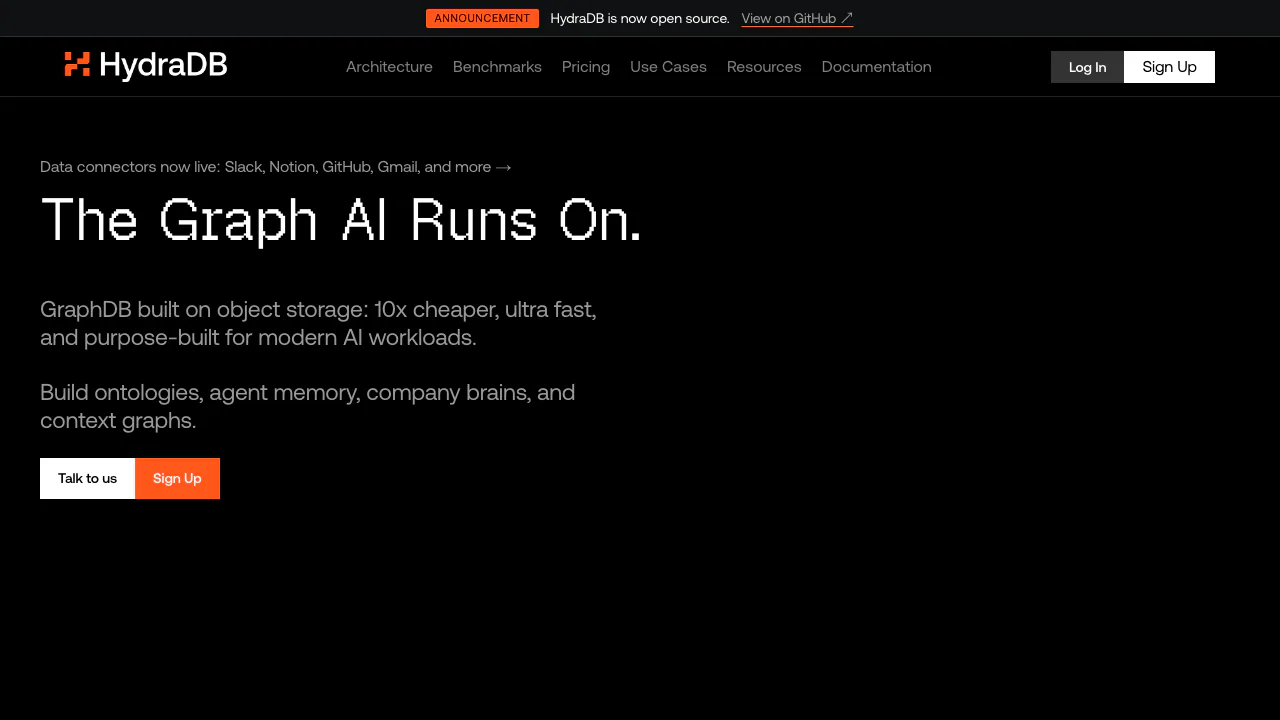
HydraDBは、ステートフルなAIエージェントを構築するチーム向けのオープンソース・グラフデータベース兼マネージドコンテキスト基盤です。グラフ関係、セマンティック検索、ユーザー記憶、共有知識、オブジェクトストレージネイティブな構成を組み合わせ、孤立したベクトル類似結果だけでなく、つながりのある文脈を取得します。
わかりやすく言うと、HydraDBは何をするサイト?
HydraDBは、AIアプリに「構造化された長期記憶」を与える仕組みです。ユーザーの好み、過去のセッション、文書内の事実、人物・プロジェクト・出来事・概念の関係を保存できます。次の質問を受けたとき、関連情報とそのつながりを検索してエージェントへ返します。
ユーザーを覚える、複数資料の関係を理解する、時間をまたいで知識を維持するといったチャットボットやCopilotに向きます。HydraDB自体は開発者向けインフラであり、完成済みの一般向けチャットボットではありません。
グラフデータベースの中核と構成
オープンソースの中核はRust製の分散グラフデータベースです。公式リポジトリによると、S3互換オブジェクトストレージを永続的な正本とし、メモリとNVMeを高速層に使います。実用範囲のOpenCypher、Neo4j互換Bolt 5.x、HTTP API、スナップショット一貫性読み取り、GraphBLASベースの探索に対応します。
マネージド製品はコンテキストのオーケストレーションを追加します。メタデータフィルター、セマンティック検索、キーワード検索、グラフ探索を組み合わせられます。性能値はベンダーのベンチマークなので、自社データとクエリで再検証が必要です。
エージェント記憶・知識・コンテキストグラフ
HydraDBはユーザー単位の記憶と共有知識を分けて保存します。記憶には好み、履歴、アイデンティティ、明示的な事実を入れられ、任意の推論で会話から好みを抽出できます。文書などは取り込み後、事実同士をコンテキストグラフで関連付けます。
クエリは記憶、知識、または両方を対象にできます。フィルター、高速・推論モード、任意のグラフコンテキストにより、待ち時間と検索の深さを調整できます。サポート、コーディング、調査、社内知識、個人向け「第二の脳」が代表例です。
開発者向けの連携方法
マネージド版ではAPIキーを取得し、データベース作成、知識や記憶の投入、インデックス完了待ち、クエリAPI呼び出しの順で始めます。PythonとTypeScript SDK、REST APIがあり、MCP、Claude Code、CLI、OpenClawとの連携も記載されています。
検証では、エンティティ設計、メタデータ、取り込み時間、検索品質、削除、可観測性、テナント分離を代表的データで確認しましょう。
オープンソースと導入形態
中核はAGPL-3.0で公開され、コンテナやKubernetesでセルフホストできます。マネージドクラウド、専用インフラ、上位プランのセルフホストやBYOCもあります。オープンソースでもクラウドが無料とは限りません。組み込みや改変を行う場合はAGPLの条件を確認してください。
料金
2026年9月4日時点の価格ページでは、無料のShip、月25米ドルで2GBを含むSurge、月399米ドルで10GBを含むScaleが掲載されていました。超過ストレージは別料金、Enterpriseは個別見積もりです。専用環境、コンプライアンス資料、サポート、セルフホストの可否はプランごとに異なります。
価格と上限は変更され得ます。グラフ容量、インデックス増加、バックアップ、運用費も含め、契約前に現行ページを確認してください。
データ、プライバシー、注意点
運営元はAGI Context, Inc.です。規約はダウンロード版ソフトウェアとマネージドサービスを区別し、AIの入力・出力を顧客データとして扱います。同時にサービス提供・改善に必要な利用権を定め、顧客自身のコピー保持を求め、絶対的な安全性や無停止を保証しません。
機密・規制対象データでは、最新の規約、プライバシーポリシー、DPA、保存・削除、リージョン、バックアップ、セキュリティ報告を確認しましょう。コネクターはサイト内で表記差があるため、現行ダッシュボードで利用可否を確かめるのが安全です。
HydraDBが向くチーム
グラフネイティブなエージェント記憶、関連知識検索、マルチテナントの文脈、オブジェクトストレージ型グラフDBが必要な開発チームに向きます。単純なFAQボットには過剰な場合があります。ベクトルDB、従来型グラフDB、検索拡張付きRDBと同一データで比較すると判断しやすくなります。
関連ツール
AIデータベース・コンテキスト基盤 →
既存のAIエージェントに製品知識と画面内の操作ガイドを追加。

Mastra Factory一部無料
AIに実装を任せ、計画とコード変更をチームで確認する開発環境。
適切なB2B見込み客を探し、LinkedInやメール向けの個別メッセージを準備。
MagicSlides一部無料
MagicSlidesでテーマや文章、PDFからAIスライドを作成。編集の手順、PowerPointへの書き出し、無料体験と有料プラン、資料のデータ処理条件を確認できます。
Relaticle一部無料
顧客情報と商談、次の対応を結び付けるオープンソースCRM。