
TypelessFreemium
Gedanken einsprechen und als Text weiterverwenden
HydraDB: Graphdatenbank und Kontextschicht für KI-Agenten
Open-Source-Graphdatenbank und Kontextschicht für zustandsbehaftete KI-Agenten
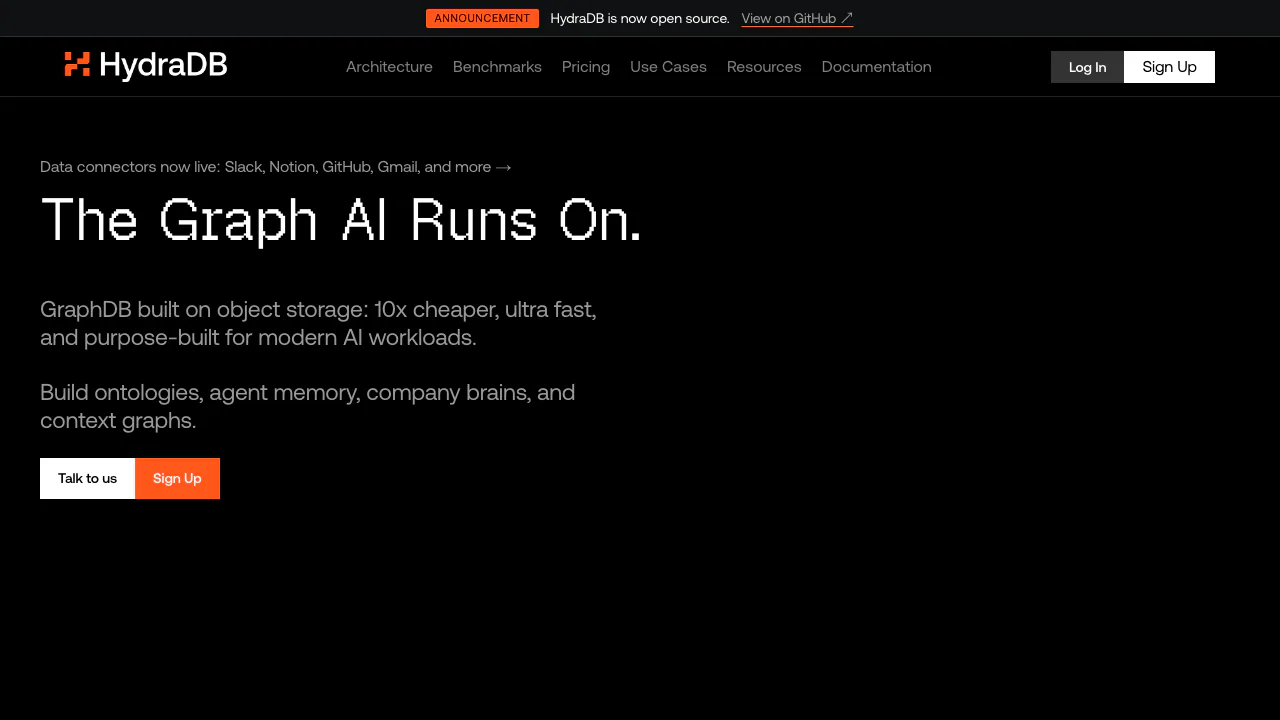
HydraDB ist eine Open-Source-Graphdatenbank und eine verwaltete Kontextplattform für Teams, die zustandsbehaftete KI-Agenten entwickeln. Sie verbindet Graphbeziehungen, semantische Suche, Erinnerungen, Wissen und objektspeicherbasierte Infrastruktur, damit Anwendungen zusammenhängenden Kontext statt nur einzelner Vektortreffer abrufen.
Einfach erklärt: Was macht HydraDB?
HydraDB gibt einer KI-Anwendung ein strukturiertes Gedächtnis. Gespeichert werden können Nutzerpräferenzen, frühere Sitzungen, Fakten aus Dokumenten sowie Beziehungen zwischen Personen, Projekten, Ereignissen und Begriffen. Bei einer neuen Frage sucht HydraDB in diesen Quellen und liefert passenden, verknüpften Kontext zurück.
Das eignet sich für Chatbots und Copiloten, die Nutzer wiedererkennen, Beziehungen verstehen oder Wissen über längere Zeit pflegen sollen. HydraDB ist Entwickler-Infrastruktur und kein fertiger Endnutzer-Chatbot.
Graphdatenbank-Kern und Architektur
Der offene HydraDB-Kern ist eine in Rust geschriebene verteilte Graphdatenbank. Laut Repository dient S3-kompatibler Objektspeicher als dauerhafte Datenquelle; Arbeitsspeicher und NVMe bilden schnellere Ebenen. Unterstützt werden ein praxisorientierter OpenCypher-Umfang, Bolt 5.x für Neo4j-kompatiblen Zugriff, HTTP-APIs, konsistente Snapshots und GraphBLAS-basierte Traversierung.
Der verwaltete Dienst ergänzt eine Kontext-Orchestrierung. Die Abfrage kann Metadatenfilter, semantische und schlüsselwortbasierte Suche sowie Graphtraversierung kombinieren. Leistungswerte stammen vom Anbieter und sollten mit eigenem Datenvolumen und realistischen Abfragen nachgemessen werden.
Agentengedächtnis, Wissen und Kontextgraphen
HydraDB trennt nutzerbezogene Erinnerungen von gemeinsamem Wissen. Erinnerungen können Vorlieben, Verlauf, Identität oder exakte Fakten festhalten; eine optionale Inferenz extrahiert Präferenzen aus Interaktionen. Dokumente und andere Quellen werden aufgenommen und ihre Fakten in einem Kontextgraphen verknüpft.
Abfragen können Erinnerungen, Wissen oder beides durchsuchen. Metadatenfilter, schnelle beziehungsweise denkintensive Modi und optionaler Graphkontext steuern Latenz und Ergebnistiefe. Einsatzfelder sind Support-Agenten, Coding-Assistenten, Recherche-Copiloten, interne Wissenssysteme und persönliche „Second-Brain“-Produkte.
Integration für Entwickler
Der Einstieg erfolgt über einen API-Schlüssel: Datenbank anlegen, Wissen oder Erinnerungen aufnehmen, Indexierung abwarten und die Query-API aufrufen. Dokumentierte SDKs gibt es für Python und TypeScript; REST bindet weitere Stacks an. Außerdem beschreibt HydraDB MCP, Claude Code, CLI und OpenClaw.
Für einen Proof of Concept sollten Datenmodell, Metadaten, Aufnahmezeit, Trefferqualität, Löschung, Beobachtbarkeit und Mandantentrennung mit einem repräsentativen Datensatz geprüft werden.
Open Source und Bereitstellung
Der Datenbankkern steht unter AGPL-3.0 und lässt sich per Container oder Kubernetes betreiben. Daneben gibt es Cloud-Pläne, dedizierte Infrastruktur sowie Self-Hosting- und BYOC-Optionen in höheren Tarifen. Open Source bedeutet nicht, dass der verwaltete Dienst kostenlos ist. Wer die AGPL-Software einbettet oder verändert, sollte die Lizenzfolgen prüfen.
Preise
Am 4. September 2026 nannte die Preisseite den kostenlosen Tarif Ship, Surge für 25 US-Dollar monatlich mit 2 GB inklusive und Scale für 399 US-Dollar mit 10 GB. Mehrspeicher wurde separat berechnet; Enterprise war auf Anfrage. Dedizierte Infrastruktur, Compliance-Unterlagen, Support und Self-Hosting hängen vom Tarif ab.
Preise und Grenzen können sich ändern. Für die Kalkulation zählen gespeicherte Graphdaten, Indexwachstum, Backups und Betriebsaufwand, nicht nur der Einstiegspreis.
Datenschutz und praktische Hinweise
Betreiber ist AGI Context, Inc. Die Bedingungen unterscheiden heruntergeladene Software vom verwalteten Dienst und behandeln KI-Ein- und -Ausgaben als Kundendaten. Gleichzeitig enthalten sie Nutzungsrechte für Betrieb und Verbesserung, übertragen Verantwortung für eigene Sicherungskopien und schließen absolute Sicherheit oder ständige Verfügbarkeit aus.
Vor sensiblen oder regulierten Daten sollten aktuelle Bedingungen, Datenschutzrichtlinie, DPA, Lösch- und Aufbewahrungsregeln, Regionen, Backups und Sicherheitsberichte geprüft werden. Beworbene Konnektoren sollte man im aktuellen Dashboard verifizieren, da Website-Bereiche den Status unterschiedlich darstellen können.
Für wen eignet sich HydraDB?
HydraDB passt zu Entwicklungsteams, die graphbasiertes Agentengedächtnis, verknüpfte Wissenssuche, mandantenfähigen Kontext oder eine objektspeicherorientierte Graphdatenbank benötigen. Für einen einfachen FAQ-Bot kann die Plattform überdimensioniert sein. Ein Vergleichstest mit Vektordatenbanken, klassischen Graphdatenbanken und relationalen Systemen schafft Klarheit.
Ähnliche Tools
KI-Datenbanken & Kontext-Infrastruktur →
Frigade Assist APIKostenpflichtig
Produktwissen und interaktive Anleitungen für Ihren vorhandenen KI-Agenten.
Mastra FactoryFreemium
Softwareaufgaben mit KI-Agenten bearbeiten und im Team prüfen.
Gojiberry AIKostenpflichtig
Passende B2B-Kontakte finden und persönliche Nachrichten für LinkedIn und E-Mail vorbereiten.
MagicSlidesFreemium
MagicSlides erstellt mit KI Präsentationen aus einem Thema, Text oder vorhandenen Materialien
RelaticleFreemium
Kundenbeziehungen und Vertriebsaufgaben in einem anpassbaren Open Source CRM.