
TypelessFreemium
Dicta ideas y conviértelas en texto editable
HydraDB: base de datos de grafos y contexto para agentes de IA
Base de datos de grafos de código abierto y capa de contexto para agentes de IA
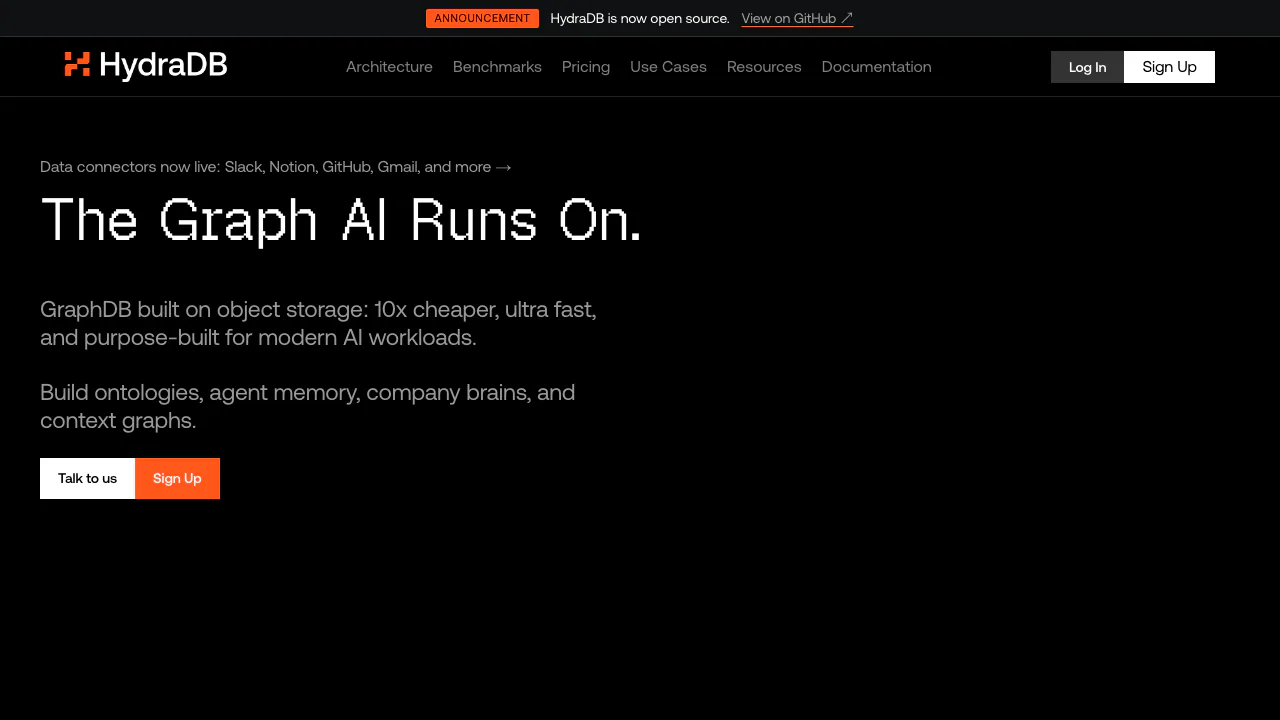
HydraDB es una base de datos de grafos de código abierto y una plataforma de contexto gestionada para crear agentes de IA con estado. Combina relaciones de grafo, búsqueda semántica, memoria, conocimiento e infraestructura basada en almacenamiento de objetos para recuperar contexto conectado, no solo coincidencias vectoriales aisladas.
Explicación sencilla: ¿para qué sirve HydraDB?
HydraDB proporciona una memoria estructurada a una aplicación de IA. Puede guardar preferencias de una persona, sesiones anteriores, datos extraídos de documentos y relaciones entre personas, proyectos, eventos y conceptos. Cuando llega una pregunta, busca en esas fuentes y devuelve el contexto pertinente y relacionado.
Resulta útil para chatbots y copilotos que deben recordar usuarios, comprender conexiones o mantener conocimiento a lo largo del tiempo. Es infraestructura para desarrolladores, no un chatbot de consumo terminado.
Núcleo de grafo y arquitectura
El núcleo abierto es una base de datos de grafos distribuida escrita en Rust. Su repositorio describe una arquitectura nativa de almacenamiento de objetos: S3 compatible actúa como fuente duradera, mientras memoria y NVMe ofrecen capas más rápidas. Admite un subconjunto práctico de OpenCypher, Bolt 5.x compatible con Neo4j, API HTTP, lecturas con instantáneas coherentes y recorridos basados en GraphBLAS.
El servicio gestionado añade orquestación de contexto. La consulta puede combinar filtros de metadatos, recuperación semántica y por palabras clave, y recorrido de grafos. Las cifras de rendimiento son pruebas publicadas por el proveedor; conviene reproducirlas con datos y consultas reales.
Memoria de agentes, conocimiento y grafos de contexto
HydraDB separa memorias ligadas a cada usuario del conocimiento compartido. Las memorias conservan preferencias, historial, identidad o hechos exactos; la inferencia opcional puede extraer preferencias de una conversación. Los documentos y otras fuentes se procesan y relacionan dentro de un grafo de contexto.
Las consultas pueden buscar memoria, conocimiento o ambos. Los filtros, los modos rápido y de razonamiento, y el contexto de grafo permiten ajustar latencia y profundidad. Entre los casos de uso están soporte, asistentes de programación, investigación, conocimiento interno y aplicaciones de “segundo cerebro”.
Integración para desarrolladores
Con una clave API se crea una base de datos, se ingiere conocimiento o memoria, se espera la indexación y se usa el endpoint de consulta. La documentación incluye SDK para Python y TypeScript y una API REST para otros entornos, además de integraciones con MCP, Claude Code, CLI y OpenClaw.
En una prueba inicial conviene medir modelado de entidades, metadatos, tiempo de ingesta, calidad de recuperación, borrado, observabilidad y aislamiento entre clientes.
Código abierto y despliegue
El núcleo usa la licencia AGPL-3.0 y puede ejecutarse con contenedores o Kubernetes. HydraDB también ofrece nube gestionada, infraestructura dedicada y opciones de autoalojamiento o BYOC en planes superiores. Que el código sea abierto no vuelve gratuito el servicio alojado; revisa la AGPL si vas a integrar o modificar el software.
Precios
La página consultada el 4 de septiembre de 2026 mostraba Ship gratis, Surge por 25 USD al mes con 2 GB y Scale por 399 USD al mes con 10 GB. El almacenamiento adicional se cobraba aparte y Enterprise tenía precio personalizado. Infraestructura dedicada, informes de cumplimiento, soporte y autoalojamiento varían por plan.
Verifica tarifas y límites actuales antes de presupuestar. Considera el volumen del grafo, crecimiento del índice, copias de seguridad y operación, no solo la cuota inicial.
Datos, privacidad y aspectos prácticos
AGI Context, Inc. opera HydraDB. Sus términos distinguen el software descargado del servicio gestionado y consideran las entradas y salidas de IA datos del cliente. También conceden permisos para operar y mejorar el servicio, responsabilizan al cliente de conservar copias y no prometen seguridad o disponibilidad absolutas.
Antes de cargar datos sensibles, revisa términos, privacidad, DPA, retención, eliminación, regiones, copias y seguridad. Comprueba en el panel la disponibilidad real de conectores, ya que distintas secciones del sitio pueden mostrar estados diferentes.
¿Para quién es HydraDB?
Es una opción para equipos que necesitan memoria de agentes basada en grafos, recuperación de conocimiento conectado, contexto multiusuario o una base de grafos orientada a objetos. Puede ser excesivo para un bot de preguntas frecuentes sencillo. Compara mediante una prueba con bases vectoriales, bases de grafos tradicionales y sistemas relacionales con extensiones de recuperación.
Herramientas relacionadas
Bases de datos e infraestructura de contexto para IA →
Frigade Assist APIDe pago
Respuestas de producto y recorridos guiados para tu agente de IA actual.
Mastra FactoryFreemium
Agentes de programación y revisión humana dentro de un mismo flujo.
Gojiberry AIDe pago
Encuentra prospectos B2B y prepara mensajes personalizados para LinkedIn y correo electrónico.
MagicSlidesFreemium
MagicSlides convierte un tema, texto o material existente en una presentación con IA que puedes revisar y modificar
RelaticleFreemium
Un CRM de código abierto para relacionar clientes, oportunidades y próximas tareas.