LightPDFFreemium
Edytor PDF AI, konwerter i czat dokumentów na web, desktop i mobile
Invofox — OCR faktur i danych z dokumentów
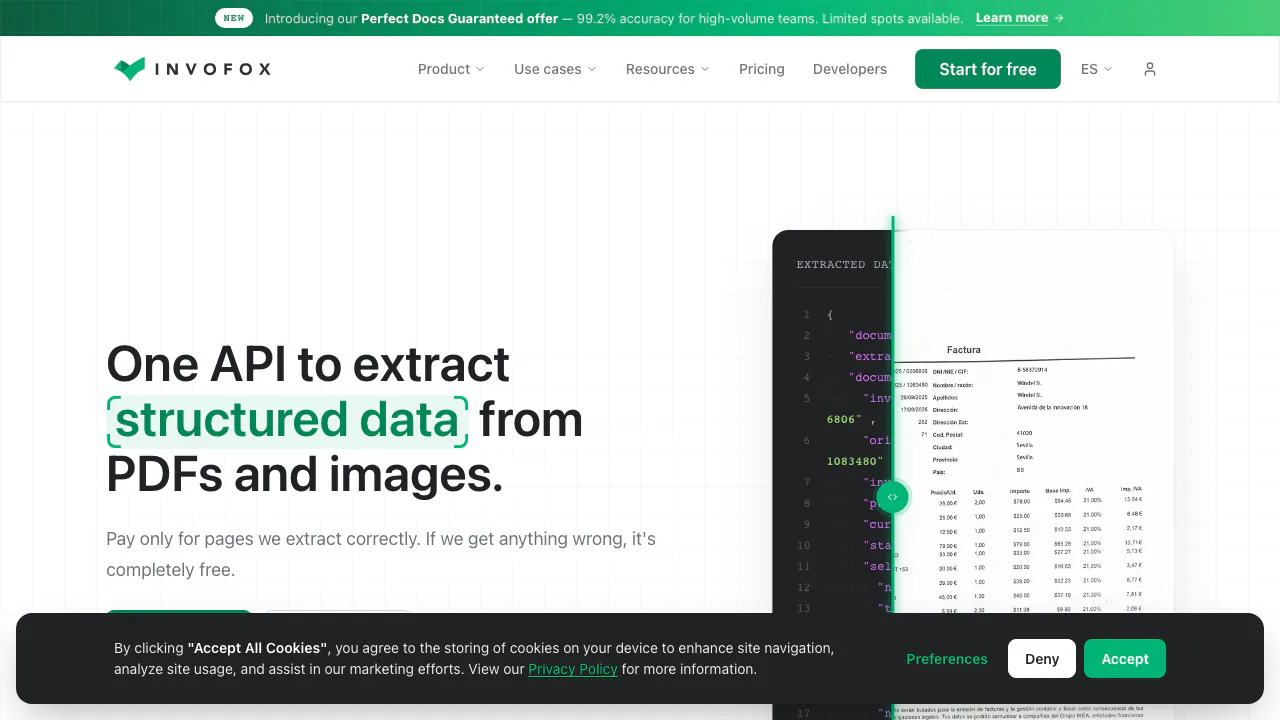
Zamień faktury, pliki PDF i skany w uporządkowane dane JSON.
Do czego służy Invofox? Proste wyjaśnienie
Invofox odczytuje faktury, pliki PDF i obrazy, a następnie zwraca uporządkowane dane JSON. Zamiast przepisywać dostawcę, datę, podatki i kwoty, aplikacja może przejąć rozpoznane pola. To OCR faktur i ekstrakcja dokumentów dla zespołów tworzących oprogramowanie oraz procesy finansowe i operacyjne.
Producent wymienia również paragony, paski wynagrodzeń, wyciągi bankowe, rachunki za media i umowy. Dane trzeba następnie włączyć do własnego procesu kontroli i księgowania. Nie potwierdzono połączenia Invofox z KSeF, więc samej funkcji OCR nie należy traktować jako obsługi tego systemu.
Pierwszy dokument: od klucza do wyniku
- Utwórz konto i otwórz środowisko. W API and Webhooks wygeneruj klucz.
- Odczytaj identyfikator lub alias w Document Types.
- Wyślij multipart do
POST https://api.invofox.com/v1/ingest/uploads, z nagłówkiemx-api-key, plikiemfilesi poleminfozawierającymtype. - Zachowaj
documentId. Odbierzdocument.processedprzez Webhook albo podczas testu odpytujGET /documents/{documentId}. - Porównaj status, pewność i pola z oryginałem. Poprawki można przesłać do
PUT /documents/{id}.
Przetwarzanie jest asynchroniczne: odpowiedź na wysłanie pliku nie jest jeszcze gotowym wynikiem. Obsłuż także file.rejected, ponieważ plik uszkodzony, zabezpieczony hasłem lub nieobsługiwany może nie utworzyć dokumentu. Szczegóły zawiera oficjalna instrukcja API.
Pozycje faktur i pakiety PDF
Model faktury obejmuje nagłówki, kontrahentów, daty, podatki i sumy oraz pozycje z opisem, ilością, ceną jednostkową i kwotą wiersza. Walidacja pomaga wykrywać niezgodności między pozycjami a sumą. Podczas oceny sprawdź pełny zestaw pól potrzebny w swoim systemie, a nie tylko końcową kwotę.
Splitter rozdziela logiczne dokumenty w jednym PDF. Classifier rozpoznaje skonfigurowane typy; nieznany typ może zostać odrzucony lub przekierowany do domyślnego. Przy dzieleniu odpowiedź początkowa zawiera importId, a import.processed oznacza koniec całego importu. Własne schematy wymagają uzgodnienia pól i próbek.
Darmowy test a stałe koszty
Stan na 6 października 2026 r.: dostępne jest 500 bezpłatnych stron na jednorazową ocenę, bez miesięcznego odnawiania. Starter ma cenę od $500 miesięcznie przy rozliczeniu rocznym, do 5 000 stron miesięcznie. Kwoty dolarowe ze strony angielskiej są szacunkowe; zależą od złożoności, wolumenu i integracji. Scale i Enterprise wymagają indywidualnej wyceny.
Zwykle rozliczane są strony, w części procesów Enterprise — dokumenty. Oferta zwrotu kosztu błędnego odczytu wskazuje próg miliona stron rocznie. Sprawdź aktualny cennik i warunki.
Retencja i wykorzystanie poprawek
Standardowa retencja wspiera audyt, diagnostykę i ulepszanie modeli; przesyłane poprawki zasilają trening. Zerowa retencja jest opcją dla Scale i Enterprise, którą trzeba aktywować. W tym trybie dokumenty i wyniki są usuwane po dostarczeniu, a zachowanie anonimowych próbek treningowych wymaga dodatkowej zgody.
Brak historii utrudnia późniejsze odtwarzanie błędów. Przed wysłaniem danych poufnych porównaj zasady zerowej retencji z warunkami swojego wdrożenia.
Najczęstsze pytania
Czym różni się to od zwykłego OCR?
Wynik obejmuje nazwane pola i tablice pozycji, nie tylko tekst. Klasyfikacja i walidacja uzupełniają odczyt, a schemat określa typ dokumentu.
Czy mogę stale korzystać bez opłat?
Opublikowany limit jest jednorazowym testem. Regularne użycie wymaga odpowiedniej płatnej oferty.
Czy integracja wymaga własnego kodu?
Poza REST API dostępne jest oficjalne połączenie Zapier, z kluczem, wyzwalaczem, akcją ekstrakcji i mapowaniem pól.
Oficjalne materiały
- Konfiguracja Zapier: przesyłanie wyników do innych aplikacji.
- Kontakt z Invofox: własne dokumenty, wolumen i warunki przetwarzania.
Podobne narzędzia
Narzędzia zwiększające produktywność i dokumenty AI →
Photo to TextFreemium
Wyodrębniaj edytowalny tekst z obrazów i PDF przez OCR online
HemoryFreemium
Odnajduj ustalenia z rozmów i wykorzystuj je w pracy z AI.
DictantorZa darmo
Nagrywaj rozmowy i wracaj do konkretnych słów na urządzeniach Apple.
Napkin AIFreemium
Zmieniaj tekst w edytowalne diagramy, infografiki i prezentacje
scitePłatne
Sprawdź, czy publikacje wspierają, podważają lub tylko cytują wynik