LightPDFЕсть бесплатный тариф
AI-редактор PDF, конвертер и чат с документами в вебе, на ПК и мобильных
Invofox — распознавание счетов и данных из документов
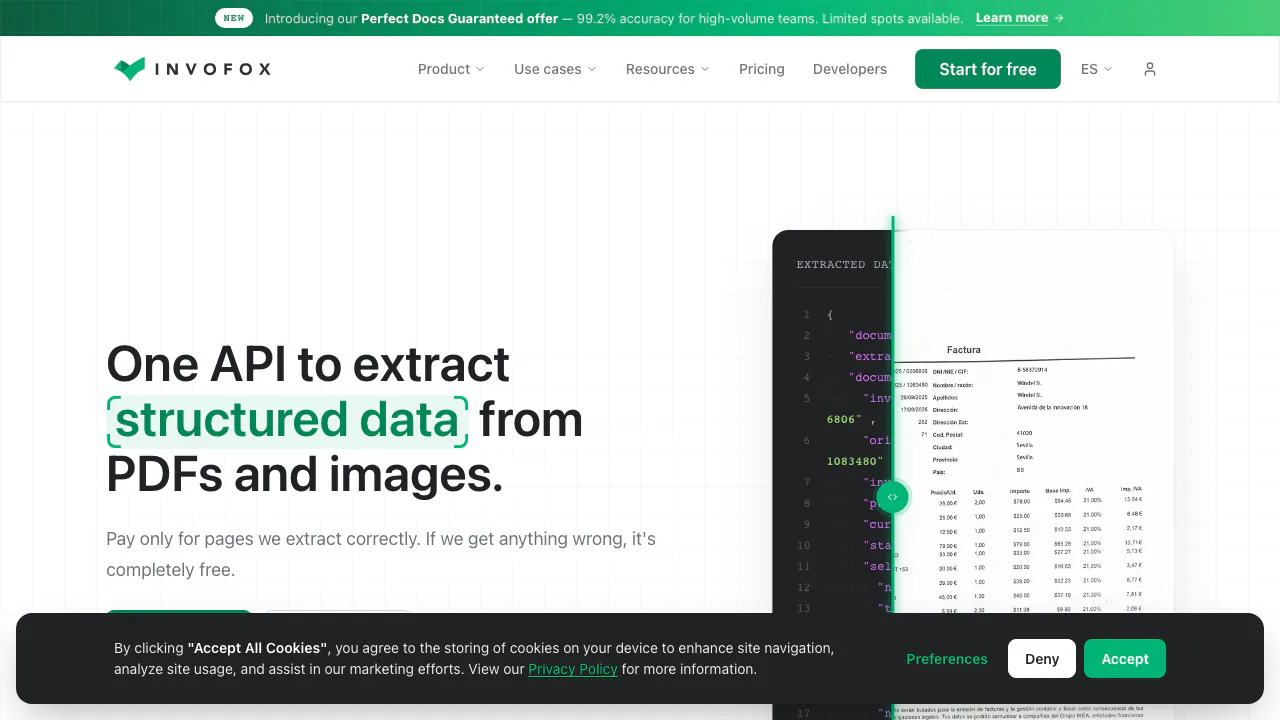
Преобразуйте счета, PDF и сканы в структурированные данные JSON.
Для чего нужен Invofox простыми словами?
Invofox распознаёт счета, PDF и изображения и возвращает их данные в формате JSON. Вместо ручного ввода поставщика, даты, налогов, итоговой суммы и строк документа ваша программа получает готовые поля. Сервис предназначен прежде всего для разработчиков и команд, которые регулярно обрабатывают входящие документы.
Среди заявленных сценариев есть чеки, расчётные листки, банковские выписки, коммунальные счета и договоры. Извлечение данных не означает их автоматическое проведение в учётной системе: дальнейшие проверки и действия нужно настроить отдельно.
Проверять не только сумму, но и строки
Модель счёта извлекает реквизиты сторон, даты, налоговые значения и итоги. Строки содержат описание, количество, цену и сумму; проверки помогают выявлять расхождения между строками и итогом. Для оценки полезны реальные документы разных поставщиков и заранее определённый список обязательных полей.
Splitter делит общий PDF на отдельные логические документы. Classifier распознаёт настроенные типы. Неизвестный тип может быть отброшен либо передан модели по умолчанию — это зависит от среды. Поддержку конкретных российских форм и интеграций следует подтверждать отдельно.
Как пройти путь от файла до JSON
- Создайте аккаунт и откройте среду. Выпустите ключ в API and Webhooks.
- Найдите ID или псевдоним типа в Document Types.
- Отправьте multipart на
POST https://api.invofox.com/v1/ingest/uploads: заголовокx-api-key, файлfilesиinfoс полемtype. - Сохраните
documentId. Получите событиеdocument.processedчерез Webhook или используйтеGET /documents/{documentId}для тестового опроса. - Сверьте статус, уверенность и поля с оригиналом; исправления отправляются через
PUT /documents/{id}.
Обработка асинхронная: подтверждение загрузки ещё не является результатом. Обрабатывайте file.rejected для повреждённых, защищённых или неподдерживаемых файлов. В режиме Splitter сначала возвращается importId, а завершение всей пачки обозначается import.processed. Структуры ответов описаны в официальном руководстве API.
Бесплатная проверка и оплата
Проверено 6 октября 2026 года: опубликован разовый пробный объём 500 страниц, без ежемесячного восстановления. Starter указан от $500 в месяц при годовой оплате, до 5 000 страниц ежемесячно. Это ориентировочные долларовые цены англоязычного сайта; итог зависит от сложности, объёма и интеграции. Scale и Enterprise рассчитываются индивидуально. Региональные способы оплаты отдельно не подтверждены.
Обычно оплачиваются страницы, в некоторых Enterprise-процессах — документы. Предложение о возврате стоимости ошибочной обработки на странице тарифов ограничено объёмом от миллиона страниц в год. Уточняйте действующие цены и условия.
Что происходит с загруженными данными?
Обычное хранение поддерживает аудит, диагностику и улучшение; переданные исправления используются для обучения моделей. Нулевое хранение — отдельно включаемая опция Scale и Enterprise. В этом режиме документы и результаты удаляются после передачи; сохранение обезличенного обучающего примера требует дополнительного согласия.
Без истории нельзя так же удобно исследовать прошлые ошибки. До отправки конфиденциальных данных проверьте условия нулевого хранения и фактическую конфигурацию договора.
Частые вопросы
Это только распознавание текста?
Нет. Сервис возвращает именованные поля и массивы строк, дополняя распознавание классификацией и проверками. Схема зависит от настроенного типа документа.
Можно пользоваться бесплатно постоянно?
Опубликованный лимит предназначен для первоначальной оценки. Регулярная обработка требует подходящих платных условий.
Обязательно писать собственную интеграцию?
Помимо REST API доступно официальное подключение Zapier: ключ, событие запуска, извлечение и сопоставление полей с целевым приложением.
Официальные ресурсы
- Настройка Zapier: передача извлечённых данных другим приложениям.
- Связаться с Invofox: собственные типы, объёмы и требования к данным.
Похожие нейросети
ИИ для документов и продуктивности →
Photo to TextЕсть бесплатный тариф
Онлайн-OCR для извлечения печатного и рукописного текста, таблиц и структуры из фото, сканов и PDF.
HemoryЕсть бесплатный тариф
Находите договорённости и используйте их как контекст для ИИ.
DictantorБесплатно
Записывайте разговоры и находите нужные слова вместе с исходным звуком.
Napkin AIЕсть бесплатный тариф
Превращайте текст в редактируемые схемы, инфографику и презентации
sciteПлатно
Узнайте, подтверждают, оспаривают или просто упоминают статью