
Overmind부분 무료
에이전트 데이터를 준비하고 특화 모델을 학습해 결과를 검증하세요.
ContextGem: Python 기반 문서 데이터 추출
Python과 AI 모델로 문서에서 구조화된 데이터를 추출하고 원문 근거를 확인하는 오픈 소스 도구.
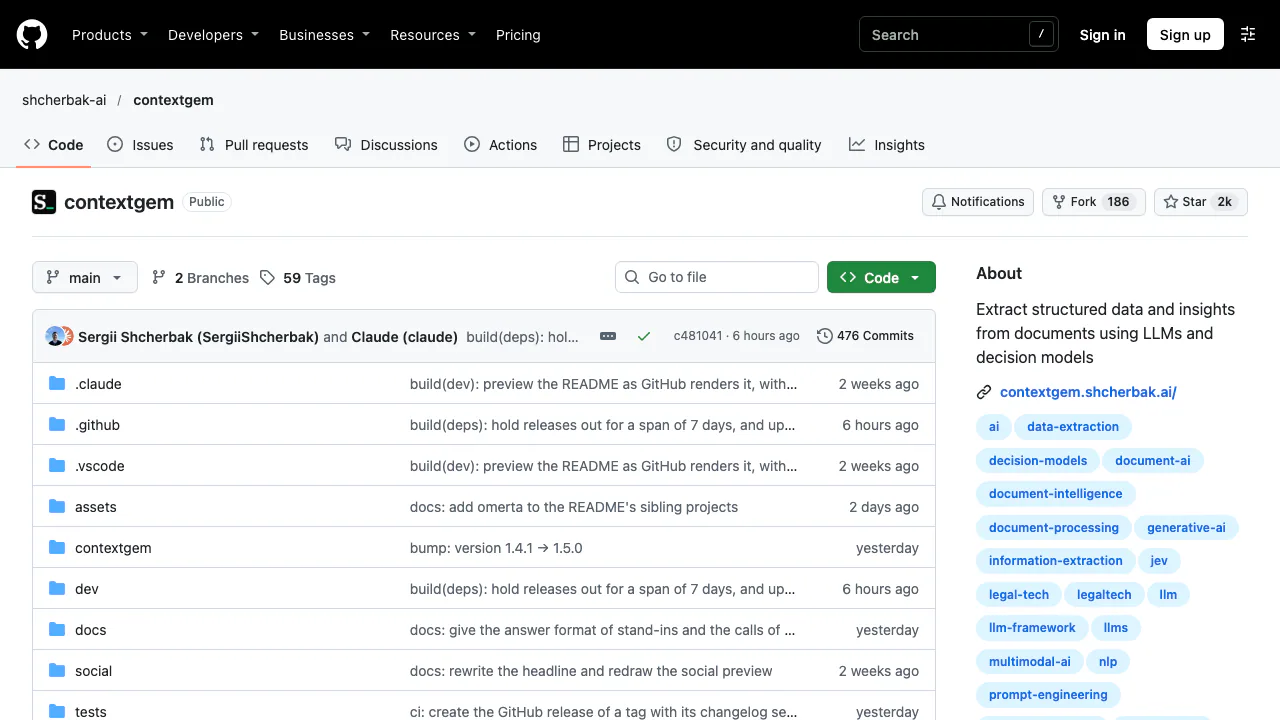
ContextGem은 Shcherbak AI AS가 개발하는 무료 오픈 소스 Python 프레임워크입니다. LLM과 의사결정 모델을 이용해 문서에서 구조화된 정보를 추출합니다. 필요한 내용을 설명하면 프레임워크가 프롬프트, 데이터 모델, 출력 형식 검증을 처리합니다.
쉽게 설명하면 ContextGem은 무엇을 하나요?
계약서마다 지급 기한, 해지 조건, 월 이용료를 찾아 업무 시스템에 옮겨야 한다고 생각해 보세요. 개발자가 항목과 자료형을 정의하면 ContextGem이 문서마다 같은 규칙을 적용합니다. 결과는 요약문뿐 아니라 날짜, 숫자, 라벨, JSON 객체처럼 프로그램이 사용할 수 있는 값이 됩니다.
Python으로 문서 처리 기능을 만드는 개발자와 데이터 팀을 위한 도구입니다. 모델 설정, 코드 작성, 결과 검토가 필요합니다. 프로젝트 사이트는 코드와 문서를 제공하며, 파일을 올리면 바로 쓸 수 있는 일반적인 호스팅 채팅 서비스와는 사용 방식이 다릅니다.
PDF에서 첫 추출 결과를 얻는 순서
pip install -U contextgem으로 설치합니다. 파일 변환이 필요하면pip install -U "contextgem[docling]"을 사용합니다.- 텍스트는
Document(raw_text=...)로 만듭니다. 파일은 Docling의DocumentConverter().convert(file)로 변환한 뒤Document.from_docling(result.document)에 전달합니다. - Aspects와 Concepts에 항목 설명, 자료형, 필요한 출처 참조를 지정합니다.
DocumentLLM에 지원 모델과 인증 정보 또는 로컬 엔드포인트를 설정합니다.doc = llm.extract_all(doc)을 실행하고 반환된 문서의get_concept_by_name(...).extracted_items를 읽습니다.- 정답을 알고 있는 표본에서 값과 출처를 비교합니다. 누락된 항목과 다른 문서 배치도 시험한 뒤 처리량을 늘립니다.
공식 시작 안내에서 전체 예제를 볼 수 있습니다. Docling 연동 문서는 PDF, DOCX, PPTX, XLSX, HTML 등의 변환과 구조 및 가능한 페이지 참조 보존을 설명합니다. 입력 변환의 오류는 추출 결과에도 영향을 줍니다.
주제별 원문과 구조화된 필드를 구분하기
Aspect는 지급 조건처럼 특정 주제와 관련된 원문 부분을 선택합니다. Concept는 지급 일수나 요금 정보처럼 값 또는 판단을 추출합니다. 문서 전체나 특정 Aspect에 적용할 수 있고 하위 주제도 구성할 수 있습니다.
문자열, 숫자, 날짜, 불리언, 라벨, 평점, JSON 객체를 지원합니다. LLM 추출에서는 문단 또는 문장 참조와 필요한 설명을 요청할 수 있습니다. 참조는 원문으로 돌아가 확인하는 데 도움이 되지만, 모델의 해석이 맞다는 보장은 아닙니다. 중요한 금액과 날짜는 원문 및 업무 규칙으로 검증해야 합니다.
로컬 LLM과 의사결정 모델 선택
LiteLLM을 통해 문서에 안내된 클라우드 제공자와 Ollama, LM Studio 같은 로컬 백엔드를 연결할 수 있습니다. LLM은 열린 답변, 다양한 값, 지원되는 이미지 입력에 적합합니다. 작은 모델은 복잡한 지시를 잘 따르는지 실제 문서로 시험해야 합니다.
의사결정 모델은 참·거짓, 지정된 라벨, 평가 단계 같은 닫힌 질문과 텍스트 Aspect 선택을 처리합니다. 답변 후보의 확률과 설정 가능한 임계값을 제공하며 자유로운 텍스트는 생성하지 않습니다. 이미지나 임의 JSON 처리까지 LLM과 같은 기능이라고 볼 수 없습니다. 모델 그룹은 역할별로 작업을 분배하고 대체 모델을 설정할 수 있습니다.
무료 범위와 문서 데이터의 이동 경로
2026년 10월 29일 확인 기준으로 프레임워크는 Apache 2.0 라이선스의 무료 소프트웨어입니다. 상업적 사용은 라이선스 조건을 따릅니다. 클라우드 API와 로컬 하드웨어, 운영에는 별도 비용이 들 수 있으며 모든 모델에 공통인 무료 호출량이나 문서당 요금을 제공하는 것은 아닙니다.
공식 보안 정책은 ContextGem이 원격 측정 데이터를 수집하지 않으며, 문서와 생성한 프롬프트를 환경 내 LiteLLM을 통해 설정한 모델에만 보낸다고 설명합니다. 클라우드 제공자의 보관 정책을 확인하고 로컬 엔드포인트와 클라우드 대체 설정도 검토하세요. 의존성, 문장 분할 모델, 가격 정보의 공개 다운로드는 여전히 발생할 수 있어 로컬 추론이 완전한 오프라인 환경을 뜻하지는 않습니다.
추출 규칙 재사용과 Agent 연동
ExtractionPipeline은 주제와 항목 정의를 재사용하게 해 줍니다. 문서, 파이프라인, 지원 모델 설정은 직렬화할 수 있습니다. to_dict()와 to_json()으로 결과를 넘길 수 있지만 데이터베이스 저장이나 스프레드시트 생성은 애플리케이션에서 구현해야 합니다.
Agent 작업 흐름 안내에는 입력 시 메타데이터 추출, 호출 가능한 도구, 분기 판단 사례가 있습니다. 출력 언어 설정은 문자열 답변과 설명에 적용되고 출처는 원문 언어를 유지합니다.
ContextGem은 개별 문서를 깊이 분석하며 문단 묶음으로 나눠 처리할 수 있습니다. 문서 모음 전체를 검색하거나 여러 문서에 걸친 질의는 자체적으로 제공하지 않으므로 별도의 검색 시스템이 필요합니다. 모델과 분할 방식에 따라 품질, 시간, 비용이 달라집니다.
자주 묻는 질문
모든 사용 비용이 무료인가요?
프레임워크는 무료입니다. 모델 API, 하드웨어, 운영 비용은 별도이며 무제한 무료 추론이 포함되지는 않습니다.
PDF와 Word 문서를 처리할 수 있나요?
문서화된 흐름은 Docling 변환 후 Document.from_docling(result.document)를 사용합니다. 변환 결과와 추출한 필드의 근거를 확인하세요.
비공개 문서에 로컬 모델을 쓸 수 있나요?
Ollama와 LM Studio 등 지원 백엔드를 쓸 수 있습니다. 모델 품질, 네트워크 연결, 클라우드 대체 경로를 점검해야 합니다.
문서 모음 검색에서 RAG를 대체하나요?
개별 문서 분석에 집중합니다. 모음 검색과 여러 파일을 대상으로 한 검색에는 다른 구성 요소가 필요합니다.
공식 자료와 개발자 커뮤니티
- 설치 요구 사항: Python 3.11–3.14, Intel Mac 예외와 Alpine/musl 제약.
- 지원 모델: 로컬·클라우드 연결.
- GitHub Discussions: 구현 관련 질문.
- 문제 및 기능 요청: 오류와 제안.
- 버전 1 마이그레이션: 이전 버전 통합의 변경 사항.
비슷한 도구
AI 생산성 및 문서 도구 →
Off Grid AI부분 무료
내 기기에서 대화하고 문서를 확인하는 로컬 AI 도우미
Paddock무료
내 VPS에서 코딩 에이전트에 Linux 컴퓨터와 제어 가능한 실행 환경을 제공합니다.
tabsh무료
로컬 터미널과 여러 프로젝트의 작업 상태를 한곳에 모으세요
Telegram부분 무료
여러 기기에서 대화하고 커뮤니티와 봇 서비스를 연결하는 클라우드 메신저.
OpenStatus부분 무료
업타임 모니터링과 AI 장애 대응을 한곳에서