
OvermindMiễn phí một phần
Biến dữ liệu tác tử thành mô hình chuyên biệt có kết quả kiểm chứng được.
ContextGem: trích xuất dữ liệu tài liệu bằng Python
Trích xuất dữ liệu có cấu trúc từ tài liệu bằng Python và AI, kèm tham chiếu để kiểm tra nguồn.
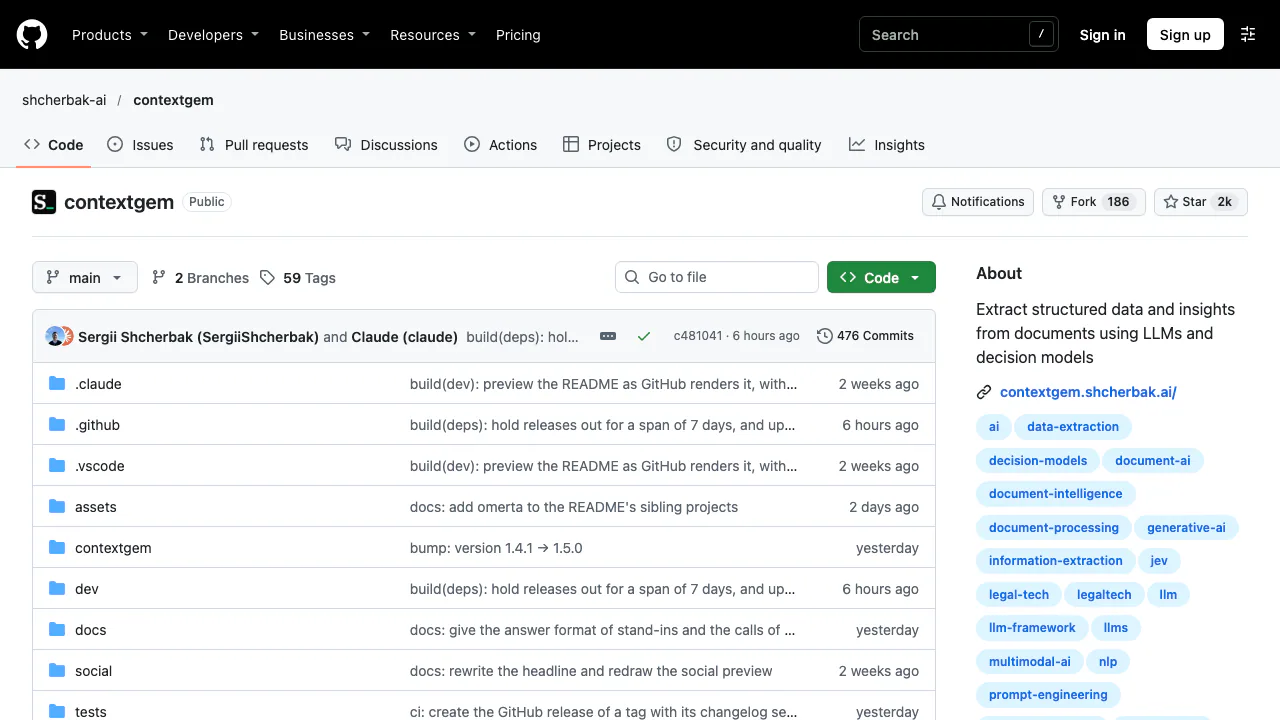
ContextGem là framework Python miễn phí, mã nguồn mở do Shcherbak AI AS phát triển để trích xuất thông tin có cấu trúc từ tài liệu. Bạn mô tả dữ liệu cần lấy và chọn LLM hoặc mô hình quyết định; framework tạo prompt, tổ chức mô hình dữ liệu và kiểm tra định dạng đầu ra.
ContextGem dùng để làm gì? Giải thích dễ hiểu
Giả sử bạn cần ghi lại thời hạn thanh toán, điều kiện chấm dứt và phí hằng tháng từ các hợp đồng. Lập trình viên định nghĩa trường dữ liệu và kiểu giá trị, rồi dùng ContextGem xử lý từng tài liệu theo cùng quy tắc. Kết quả có thể là ngày, số, nhãn hoặc đối tượng JSON để ứng dụng khác sử dụng.
Đây là công cụ xây dựng quy trình tài liệu bằng Python. Bạn vẫn cần viết mã, cấu hình mô hình và kiểm tra kết quả. Trang dự án cung cấp mã nguồn và hướng dẫn, không phải dịch vụ phổ thông chỉ cần tải tệp lên để trò chuyện.
Tách đoạn theo chủ đề và lấy trường dữ liệu
Aspect chọn các đoạn gốc về một chủ đề, chẳng hạn điều khoản thanh toán. Concept lấy giá trị hoặc đánh giá cụ thể như số ngày thanh toán hoặc đối tượng chứa phí dịch vụ. Concept có thể áp dụng cho cả tài liệu hoặc một Aspect; cũng có thể tạo chủ đề con.
Các kiểu được hỗ trợ gồm văn bản, số, ngày, boolean, nhãn, mức đánh giá và đối tượng JSON. Với LLM, bạn có thể yêu cầu tham chiếu đến đoạn hoặc câu, cùng phần giải thích khi cần. Chúng giúp quay lại nguồn để kiểm tra, nhưng không bảo đảm cách hiểu của mô hình là đúng. Các số tiền, ngày và quyết định quan trọng cần đối chiếu bản gốc và quy tắc nghiệp vụ.
Thực hiện lần trích xuất đầu tiên từ PDF
- Cài
pip install -U contextgem. Nếu cần chuyển đổi tệp, dùngpip install -U "contextgem[docling]". - Với văn bản, tạo
Document(raw_text=...). Với tệp, dùng Docling quaDocumentConverter().convert(file), rồi gọiDocument.from_docling(result.document). - Định nghĩa Aspects và Concepts với mô tả rõ ràng, kiểu dữ liệu và yêu cầu tham chiếu.
- Cấu hình
DocumentLLMbằng mô hình được hỗ trợ, thông tin xác thực hoặc endpoint cục bộ. - Chạy
doc = llm.extract_all(doc)và đọcget_concept_by_name(...).extracted_itemstừ tài liệu trả về. - So sánh giá trị và nguồn với một mẫu đã biết đáp án. Thử trường bị thiếu và nhiều bố cục trước khi xử lý số lượng lớn.
Hướng dẫn bắt đầu chính thức có ví dụ đầy đủ. Tích hợp Docling giải thích PDF, DOCX, PPTX, XLSX và HTML cùng cấu trúc và tham chiếu trang có thể giữ lại. Lỗi chuyển đổi đầu vào có thể ảnh hưởng kết quả trích xuất.
Tái sử dụng quy trình và tích hợp tác tử
ExtractionPipeline lưu các định nghĩa chủ đề và trường để dùng lại. Tài liệu, pipeline và cấu hình mô hình được hỗ trợ có thể tuần tự hóa. to_dict() và to_json() giúp chuyển kết quả cho ứng dụng; việc ghi cơ sở dữ liệu hoặc tạo bảng tính vẫn do bạn triển khai.
Các ví dụ quy trình tác tử trình bày trích xuất siêu dữ liệu khi nhập, công cụ có thể gọi và câu hỏi đóng tại điểm quyết định. Có thể chọn ngôn ngữ cho giá trị văn bản và giải thích, còn tham chiếu giữ ngôn ngữ gốc.
ContextGem đọc sâu từng tài liệu, có thể theo nhóm đoạn văn. Nó không tự tìm kiếm cả kho hay trả lời truy vấn liên tài liệu. Những nhu cầu đó cần thêm hệ thống truy xuất; cách chia đoạn và mô hình ảnh hưởng chất lượng, thời gian và chi phí.
Miễn phí đến đâu và dữ liệu được gửi đi đâu?
Kiểm tra ngày 29 tháng 10 năm 2026: framework miễn phí theo giấy phép Apache 2.0, với sử dụng thương mại tuân theo điều kiện giấy phép. API đám mây, phần cứng và vận hành cục bộ có thể phát sinh phí riêng. Không có giá chung trên mỗi tài liệu hay hạn mức miễn phí cho mọi mô hình.
Chính sách bảo mật chính thức cho biết ContextGem không thu thập telemetry. Tài liệu và prompt được gửi tới mô hình đã cấu hình qua LiteLLM chạy trong môi trường của bạn. Với đám mây, kiểm tra chính sách lưu giữ của nhà cung cấp. Với cục bộ, kiểm tra endpoint và mô hình dự phòng trên đám mây. Cài thư viện, mô hình tách câu và dữ liệu giá vẫn có thể cần tải tài nguyên công khai.
Chọn LLM hay mô hình quyết định?
LiteLLM kết nối các nhà cung cấp đám mây được ghi trong tài liệu và backend cục bộ như Ollama, LM Studio. LLM phù hợp câu trả lời mở, nhiều kiểu trường và ảnh được hỗ trợ. Cần thử mô hình nhỏ với tài liệu thực để đánh giá khả năng tuân thủ chỉ dẫn phức tạp.
Mô hình quyết định xử lý câu hỏi đóng: đúng/sai, nhãn hoặc mức đánh giá, đồng thời chọn Aspects dạng văn bản. Chúng trả xác suất và cho phép đặt ngưỡng, không tạo văn bản tự do. Không nên coi chúng có đầy đủ khả năng ảnh hoặc JSON tùy ý của LLM. Nhóm mô hình phân công tác vụ theo vai trò và hỗ trợ phương án dự phòng.
Câu hỏi thường gặp
Có hoàn toàn miễn phí không?
Framework miễn phí. API mô hình, phần cứng và vận hành có thể tính riêng; giấy phép không bao gồm suy luận miễn phí không giới hạn.
Có lấy dữ liệu từ PDF và Word được không?
Quy trình được hướng dẫn dùng Docling rồi Document.from_docling(result.document). Hãy kiểm tra nội dung chuyển đổi và nguồn của trường đã lấy.
Có thể dùng mô hình cục bộ cho tài liệu riêng tư không?
Có các backend được hỗ trợ như Ollama và LM Studio. Cần kiểm tra chất lượng, kết nối và đường dự phòng lên đám mây.
Có thay RAG để tìm cả kho tài liệu không?
Công cụ tập trung phân tích từng tài liệu. Tìm kiếm kho và truy xuất qua nhiều tệp cần thành phần khác.
Tài nguyên chính thức và cộng đồng
- Yêu cầu cài đặt: Python 3.11–3.14, ngoại lệ Intel Mac và giới hạn Alpine/musl.
- Mô hình được hỗ trợ: tùy chọn cục bộ và đám mây.
- GitHub Discussions: hỏi về triển khai.
- Báo lỗi và đề xuất: vấn đề có thể tái hiện và tính năng.
- Chuyển sang phiên bản 1: thay đổi cho tích hợp cũ.
Công cụ liên quan
Tài liệu điện tử công suất →
Off Grid AIMiễn phí một phần
Trợ lý AI cục bộ cho hội thoại, tài liệu và bộ nhớ công việc tùy chọn
PaddockMiễn phí
Máy tính Linux và sandbox cho tác nhân lập trình trên VPS do bạn quản lý.
tabshMiễn phí
Tập hợp phiên terminal cục bộ và trạng thái công việc của nhiều dự án
TelegramMiễn phí một phần
Nền tảng nhắn tin đám mây cho trò chuyện, cộng đồng và dịch vụ qua bot.
OpenStatusMiễn phí một phần
Giám sát website và thông báo sự cố với trợ lý AI