
Overmind部分免費
把智能體資料轉為可評測、可部署及可下載權重的專用模型。
ContextGem:開源文件資料擷取框架
以 Python 建立文件資料擷取流程,結合大型語言模型、來源參照與本機模型。
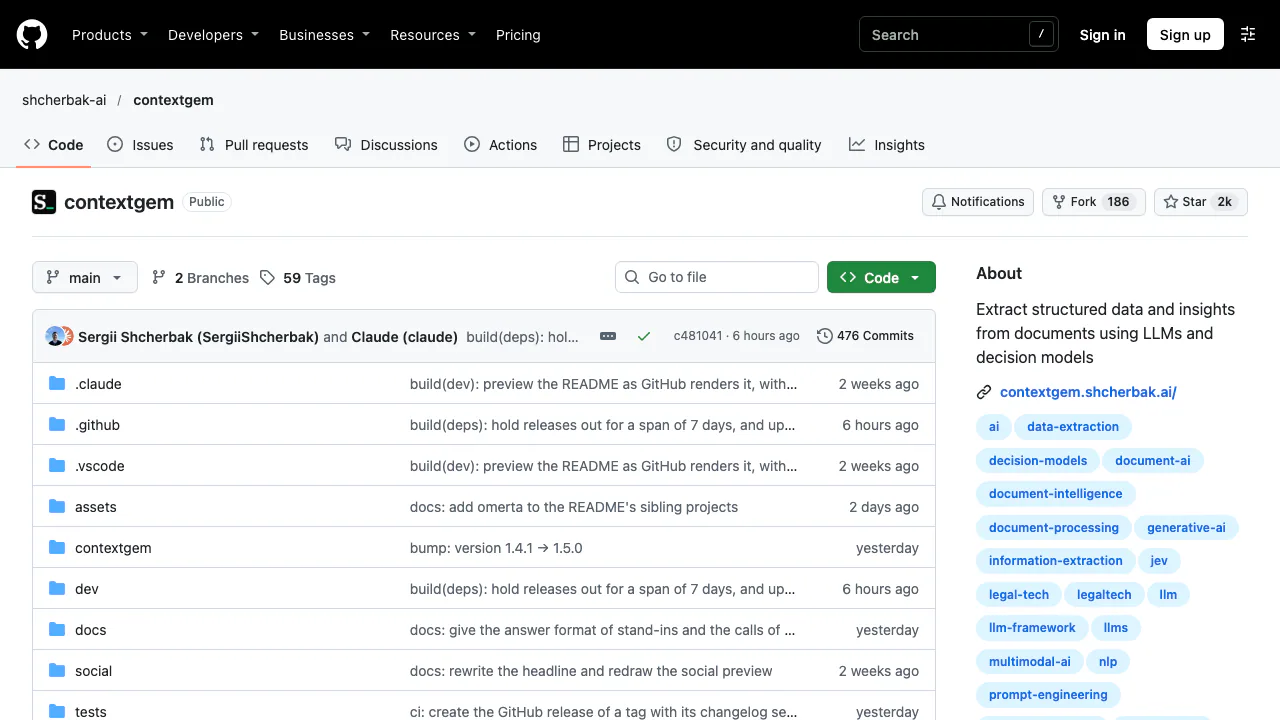
ContextGem 是開源 Python 框架,讓開發者以自然語言描述需求,再由大型語言模型或決策模型從文件擷取資料。它由 Shcherbak AI AS 維護,適合需要把合約、報告等內容轉為明確欄位,並保留核對依據的應用。
白話說明:ContextGem 到底拿來做什麼?
假設公司收到多份服務合約,每份都要找出付款期限、解約條件和月費。ContextGem 讓開發者先設定要讀什麼,再讓模型按照相同規則逐份處理。結果可以是日期、金額、分類或 JSON 物件,而不是只有一段摘要。
你可以把它視為「按指定格式讀文件的程式工具箱」。它處理提示詞、資料模型與驗證,也能按設定附上原文參照。使用者仍需撰寫 Python、配置模型和檢查答案;專案網站主要提供程式碼與文件,並非一般上傳檔案即可使用的託管聊天服務。
從一份 PDF 開始建立擷取流程
先挑一份已知答案的文件,確認每個步驟的輸入與結果,再擴大到更多檔案。
- 準備受支援的 Python。現行文件列出 Python 3.11–3.14;Intel Mac 應使用 3.11–3.13,Alpine/musl 環境另有依賴限制。
- 執行
pip install -U contextgem;需要檔案轉換時,安裝pip install -U "contextgem[docling]"。 - 純文字放入
Document(raw_text=...)。PDF 等檔案先用 Docling 的DocumentConverter().convert(file),再呼叫Document.from_docling(result.document)。 - 定義主題、欄位、資料型別,以及是否需要來源參照與解釋。
- 配置
DocumentLLM的模型、憑證或本機端點,執行doc = llm.extract_all(doc)。 - 從回傳文件的
get_concept_by_name(...).extracted_items取得結果,對照原文,測試缺漏欄位與不同版面。
官方入門範例可用於實作第一個流程。Docling 整合說明涵蓋 PDF、DOCX、PPTX、XLSX、HTML 等檔案,並說明如何保留文件結構與可取得的頁碼。轉換品質會影響後續擷取,複雜表格及掃描內容尤其需要檢查。
擷取主題段落,還是取得結構化欄位?
Aspect 用來找出某主題的原文,例如付款條款。Concept 則取得具體資料或判斷,例如付款天數、日期、標籤或費用明細。Concept 可以針對整份文件,也能只分析某個 Aspect;子主題有助於縮小分析範圍。
支援的概念型別包括文字、數值、日期、布林值、標籤、評分及 JSON 物件。若需要接入資料庫,這種明確型別通常比再次解析一段生成文字更容易處理。但應用仍需自行實作資料儲存、欄位檢核與業務規則。
對 LLM 擷取開啟段落或句子參照後,審核者能回到來源查看;必要時也能要求理由。來源參照提供核對路徑,並不保證模型理解正確,重要數字與判斷仍應人工或透過業務規則確認。
重複使用規則,串接既有應用
ExtractionPipeline 可保存同類文件需要的 Aspects 和 Concepts。文件、流程及受支援的模型設定可以序列化,利用 to_dict()、to_json() 等方式交給後續程式處理。這適合建立一致的資料匯入流程,但不代表自帶完整的試算表匯出或審核系統。
官方 Agent 工作流文件展示入庫時擷取中繼資料、讓 Agent 呼叫擷取工具,以及以封閉問題決定流程分支等用法。輸出語言設定可控制文字答案與理由的語言,原文參照則維持原來語言。
ContextGem 深入分析單份文件,也可按段落分批。它不自行搜尋整個文件庫;如果需求是跨檔案查詢,還需搭配檢索系統。應以自己的文件驗證長文分批策略、速度、費用及漏擷取情況。
本機 LLM、雲端模型與決策模型如何分工?
透過 LiteLLM,可使用官方支援的雲端模型,以及 Ollama、LM Studio 等本機後端。LLM 適合開放式答案、多種欄位型別和受支援的圖像輸入;小型模型是否能遵循複雜規則,需要樣本測試。
決策模型處理的是封閉問題,例如是非判斷、指定標籤或評分等級,也能選取文字 Aspect。它提供候選答案機率與可設定的門檻,不產生開放式文字,也不能直接視為具備 LLM 的所有圖像或 JSON 擷取能力。
模型組可按角色路由任務並配置備援模型。機率適合協助設計複核或分流條件,但門檻應依資料驗證,不能直接當成正確率承諾。
免費、商用與資料隱私的實際界線
截至 2026 年 10 月 29 日,框架採用 Apache 2.0 授權,本身免費,商用須遵守授權條件。雲端推論可能另由模型供應商計費;本機部署也有硬體、算力與維運成本,沒有適用所有模型的統一免費額度。
官方安全政策表示 ContextGem 不收集遙測,文件與產生的提示詞只送往設定的模型,由環境內執行的 LiteLLM 負責呼叫。雲端服務的保留與處理條件應查看各供應商政策。本機配置則要檢查端點與雲端備援。
安裝依賴、首次下載斷句模型,以及更新價格資訊等仍可能連線取得公開資料。因此「本機推論」不代表所有環節預設離線,敏感文件應在確認實際部署條件後處理。
常見問題
ContextGem 免費就代表完全沒有使用費嗎?
框架免費開源,模型 API、硬體及部署維護成本另計。沒有一個通用的免費推論方案可涵蓋所有供應商。
PDF 或 Word 檔案如何接入?
先透過 Docling 轉換,再傳入 Document.from_docling(result.document)。應檢查轉換後的段落與表格,再核對擷取欄位和參照。
私有文件可以使用本機模型嗎?
可使用官方支援的 Ollama、LM Studio 等後端。仍需確認模型能力、備援路由及下載行為,避免把本機支援誤認為所有隱私條件都已配置完成。
能搜尋整個知識庫嗎?
它主要讀取單份文件,不負責跨文件檢索。可以讓其他系統先找出檔案,再由 ContextGem 擷取其中的結構化資料。
官方資源與開發者社群
- 安裝要求:確認 Python 版本及平台例外。
- 支援的模型:查閱雲端與本機配置。
- GitHub Discussions:討論整合與使用問題。
- 問題追蹤:回報錯誤及功能需求。
- 1.0 遷移說明:舊版應用升級前核對變更。
相關工具
AI生產力和文件工具 →
Off Grid AI部分免費
在自己的裝置使用 AI,離線對話、查閱文件並按需保留工作記憶
Paddock免費
在自己的 VPS 上,為程式開發代理準備可保留的 Linux 電腦與受控沙箱。
tabsh免費
將本機終端機、程式代理與跨專案任務集中檢視
Telegram部分免費
支援多裝置的通訊平台,串連個人對話、社群公告與機器人服務。
OpenStatus部分免費
串接網站監控、狀態公告與 AI 事故協作