
Overmind一部無料
エージェントのデータから専用モデルを作り、結果を検証。
ContextGem:文書から構造化データを抽出
Python と LLM で文書から型付きデータを抽出し、出典を確認できるオープンソース基盤。
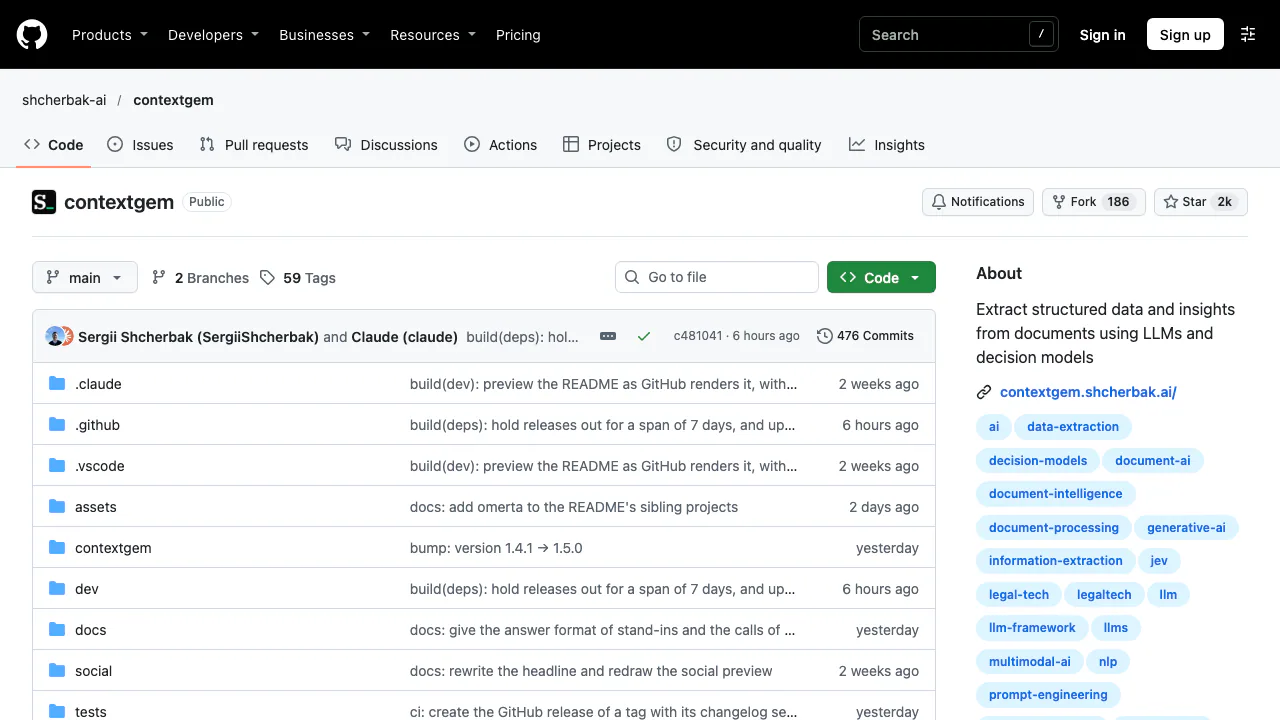
ContextGem は、文書から必要な情報を取り出し、プログラムで扱えるデータに変えるオープンソースの Python フレームワークです。Shcherbak AI AS が開発し、LLM と決定モデルを使った文書処理を支援します。抽出したい内容を説明すると、フレームワークがプロンプトやデータモデル、出力の検証を担当します。
ContextGem は何をするもの?やさしい説明
たとえば複数の契約書から支払期限、解約条件、月額料金を調べたいとします。ContextGem では、開発者が必要な項目と型を定義し、同じルールで文書を処理できます。結果は文章の要約だけでなく、数値、日付、ラベル、JSON オブジェクトなどとして受け取れます。
位置付けは「指定した項目を読むための開発用の道具箱」です。ブラウザーにファイルを置くだけの一般向けサービスではなく、Python の実装とモデルの設定が必要です。人が確認できる形で業務アプリへデータを渡したい場合に向いています。
条項の抽出と、値の抽出を分けて設計する
Aspect は「支払条件」などのテーマに関係する原文を選びます。Concept は「支払日数」や「契約終了日」などの値や判断を取り出します。文書全体に適用することも、特定の Aspect 内で分析することもでき、サブテーマを作ることも可能です。
文字列、数値、日付、真偽値、ラベル、評価、JSON オブジェクトを扱えます。LLM による抽出では、段落や文への参照、必要に応じた理由を設定できます。元の箇所に戻れることは確認に役立ちますが、解釈の正しさを保証するものではありません。重要な金額や日付は元文書と照合してください。
PDF から最初の抽出を実行する手順
- 対応する Python 環境を用意します。現行の案内は 3.11–3.14 で、Intel Mac は 3.11–3.13 を使用します。Alpine/musl 環境には依存パッケージの制約があります。
pip install -U contextgemを実行します。ファイル変換も行う場合はpip install -U "contextgem[docling]"を使います。- テキストは
Document(raw_text=...)に渡します。PDF などは Docling のDocumentConverter().convert(file)で変換し、Document.from_docling(result.document)に渡します。 - 抽出する Aspects と Concepts、型、参照の要否を設定します。
- モデルと認証情報またはローカルエンドポイントを
DocumentLLMに設定し、doc = llm.extract_all(doc)を実行します。 - 戻り値の文書から
get_concept_by_name(...).extracted_itemsを読み、値と出典を確認します。項目がない例や異なるレイアウトでも試します。
公式クイックスタートに実行例があります。Docling 連携の説明では PDF、DOCX、PPTX、XLSX、HTML などを扱い、文書構造や取得可能なページ情報を保持する方法を確認できます。変換ミスがあれば抽出結果にも影響するため、入力内容も点検が必要です。
無料の範囲と、文書データの送信先
2026 年 10 月 29 日確認時点で、フレームワークは無料の Apache 2.0 ライセンスです。商用利用はライセンス条件に従います。クラウドモデルの API 料金やローカル計算資源の費用は別で、全モデル共通の無料利用枠を提供するものではありません。
公式セキュリティ方針では、ContextGem はテレメトリーを収集せず、文書と生成したプロンプトを設定したモデルにだけ送ると説明されています。クラウド利用時は提供元の保存・処理条件を確認してください。ローカル利用でも、依存関係の導入、文分割モデルや価格情報の取得で通信が発生する場合があります。エンドポイントとクラウドへのフォールバックも確認が必要です。
LLM と決定モデルの使い分け
LiteLLM 経由で、対応するクラウドモデルや Ollama、LM Studio などのローカル環境を利用できます。LLM は自由形式の回答、多様な値、対応する画像入力に向きます。小型モデルでは複雑な指示に従えない場合があるため、実際の文書で評価します。
決定モデルは、真偽、指定ラベル、評価段階といった閉じた質問や、テキスト Aspect の選択を処理します。回答候補ごとの確率と判定しきい値を扱い、自由な文章は生成しません。LLM と同じ画像・任意 JSON 抽出機能があるとは限りません。モデルグループでは役割別の振り分けとフォールバックを設定できます。
再利用できる処理と、検索システムとの境界
ExtractionPipeline にテーマと項目を保存し、複数の文書で再利用できます。to_dict() や to_json() で結果を後続のアプリへ渡せますが、データベースへの保存や表計算ファイルの作成はアプリ側で実装します。
エージェント連携ガイドでは、取り込み時のメタデータ抽出、呼び出せるツール、判断地点への組み込みを紹介しています。出力言語の設定は文字列の回答や理由に適用され、参照元の文は元の言語を保ちます。
ContextGem は一つの文書を深く読む設計で、段落単位の分割処理も可能です。文書コレクション全体の検索や複数文書にまたがる質問には、別の検索基盤を組み合わせます。処理単位とモデルの能力によって精度、時間、費用が変わります。
よくある質問
無料で使い続けられますか?
フレームワークは無料です。モデル API、サーバー、ローカルの計算資源は別途必要で、無制限の推論を保証するものではありません。
PDF や Word の情報を抽出できますか?
Docling で変換してから Document.from_docling(result.document) で読み込みます。変換結果と出典の確認が必要です。
機密文書にローカルモデルを使えますか?
対応する Ollama や LM Studio などを設定できます。モデルの品質、外部通信、フォールバック先を確認したうえで運用してください。
RAG の代わりになりますか?
文書単体の抽出を担当します。資料全体の検索は別の仕組みが必要で、検索後の詳細分析として組み合わせられます。
公式資料と開発者コミュニティ
- インストール要件:Python と環境ごとの制約。
- 対応モデル:クラウド・ローカル接続の選択肢。
- GitHub Discussions:導入や実装の相談。
- Issue 一覧:不具合や機能の要望。
- バージョン 1 への移行:0.x から更新する際の変更点。
関連ツール
Ai プロンプト 生成 ツール →
Off Grid AI一部無料
自分の端末で対話や文書の確認ができるローカルAIアシスタント
Paddock無料
自分のVPSで、コーディングエージェントにLinuxの作業用コンピューターを用意。
tabsh無料
ローカルのターミナルと複数プロジェクトの進行状況をまとめて確認
Telegram一部無料
個人の会話、コミュニティ、ボット連携を複数の端末で使えるメッセージサービス。
OpenStatus一部無料
死活監視と利用者への案内を AI とつなぐ