
OvermindFreemium
Préparer vos données, entraîner un modèle et vérifier le résultat.
ContextGem : extraction de données de documents avec Python
Extraire des données structurées de documents avec Python et vérifier les passages sources.
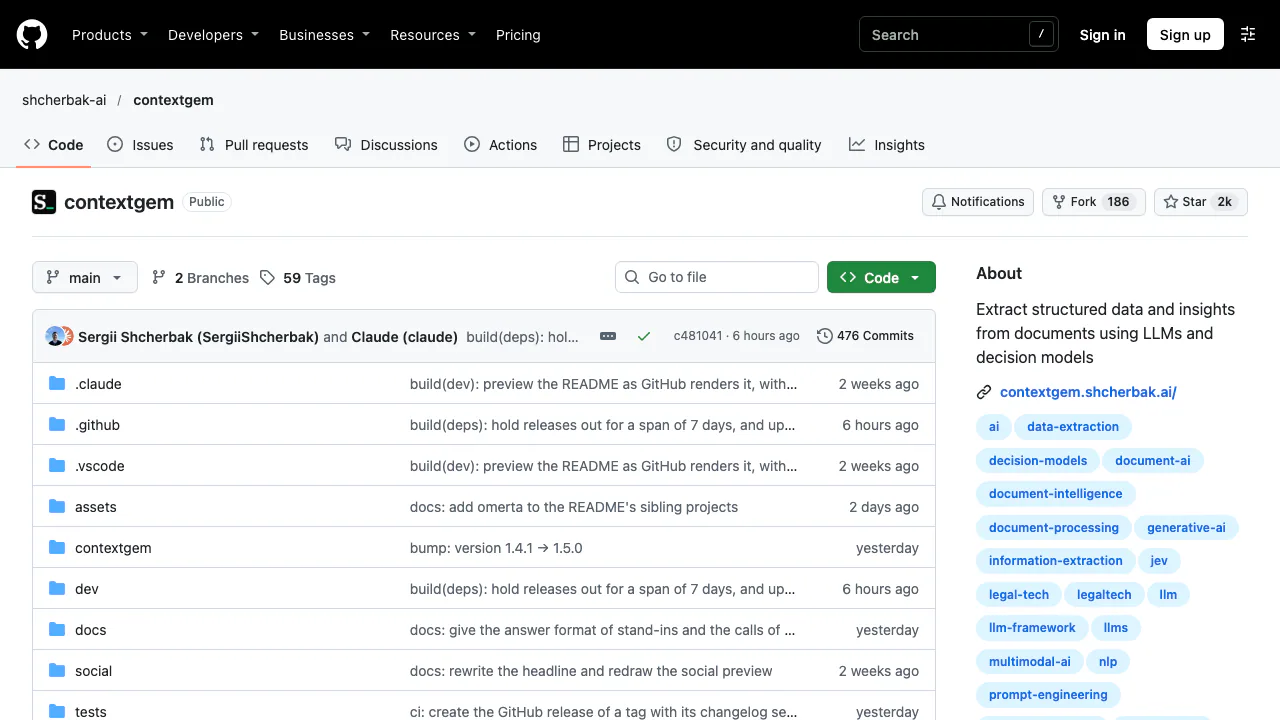
ContextGem est un framework Python gratuit et open source de Shcherbak AI AS. Il extrait des données structurées de documents à l'aide de LLM et de modèles de décision. Vous décrivez les informations recherchées ; le framework construit les prompts, organise les modèles de données et valide le format des sorties.
À quoi sert ContextGem, concrètement ?
Supposons que votre équipe doive relever les délais de paiement, les conditions de résiliation et les montants mensuels dans des contrats. ContextGem permet à un développeur de définir ces champs puis d'appliquer les mêmes règles aux documents. Les réponses deviennent des nombres, des dates, des catégories ou des objets JSON exploitables.
Il s'agit d'une bibliothèque pour construire un traitement documentaire. Il faut prévoir du code Python, un modèle et une vérification des résultats. Le site du projet fournit les ressources de développement, plutôt qu'un service hébergé prêt à l'emploi avec simple dépôt de fichier.
Distinguer les passages d'un thème et les valeurs à extraire
Un Aspect sélectionne les passages originaux concernant un sujet, par exemple les modalités de paiement. Un Concept extrait une valeur ou une appréciation : délai, date, catégorie ou objet contenant plusieurs champs. Il peut porter sur tout le document ou sur un Aspect ; des sous-thèmes permettent d'affiner le contexte.
Les concepts prennent en charge textes, nombres, dates, booléens, étiquettes, notes et objets JSON. Pour les extractions avec LLM, vous pouvez demander des références aux paragraphes ou aux phrases, ainsi que des justifications.
Ces éléments aident à retrouver la source. Ils ne garantissent pas une interprétation exacte : les montants et décisions importants doivent encore être confrontés au document et aux règles métier.
Mettre en place une première extraction de PDF
- Installez
pip install -U contextgem, oupip install -U "contextgem[docling]"pour convertir des fichiers. - Pour du texte, créez
Document(raw_text=...). Pour un fichier, utilisezDocumentConverter().convert(file)de Docling puisDocument.from_docling(result.document). - Définissez les Aspects et Concepts, leurs types et les références nécessaires.
- Configurez
DocumentLLMavec un modèle compatible, ses identifiants ou un endpoint local. - Lancez
doc = llm.extract_all(doc)et lisezget_concept_by_name(...).extracted_itemssur le document retourné. - Vérifiez les valeurs et sources sur un échantillon connu, puis testez les champs absents et les mises en page différentes.
Le guide de démarrage propose des exemples complets. L'intégration Docling couvre notamment PDF, DOCX, PPTX, XLSX et HTML, avec conservation de la structure et des références de page disponibles. Une conversion incorrecte peut dégrader l'extraction.
Choisir entre modèle local, LLM et modèle de décision
Via LiteLLM, ContextGem utilise des fournisseurs cloud documentés et des solutions locales comme Ollama ou LM Studio. Les LLM conviennent aux réponses ouvertes, à différents types de valeurs et aux images prises en charge. Les petits modèles doivent être évalués sur vos documents avant un usage régulier.
Les modèles de décision traitent des questions fermées : oui/non, étiquette ou niveau d'une échelle, ainsi que la sélection d'Aspects textuels. Ils renvoient des probabilités et permettent de régler un seuil ; ils ne rédigent pas de réponse libre et n'ont pas nécessairement les capacités d'image ou de JSON d'un LLM.
Les groupes de modèles orientent les tâches selon leur rôle et autorisent des modèles de repli. Le bon choix dépend de la qualité observée, du délai et du coût réel sur vos propres exemples.
Comprendre le coût et la circulation des données
Au 29 octobre 2026, le framework est gratuit sous licence Apache 2.0, avec utilisation commerciale selon ses conditions. Les appels aux modèles cloud et les ressources locales peuvent coûter séparément. Aucun tarif universel par document ni quota commun à tous les fournisseurs n'est annoncé ici.
La politique de sécurité indique que ContextGem ne collecte pas de télémétrie. Les documents et prompts sont envoyés aux modèles configurés via LiteLLM exécuté dans votre environnement. Avec un fournisseur cloud, vérifiez ses règles de conservation. Avec un modèle local, contrôlez les endpoints et replis cloud. Les dépendances, modèles de segmentation et informations tarifaires peuvent encore nécessiter des téléchargements publics.
Réutiliser un pipeline sans le confondre avec un moteur de recherche
ExtractionPipeline conserve les Aspects et Concepts réutilisables. Documents, pipelines et configurations compatibles peuvent être sérialisés ; to_dict() et to_json() permettent de transmettre les résultats. La base de données ou l'export en tableur reste à intégrer dans votre application.
Les workflows pour agents montrent l'extraction de métadonnées à l'import, l'appel d'un outil d'extraction et les points de décision. Le réglage de langue s'applique aux réponses textuelles et justifications, tandis que les références gardent leur langue d'origine.
ContextGem examine des documents individuels en profondeur, éventuellement par lots de paragraphes. Pour rechercher dans un corpus ou croiser plusieurs documents, ajoutez un système de recherche adapté. Le découpage et le modèle influencent les résultats, le temps et le coût.
Questions fréquentes
Peut-on l'utiliser sans aucun coût ?
Le framework est gratuit. Les API de modèles, le matériel et l'hébergement peuvent être payants ; la licence ne fournit pas d'inférence gratuite illimitée.
Comment extraire des données d'un PDF ?
Passez par Docling, puis Document.from_docling(result.document). Contrôlez la conversion avant de vérifier les champs extraits.
Peut-on traiter des documents privés avec un modèle local ?
Des backends comme Ollama et LM Studio sont pris en charge. Vérifiez leur qualité, les téléchargements et les éventuels replis vers le cloud.
Remplace-t-il un système RAG ?
Il se concentre sur l'analyse d'un document. La recherche dans une collection et la récupération entre documents nécessitent une autre composante.
Ressources officielles et communauté
- Prérequis d'installation : Python 3.11–3.14, exceptions Intel Mac et limites Alpine/musl.
- Modèles pris en charge : options cloud et locales.
- GitHub Discussions : questions de mise en œuvre.
- Suivi des problèmes : bogues et demandes de fonctionnalités.
- Migration vers la version 1 : changements pour les anciennes intégrations.
Outils similaires
Outils de productivité et de documentation de l'IA →
Off Grid AIFreemium
Un assistant local pour vos questions, vos fichiers et votre contexte de travail
PaddockGratuit
Des ordinateurs Linux pour vos agents de code, hébergés sur votre propre VPS.
tabshGratuit
Une vue commune pour les terminaux locaux et les tâches de vos projets
TelegramFreemium
Une messagerie dans le cloud pour échanger, suivre des communautés et connecter des bots.
OpenStatusFreemium
Monitoring et communication d’incident avec assistance IA