
OvermindFreemium
Convierte los datos de tus agentes en modelos que puedes evaluar y desplegar.
ContextGem: extracción de datos de documentos con Python
Extrae datos estructurados de documentos con Python y modelos de IA, y comprueba sus fuentes.
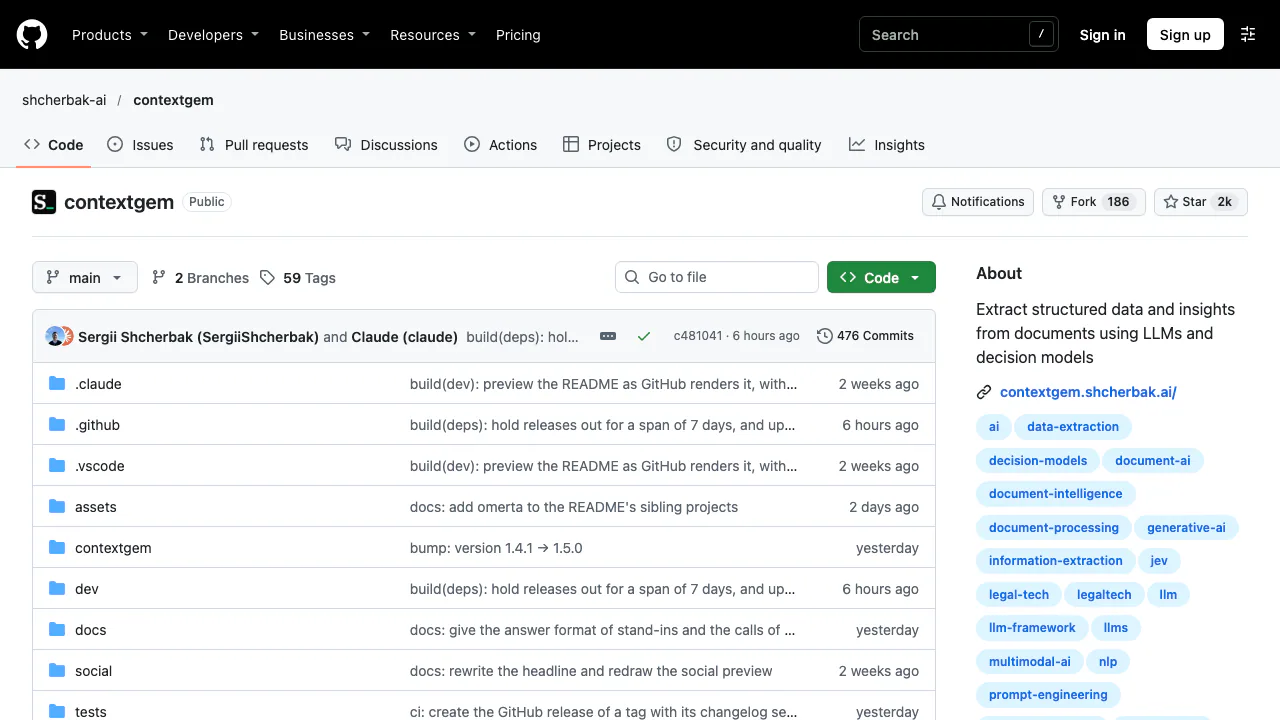
ContextGem es un framework gratuito y de código abierto de Shcherbak AI AS para extraer información estructurada de documentos con Python. Permite describir lo que necesitas y utilizar LLM o modelos de decisión; se encarga de generar los prompts, modelar los datos y validar el formato de las respuestas.
¿Para qué sirve ContextGem? Una explicación sencilla
Imagina que necesitas revisar contratos y registrar plazos de pago, condiciones de cancelación e importes mensuales. Con ContextGem defines los campos y sus tipos para procesar cada documento con las mismas instrucciones. El resultado puede ser una fecha, un número, una etiqueta o un objeto JSON que otra aplicación pueda utilizar.
Es una herramienta para desarrollar flujos de extracción, no una interfaz de subida de archivos lista para cualquier usuario. Resulta útil cuando el equipo necesita datos reutilizables y una forma de volver al texto que respalda una respuesta.
De los apartados del documento a campos verificables
Un Aspect selecciona los fragmentos originales relacionados con un tema, como las condiciones de pago. Un Concept extrae un valor o una valoración, por ejemplo el número de días para pagar. Puede trabajar sobre el documento completo o sobre un Aspect; también se pueden organizar subtemas.
Los tipos incluyen texto, números, fechas, booleanos, etiquetas, puntuaciones y objetos JSON. Para una tabla de tarifas, puedes describir una estructura con servicio, cuota e información de facturación.
En las extracciones con LLM se pueden solicitar referencias a párrafos o frases y, cuando sea útil, justificaciones. Estas referencias facilitan la revisión, pero no garantizan que la interpretación sea correcta. Los datos importantes deben contrastarse con el original y con las reglas del negocio.
Cómo completar una primera extracción de un PDF
- Instala
pip install -U contextgem. Para convertir archivos, utilizapip install -U "contextgem[docling]". - Crea
Document(raw_text=...)para texto. Para archivos, ejecutaDocumentConverter().convert(file)de Docling y pasaresult.documentaDocument.from_docling(). - Define Aspects y Concepts con descripciones concretas, tipos y referencias cuando hagan falta.
- Configura
DocumentLLMcon un modelo compatible y sus credenciales o un endpoint local. - Ejecuta
doc = llm.extract_all(doc)y consultaget_concept_by_name(...).extracted_itemsen el documento devuelto. - Compara valores y fuentes; prueba campos ausentes, textos ambiguos y varios diseños antes de procesar un lote.
La guía de inicio contiene ejemplos completos. La integración con Docling explica PDF, DOCX, PPTX, XLSX y HTML, con conservación de estructura y referencias de página disponibles. La calidad de la conversión condiciona la extracción.
Reutilizar reglas y conectar los resultados
ExtractionPipeline permite reutilizar temas y conceptos en documentos similares. Los documentos, los flujos y las configuraciones compatibles pueden serializarse; to_dict() y to_json() facilitan la integración. La escritura en una base de datos o la creación de una hoja de cálculo corresponde a tu aplicación.
Los ejemplos para agentes muestran extracción de metadatos al importar, herramientas que un agente puede invocar y preguntas cerradas para decidir el siguiente paso. El idioma de salida puede configurarse para valores de texto y justificaciones, conservando las referencias en su idioma original.
ContextGem analiza documentos individuales en profundidad, incluso por lotes de párrafos. No incorpora por sí mismo búsqueda en una colección ni consultas entre documentos; para eso necesita un sistema de recuperación adicional.
Elegir modelos locales, LLM y modelos de decisión
Mediante LiteLLM se conecta con proveedores compatibles en la nube y con backends locales como Ollama y LM Studio. Un LLM es adecuado para respuestas abiertas, distintos tipos de campos e imágenes compatibles. Conviene comprobar los modelos pequeños con documentos representativos.
Los modelos de decisión responden a preguntas cerradas mediante booleanos, etiquetas o niveles de valoración y pueden seleccionar Aspects de texto. Devuelven probabilidades y admiten umbrales; no generan texto abierto ni ofrecen automáticamente las mismas funciones de imagen o JSON de un LLM. Los grupos de modelos permiten repartir tareas por roles y configurar alternativas.
Costes, licencia y tratamiento de los documentos
Comprobado el 29 de octubre de 2026: el framework es gratuito y utiliza Apache 2.0. El uso comercial está sujeto a la licencia. Los proveedores de modelos pueden cobrar las llamadas; el despliegue local utiliza tus recursos. No existe aquí una tarifa universal de ContextGem ni una cuota gratuita común a todos los modelos.
La política de seguridad oficial indica que ContextGem no recopila telemetría y envía documentos y prompts únicamente a los modelos configurados, mediante LiteLLM ejecutado en tu entorno. Revisa las condiciones de conservación del proveedor si usas la nube. Con un modelo local, comprueba endpoints y alternativas en la nube: la instalación, la descarga de modelos de segmentación y los datos de precios pueden seguir generando tráfico de red.
Preguntas frecuentes
¿Es totalmente gratuito?
El software es gratuito; las API de modelos, el hardware y la operación pueden tener costes separados. La licencia no incluye inferencia ilimitada.
¿Puede trabajar con PDF y Word?
El flujo documentado convierte archivos con Docling y utiliza Document.from_docling(result.document). Revisa la conversión y las fuentes de los valores extraídos.
¿Puedo utilizar un modelo local con documentos privados?
Sí, con backends compatibles como Ollama y LM Studio. Debes validar su calidad y comprobar las conexiones y alternativas configuradas.
¿Sustituye a RAG para buscar en muchos documentos?
Se centra en analizar cada documento. La búsqueda en la colección y la recuperación entre archivos requieren otros componentes.
Recursos oficiales y comunidad
- Requisitos de instalación: Python 3.11–3.14 y excepciones para Intel Mac y Alpine/musl.
- Modelos compatibles: conexiones locales y en la nube.
- GitHub Discussions: dudas sobre implementación.
- Incidencias y propuestas: errores y solicitudes de funciones.
- Migración a la versión 1: cambios para proyectos basados en 0.x.
Herramientas relacionadas
Herramientas de documentos y productividad de IA →
Off Grid AIFreemium
Un asistente de IA local para el móvil, el ordenador y tus documentos
PaddockGratis
Ordenadores Linux y sandboxes para agentes de programación en tu propio VPS.
tabshGratis
Reúne terminales locales, agentes y tareas de varios proyectos
TelegramFreemium
Mensajería en la nube para conversaciones, comunidades e integraciones con bots.
OpenStatusFreemium
Monitorización web y comunicación de incidencias con ayuda de IA