
OvermindFreemium
Maak van agentgegevens een gespecialiseerd model en toets het resultaat.
ContextGem: gegevens uit documenten halen met Python
Haal met Python gestructureerde gegevens uit documenten en controleer de bijbehorende bronpassages.
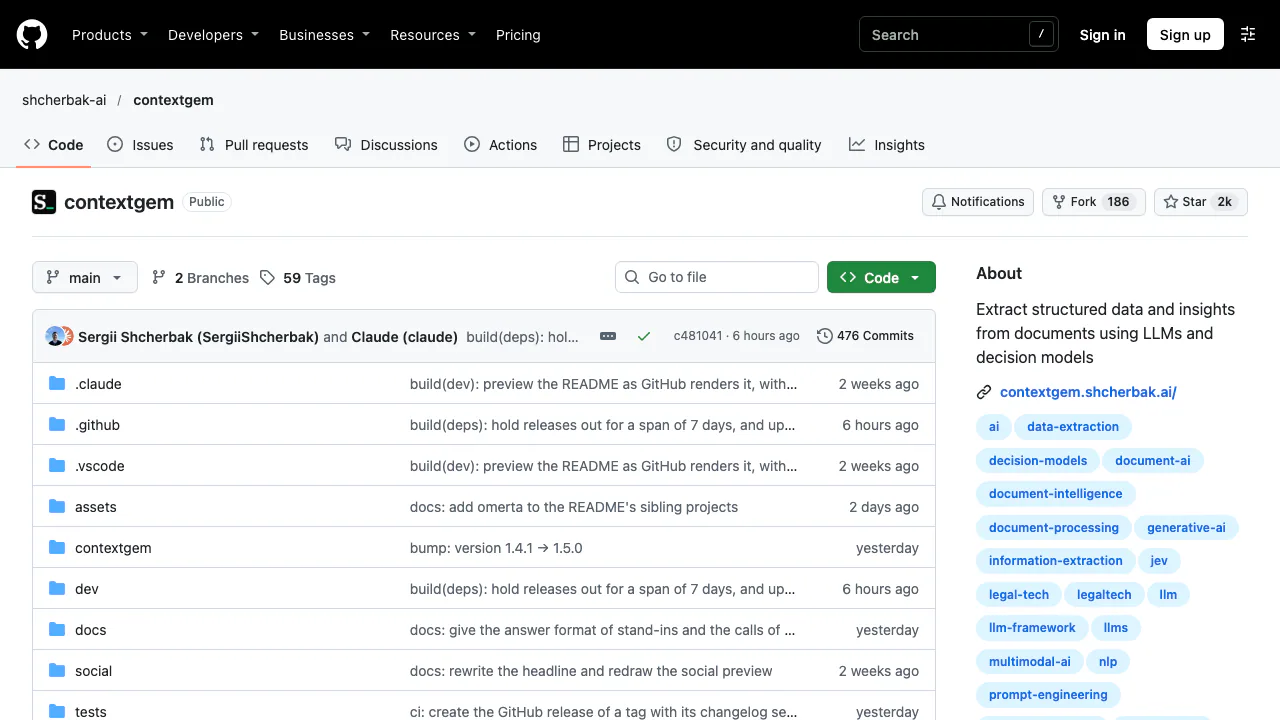
ContextGem is een gratis, opensource Python-framework van Shcherbak AI AS voor het extraheren van gestructureerde gegevens uit documenten. Je beschrijft welke informatie nodig is en kiest een LLM of beslismodel. Het framework verzorgt de prompts, datamodellen en controle van het uitvoerformaat.
Wat doet ContextGem? Een eenvoudige uitleg
Stel dat je uit contracten betalingstermijnen, opzeggingsvoorwaarden en maandbedragen wilt overnemen. Met ContextGem legt een ontwikkelaar de velden en typen vast en verwerkt documenten volgens dezelfde regels. De uitkomst kan een datum, getal, label of JSON-object zijn dat een toepassing verder kan verwerken.
Het is een bouwsteen voor documentverwerking in Python. Een eigen interface, opslag en inhoudelijke controle blijven nodig. Het project biedt code en documentatie; het is geen algemene webdienst waarbij iedereen alleen een bestand hoeft te uploaden.
Van passages naar bruikbare velden
Een Aspect selecteert originele tekst over een onderwerp, zoals betalingsvoorwaarden. Een Concept haalt een waarde of beoordeling op, bijvoorbeeld het aantal betaaltermijndagen. Concepts kunnen het hele document of een Aspect gebruiken; subonderwerpen maken de context specifieker.
Ondersteunde typen zijn tekst, getallen, datums, booleans, labels, scores en JSON-objecten. Bij LLM-extractie kun je verwijzingen naar alinea's of zinnen en zo nodig onderbouwingen laten toevoegen. Daarmee kun je de bron terugvinden. Een geldig formaat en een verwijzing bewijzen nog niet dat de interpretatie klopt: controleer belangrijke bedragen en beslissingen.
Gratis software, modelkosten en privacy
Gecontroleerd op 29 oktober 2026: het framework is gratis onder Apache 2.0, met commercieel gebruik volgens de licentievoorwaarden. Cloud-API's, lokale hardware en beheer kunnen afzonderlijk geld kosten. Er is geen uniforme documentprijs of gratis modelbundel.
Volgens het officiële beveiligingsbeleid verzamelt ContextGem geen telemetrie. Documenten en prompts gaan via LiteLLM in je eigen omgeving naar de ingestelde modellen. Controleer bij clouddiensten hun bewaarbeleid. Bij lokale modellen moet je endpoints en mogelijke cloud-fallbacks nalopen. Installatie, zinssegmentatiemodellen en prijsgegevens kunnen nog openbare downloads vereisen.
Een eerste document verwerken
- Installeer
pip install -U contextgem; voor bestanden gebruik jepip install -U "contextgem[docling]". - Maak
Document(raw_text=...)voor tekst. Converteer een bestand met DoclingsDocumentConverter().convert(file)en geefresult.documentdoor aanDocument.from_docling(). - Definieer Aspects en Concepts met duidelijke omschrijvingen, typen en gewenste bronverwijzingen.
- Stel
DocumentLLMin met een ondersteund model, toegangsgegevens of een lokaal endpoint. - Voer
doc = llm.extract_all(doc)uit en leesget_concept_by_name(...).extracted_itemsuit het geretourneerde document. - Vergelijk de gegevens en bronnen met bekende antwoorden. Test ontbrekende velden en andere indelingen voordat je opschaalt.
De officiële snelstart bevat complete voorbeelden. De Docling-integratie behandelt onder andere PDF, DOCX, PPTX, XLSX en HTML, met documentstructuur en beschikbare paginaverwijzingen. Fouten in de conversie werken door in de extractie.
Lokale LLMs en beslismodellen kiezen
Via LiteLLM werkt ContextGem met gedocumenteerde cloudaanbieders en lokale backends zoals Ollama en LM Studio. LLMs zijn geschikt voor open antwoorden, verschillende veldtypen en ondersteunde afbeeldingen. Test kleine modellen op eigen documenten en complexe instructies.
Beslismodellen beantwoorden gesloten vragen met booleans, labels of beoordelingsniveaus en selecteren tekst-Aspects. Ze geven kansen en instelbare drempels, maar schrijven geen vrije tekst. Hun mogelijkheden voor afbeeldingen en willekeurige JSON-uitvoer zijn niet gelijk aan die van een LLM. Modelgroepen verdelen taken per rol en kunnen terugvalmodellen gebruiken.
Hergebruik en integratie in een groter systeem
Met ExtractionPipeline hergebruik je Aspects en Concepts. Documenten, pipelines en ondersteunde modelinstellingen kunnen worden geserialiseerd. to_dict() en to_json() helpen bij overdracht; databaseopslag of spreadsheetbestanden bouw je in de eigen toepassing.
De agentvoorbeelden tonen metadata-extractie bij invoer, aanroepbare tools en beslispunten. De uitvoertaal kan worden ingesteld voor tekstwaarden en uitleg, terwijl bronverwijzingen hun oorspronkelijke taal behouden.
ContextGem analyseert afzonderlijke documenten grondig, eventueel in groepen alinea's. Zoeken in een verzameling en vragen over meerdere documenten vereisen een extra zoeksysteem. Modelkeuze en verdeling beïnvloeden kwaliteit, tijd en kosten.
Veelgestelde vragen
Is alles kosteloos?
Het framework is gratis. Model-API's, hardware en beheer kunnen apart kosten; onbeperkte gratis inferentie is niet inbegrepen.
Kan ik gegevens uit een PDF of Word-document halen?
De beschreven route gebruikt Docling en vervolgens Document.from_docling(result.document). Controleer de conversie en de bronnen van de gevonden waarden.
Kan een lokaal model privébestanden verwerken?
Ondersteunde backends zijn onder meer Ollama en LM Studio. Controleer modelkwaliteit, netwerkverkeer en cloud-fallbacks.
Vervangt het RAG voor een documentenarchief?
Het analyseert losse documenten. Voor zoeken in het archief en ophalen over meerdere bestanden zijn andere componenten nodig.
Officiële bronnen en community
- Installatievereisten: Python 3.11–3.14 en uitzonderingen voor Intel Mac en Alpine/musl.
- Ondersteunde modellen: lokale en cloudopties.
- GitHub Discussions: implementatievragen.
- Problemen en verzoeken: fouten en functies.
- Migratie naar versie 1: wijzigingen voor oudere integraties.
Vergelijkbare tools
AI-productiviteit en documenttools →
Off Grid AIFreemium
Een lokale assistent voor vragen, bestanden en optioneel werkgeheugen
PaddockGratis
Linux-werkplekken voor coding-agents, met beheer op je eigen server.
tabshGratis
Lokale terminals en taken uit meerdere projecten overzichtelijk bij elkaar
TelegramFreemium
Een cloudmessenger voor gesprekken, communities en diensten via bots.
OpenStatusFreemium
Website monitoring en incidentcommunicatie met AI-ondersteuning