
OvermindFreemium
Przygotuj dane agentów, dostrój model i sprawdź wynik.
ContextGem: ekstrakcja danych z dokumentów w Pythonie
Wyodrębniaj uporządkowane dane z dokumentów w Pythonie i sprawdzaj wskazane fragmenty źródłowe.
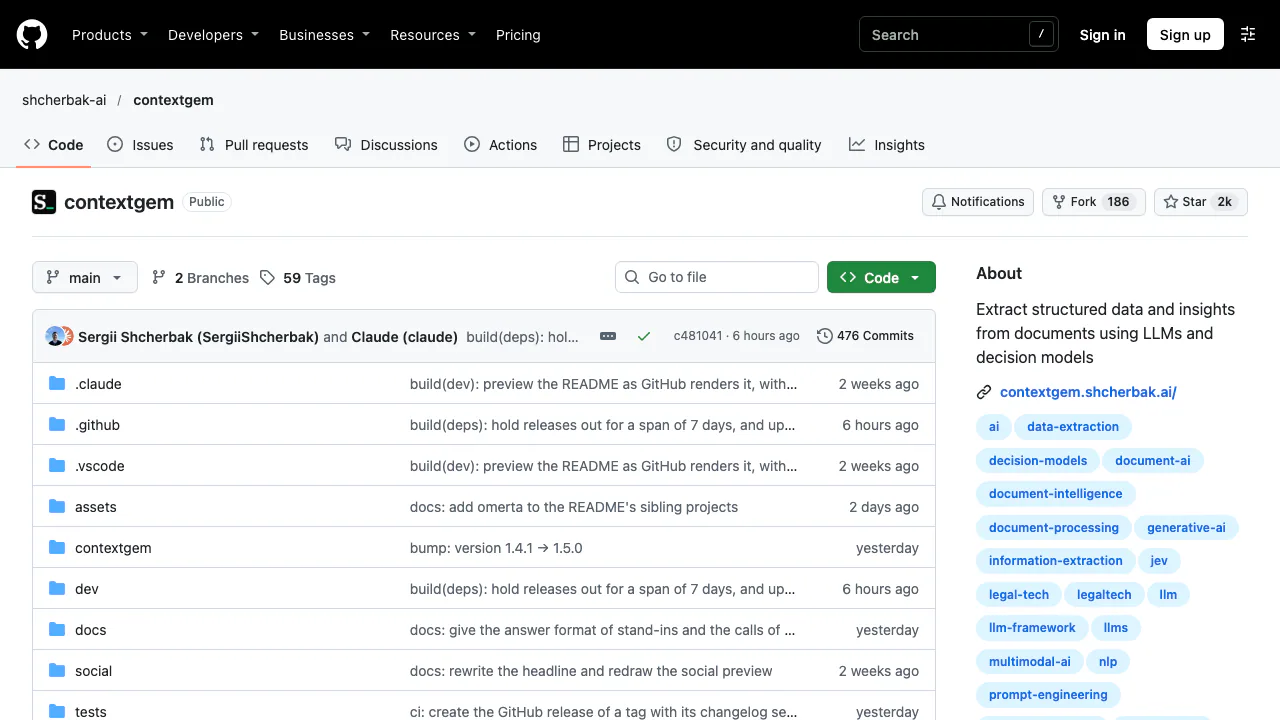
ContextGem to bezpłatny framework Python o otwartym kodzie, rozwijany przez Shcherbak AI AS. Służy do wyodrębniania uporządkowanych informacji z dokumentów za pomocą LLM i modeli decyzyjnych. Opisujesz potrzebne dane, a framework przygotowuje prompty, modele danych i sprawdza format odpowiedzi.
Do czego służy ContextGem? Proste wyjaśnienie
Wyobraź sobie analizę umów, z których trzeba przepisać terminy płatności, warunki wypowiedzenia i miesięczne opłaty. Programista definiuje odpowiednie pola i typy, a ContextGem stosuje te same reguły do kolejnych dokumentów. Wynikiem mogą być daty, liczby, etykiety lub obiekty JSON.
To narzędzie do budowania aplikacji, a nie gotowy serwis do przesyłania plików i rozmowy z dokumentem. Wymaga kodu Python, konfiguracji modelu oraz kontroli wyników. Przydaje się zespołom, które chcą uzyskiwać dane nadające się do dalszego przetwarzania.
Jak uruchomić pierwszy proces ekstrakcji
- Zainstaluj
pip install -U contextgem. Do konwersji plików użyjpip install -U "contextgem[docling]". - Dla tekstu utwórz
Document(raw_text=...). Plik przekształć przezDocumentConverter().convert(file)w Docling, a następnieDocument.from_docling(result.document). - Zdefiniuj Aspects i Concepts: opisy, typy oraz wymagane odwołania do źródeł.
- Skonfiguruj
DocumentLLM, podając obsługiwany model i dane dostępu albo lokalny endpoint. - Wykonaj
doc = llm.extract_all(doc). Odczytajget_concept_by_name(...).extracted_itemsze zwróconego dokumentu. - Porównaj wartości i źródła ze znanymi odpowiedziami. Sprawdź brakujące pola i różne układy przed przetwarzaniem większej partii.
Oficjalny przewodnik startowy zawiera pełne przykłady. Integracja Docling obejmuje m.in. PDF, DOCX, PPTX, XLSX i HTML, zachowując strukturę i dostępne odwołania do stron. Błędy konwersji mogą wpłynąć na wyodrębnione dane.
Fragmenty tematyczne, pola i możliwość weryfikacji
Aspect wskazuje oryginalne fragmenty dotyczące tematu, np. warunków płatności. Concept wyodrębnia wartość lub ocenę, np. liczbę dni na zapłatę. Może analizować cały dokument albo wybrany Aspect; możliwe są też podtematy.
Obsługiwane typy obejmują tekst, liczby, daty, wartości logiczne, etykiety, oceny i obiekty JSON. Ekstrakcja z LLM pozwala żądać odwołań do akapitów lub zdań oraz uzasadnień. Ułatwiają one kontrolę, ale poprawny format i źródło nie gwarantują poprawnej interpretacji. Ważne liczby i decyzje trzeba sprawdzić w oryginale.
Wybór LLM i modelu decyzyjnego
Dzięki LiteLLM można korzystać z udokumentowanych dostawców chmurowych i lokalnych backendów, takich jak Ollama czy LM Studio. LLM służy do otwartych odpowiedzi, różnych typów wartości i obsługiwanych obrazów. Mniejsze modele warto ocenić na własnych dokumentach.
Modele decyzyjne odpowiadają na pytania zamknięte: prawda/fałsz, etykieta lub poziom oceny; mogą też wybierać tekstowe Aspects. Zwracają prawdopodobieństwa i pozwalają ustawiać progi. Nie generują swobodnego tekstu ani nie zastępują wszystkich funkcji LLM dotyczących obrazów czy dowolnego JSON. Grupy modeli rozdzielają zadania według ról i obsługują modele zapasowe.
Powtarzalne reguły i integracja z agentami
ExtractionPipeline pozwala ponownie używać definicji tematów i pól. Dokumenty, pipeline'y i obsługiwane konfiguracje można serializować. to_dict() i to_json() ułatwiają przekazywanie danych, ale zapis do bazy lub utworzenie arkusza wymaga kodu aplikacji.
Przykłady agentowe pokazują ekstrakcję metadanych przy importowaniu, narzędzie wywoływane przez agenta i pytania w punktach decyzyjnych. Ustawienie języka wyjściowego dotyczy odpowiedzi tekstowych i uzasadnień; źródła zachowują oryginalny język.
ContextGem dokładnie analizuje pojedyncze dokumenty, opcjonalnie w partiach akapitów. Sam nie przeszukuje kolekcji ani nie realizuje zapytań obejmujących wiele dokumentów. W takich zastosowaniach trzeba dodać system wyszukiwania.
Koszty, licencja i prywatność dokumentów
Stan na 29 października 2026 r.: framework jest bezpłatny na licencji Apache 2.0; użycie komercyjne podlega jej warunkom. API modeli i lokalna infrastruktura mogą kosztować osobno. Nie ma jednej ceny za dokument ani wspólnego darmowego limitu dla wszystkich modeli.
Oficjalna polityka bezpieczeństwa podaje, że ContextGem nie zbiera telemetrii. Dokumenty i prompty trafiają przez LiteLLM działający w Twoim środowisku do skonfigurowanych modeli. Sprawdź zasady przechowywania u dostawcy chmurowego oraz lokalne endpointy i modele zapasowe. Instalacja, modele dzielące tekst na zdania i dane cenowe mogą nadal wymagać publicznych pobrań.
Częste pytania
Czy korzystanie nic nie kosztuje?
Framework jest darmowy. API, sprzęt i utrzymanie mogą być płatne niezależnie; licencja nie zapewnia nieograniczonej inferencji.
Czy można przetwarzać PDF i Word?
Udokumentowany proces korzysta z Docling i Document.from_docling(result.document). Sprawdź konwersję oraz źródła wyodrębnionych danych.
Czy prywatne pliki mogą pozostać przy lokalnym modelu?
Obsługiwane są m.in. Ollama i LM Studio. Wymagają świadomej konfiguracji połączeń, modeli zapasowych i kontroli jakości.
Czy zastępuje RAG dla całego archiwum?
Analizuje pojedynczy dokument. Wyszukiwanie w archiwum i pobieranie danych z wielu plików wymaga dodatkowych komponentów.
Oficjalne materiały i społeczność
- Wymagania instalacji: Python 3.11–3.14, wyjątki Intel Mac i ograniczenia Alpine/musl.
- Obsługiwane modele: lokalne i chmurowe backendy.
- GitHub Discussions: pytania o wdrożenie.
- Zgłoszenia: błędy i propozycje funkcji.
- Migracja do wersji 1: zmiany dla wcześniejszych integracji.
Podobne narzędzia
Narzędzia zwiększające produktywność i dokumenty AI →
Off Grid AIFreemium
Lokalny asystent do rozmów, dokumentów i opcjonalnej pamięci pracy
PaddockZa darmo
Komputery Linux i kontrolowane środowiska dla agentów programistycznych.
tabshZa darmo
Lokalne powłoki i status zadań z wielu projektów w jednym widoku
TelegramFreemium
Komunikator w chmurze do rozmów, społeczności i integracji z botami.
OpenStatusFreemium
Monitoring stron i komunikacja o awariach ze wsparciem AI