
OvermindFreemium
Dai dati dei tuoi agenti a un modello specializzato e verificabile.
ContextGem: estrazione di dati dai documenti con Python
Estrai dati strutturati dai documenti con Python e modelli IA, mantenendo riferimenti verificabili.
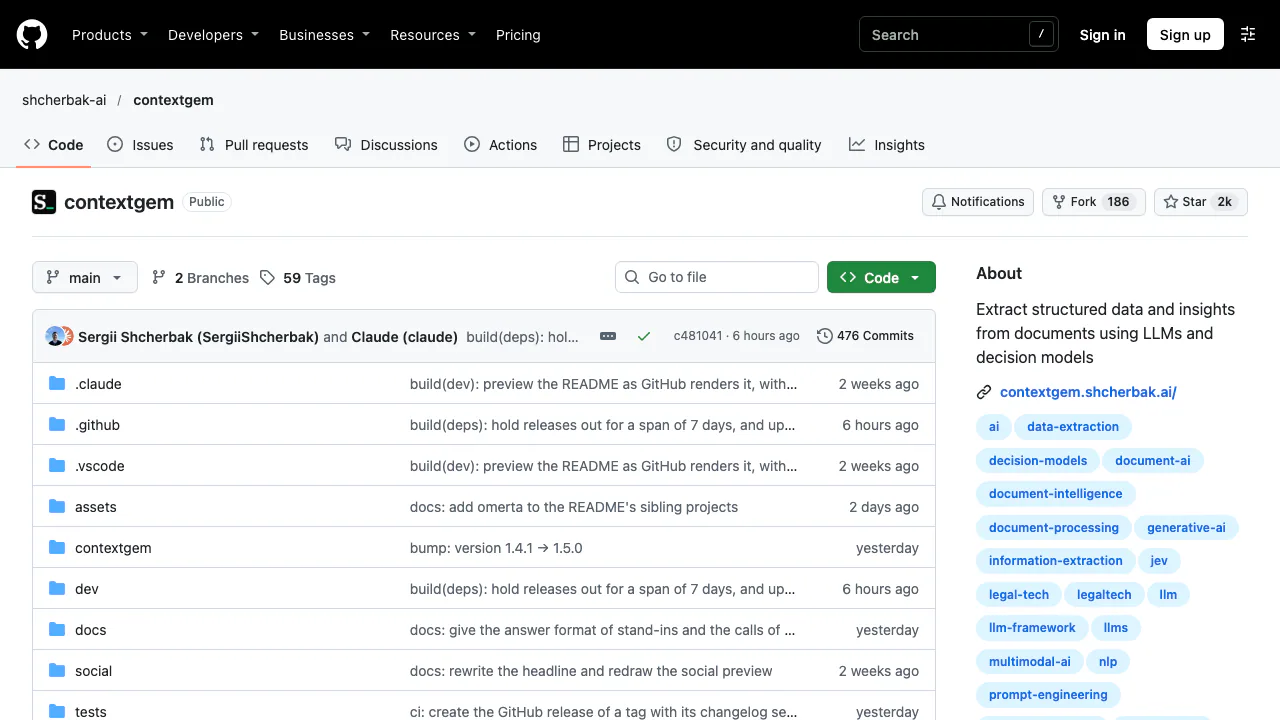
ContextGem è un framework Python gratuito e open source di Shcherbak AI AS per estrarre dati strutturati dai documenti. Si descrivono le informazioni desiderate e si configura un LLM o un modello decisionale; il framework gestisce prompt, modelli dei dati e verifica del formato di risposta.
A cosa serve ContextGem, spiegato in modo semplice
Se devi leggere contratti e riportare termini di pagamento, condizioni di recesso e canoni mensili in un sistema, ContextGem permette di definire una volta i campi e riutilizzare le istruzioni. Le risposte diventano numeri, date, etichette o oggetti JSON che un'applicazione può elaborare.
È uno strumento per sviluppatori e gruppi che costruiscono flussi documentali. Richiede codice Python, configurazione del modello e controllo dei risultati; il sito non va confuso con un servizio generico in cui basta caricare un file per iniziare una chat.
Come realizzare una prima estrazione
- Installa
pip install -U contextgem; per la conversione dei file usapip install -U "contextgem[docling]". - Inserisci il testo in
Document(raw_text=...). Per un file, eseguiDocumentConverter().convert(file)di Docling e passaresult.documentaDocument.from_docling(). - Definisci Aspects e Concepts con descrizioni precise, tipi corretti e riferimenti quando necessari.
- Configura
DocumentLLMcon un modello supportato, credenziali o endpoint locale. - Esegui
doc = llm.extract_all(doc)e leggiget_concept_by_name(...).extracted_itemssul documento restituito. - Confronta valori e fonti con un esempio di cui conosci le risposte, poi prova campi mancanti e impaginazioni diverse.
La guida introduttiva include esempi completi. L'integrazione Docling illustra PDF, DOCX, PPTX, XLSX e HTML, preservando struttura e riferimenti di pagina disponibili. La qualità della conversione influisce sull'estrazione.
Passaggi tematici, valori e riferimenti alla fonte
Un Aspect seleziona il testo originale relativo a un tema, per esempio le condizioni di pagamento. Un Concept estrae un valore o una valutazione, come una scadenza o un oggetto con il dettaglio delle tariffe. Può lavorare su tutto il documento o su un Aspect, anche con sottotemi.
Sono disponibili testo, numeri, date, booleani, etichette, punteggi e oggetti JSON. Nelle estrazioni con LLM si possono richiedere riferimenti a paragrafi o frasi e motivazioni. Questi aiutano la revisione, ma non garantiscono la correttezza dell'interpretazione. Importi, date e decisioni importanti richiedono un confronto con l'originale e regole applicative.
Riutilizzare il lavoro e integrarlo con gli agenti
ExtractionPipeline conserva le definizioni da riutilizzare su documenti simili. Documenti, pipeline e configurazioni supportate sono serializzabili. Con to_dict() e to_json() i risultati possono passare ad altri componenti; il salvataggio in un database o la creazione di un foglio di calcolo restano compiti dell'applicazione.
I flussi per agenti mostrano l'estrazione di metadati all'ingresso, strumenti invocabili e domande chiuse nei punti decisionali. La lingua di uscita può essere impostata per valori testuali e motivazioni, mantenendo le fonti nella lingua originale.
ContextGem legge approfonditamente singoli documenti, anche per gruppi di paragrafi. Non ricerca da solo in un archivio né risponde a interrogazioni tra documenti: per questi casi serve un sistema di recupero aggiuntivo.
Costi, uso commerciale e riservatezza
Verifica del 29 ottobre 2026: il framework è gratuito con licenza Apache 2.0. L'uso commerciale segue le condizioni della licenza. API cloud, hardware e gestione locale possono comportare costi distinti; non esiste qui una tariffa unica per documento o un limite gratuito comune a tutti i modelli.
La politica di sicurezza dichiara che ContextGem non raccoglie telemetria. Documenti e prompt vengono inviati ai modelli configurati tramite LiteLLM eseguito nell'ambiente dell'utente. Controlla le condizioni del fornitore cloud, gli endpoint e gli eventuali modelli di ripiego. Installazione, modelli di segmentazione e dati sui prezzi possono richiedere download pubblici anche usando inferenza locale.
Quale modello usare per ciascun campo?
LiteLLM permette di collegare provider cloud supportati e backend locali come Ollama e LM Studio. Un LLM gestisce risposte aperte, diversi tipi di valori e immagini compatibili. I modelli piccoli vanno verificati sui documenti reali prima di affidarvi istruzioni complesse.
I modelli decisionali trattano domande chiuse con booleani, etichette o livelli di valutazione e selezionano Aspects testuali. Forniscono probabilità e soglie configurabili senza generare testo libero; non equivalgono a un LLM per immagini o JSON arbitrari. I gruppi di modelli possono distribuire compiti per ruolo e usare alternative in caso di necessità.
Domande frequenti
È tutto gratuito?
Il framework lo è. Le chiamate ai modelli, l'hardware e l'esercizio possono avere costi separati; non è inclusa inferenza illimitata.
Può estrarre dati da PDF e Word?
Il percorso documentato usa Docling e poi Document.from_docling(result.document). Controlla conversione e riferimenti dei risultati.
Si possono usare modelli locali per documenti privati?
Sono supportati backend come Ollama e LM Studio. Occorre verificarne qualità, connessioni e possibili alternative cloud.
Sostituisce RAG su una raccolta di documenti?
Analizza ogni documento in profondità. La ricerca nell'archivio e il recupero tra documenti richiedono componenti aggiuntivi.
Risorse ufficiali e comunità
- Requisiti di installazione: Python 3.11–3.14 ed eccezioni Intel Mac e Alpine/musl.
- Modelli supportati: collegamenti locali e cloud.
- GitHub Discussions: domande sull'implementazione.
- Segnalazioni e richieste: problemi riproducibili e funzionalità.
- Migrazione alla versione 1: modifiche per progetti precedenti.
Strumenti correlati
Strumenti AI per documenti →
Off Grid AIFreemium
Chat, documenti e memoria di lavoro opzionale sui tuoi dispositivi
PaddockGratis
Computer Linux e sandbox per agenti di coding sul server che controlli.
tabshGratis
Sessioni locali e avanzamento dei progetti in un unico spazio
TelegramFreemium
Messaggi e comunità su più dispositivi, con funzioni IA e integrazioni tramite bot.
OpenStatusFreemium
Monitoraggio e aggiornamenti sugli incidenti con assistenza IA