
OvermindFreemium
Transforme dados dos seus agentes em modelos especializados e avaliados.
ContextGem: extração de dados de documentos com Python
Extraia dados estruturados de documentos com Python e confira as informações nas fontes originais.
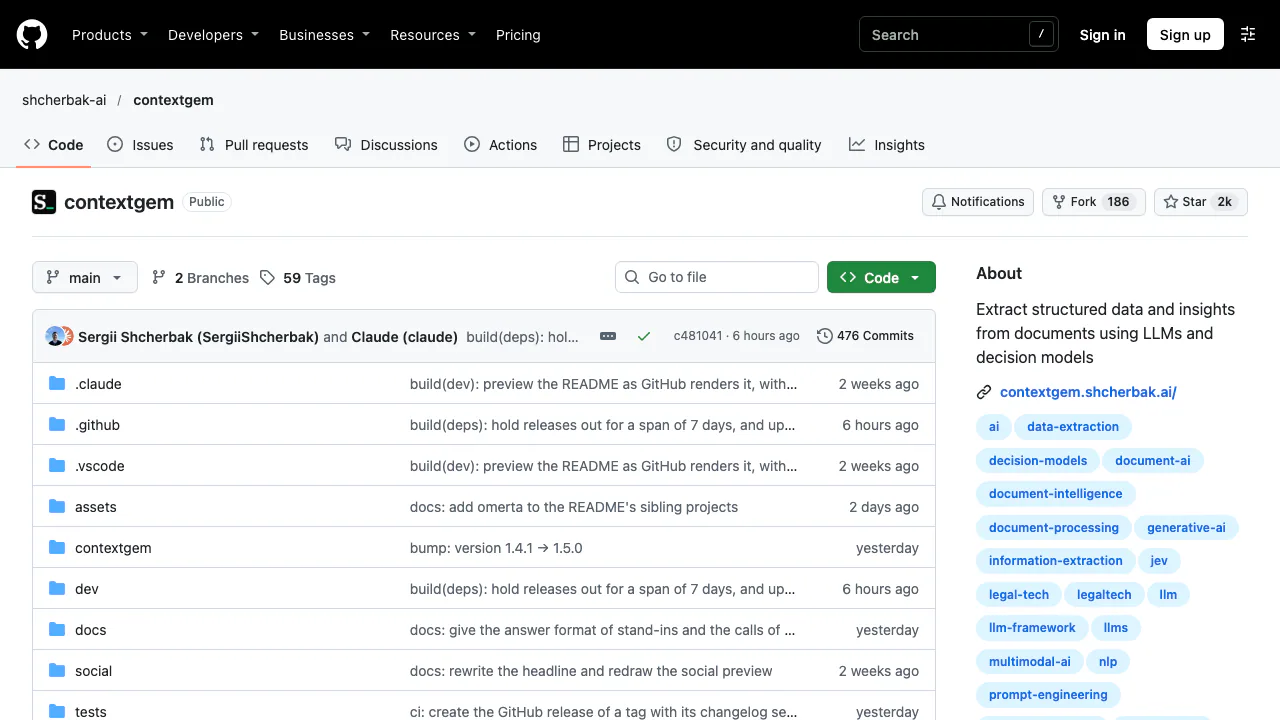
ContextGem é um framework Python gratuito e de código aberto da Shcherbak AI AS para extrair dados estruturados de documentos. Você descreve as informações necessárias e configura um LLM ou modelo de decisão; o framework prepara prompts, modelos de dados e valida o formato das respostas.
Para que serve o ContextGem? Uma explicação simples
Pense em contratos dos quais sua equipe precisa registrar prazos de pagamento, condições de rescisão e mensalidades. Um desenvolvedor define os campos e seus tipos, e o ContextGem aplica as mesmas regras a cada documento. As saídas podem ser números, datas, etiquetas ou objetos JSON utilizáveis por outro sistema.
É uma ferramenta para criar aplicações em Python. Ela exige configuração de modelo e revisão dos resultados; o site apresenta código e documentação, em vez de uma plataforma genérica pronta para enviar arquivos e conversar.
Extrair trechos, campos e evidências
Um Aspect seleciona trechos originais sobre um assunto, como condições de pagamento. Um Concept extrai um valor ou avaliação, por exemplo o prazo em dias ou um objeto com valores de serviços. É possível aplicá-lo ao documento completo ou a um Aspect e organizar subtemas.
Os tipos incluem texto, números, datas, booleanos, etiquetas, avaliações e objetos JSON. Na extração com LLM, referências a parágrafos ou frases e justificativas podem ser solicitadas. Isso ajuda a voltar à fonte, mas não garante uma interpretação correta. Valores relevantes e decisões devem ser comparados com o original e com as regras do negócio.
Como executar a primeira extração de um PDF
- Instale
pip install -U contextgem. Para conversão de arquivos, usepip install -U "contextgem[docling]". - Crie
Document(raw_text=...)para texto. Para arquivos, utilizeDocumentConverter().convert(file)do Docling e depoisDocument.from_docling(result.document). - Defina Aspects e Concepts com descrições claras, tipos e referências necessárias.
- Configure
DocumentLLMcom um modelo compatível, suas credenciais ou um endpoint local. - Execute
doc = llm.extract_all(doc)e consulteget_concept_by_name(...).extracted_itemsno documento retornado. - Compare valores e fontes em uma amostra com respostas conhecidas. Teste campos ausentes, ambiguidades e layouts diferentes antes de aumentar o volume.
O guia oficial de início traz exemplos completos. A integração com Docling explica PDF, DOCX, PPTX, XLSX e HTML, preservando a estrutura e referências de página disponíveis. A qualidade da conversão influencia a extração.
Software gratuito, custos de uso e privacidade
Verificado em 29 de outubro de 2026: o framework é gratuito sob a licença Apache 2.0, com uso comercial sujeito às suas condições. Chamadas de modelos na nuvem e recursos locais podem ter custos separados. Não há aqui preço único por documento nem franquia gratuita válida para todos os modelos.
A política oficial de segurança informa que ContextGem não coleta telemetria. Documentos e prompts são enviados aos modelos configurados por meio do LiteLLM executado no seu ambiente. Confira a retenção de dados do fornecedor na nuvem. Em instalações locais, revise endpoints e alternativas de fallback na nuvem. Dependências, modelos de segmentação de frases e dados de preços ainda podem exigir downloads públicos.
Reaproveitar pipelines e integrar agentes
ExtractionPipeline permite reutilizar Aspects e Concepts em documentos semelhantes. Documentos, pipelines e configurações compatíveis podem ser serializados. to_dict() e to_json() facilitam a integração; gravar em bancos ou gerar planilhas continua sendo responsabilidade da aplicação.
Os exemplos de fluxos com agentes mostram metadados na entrada, ferramentas de extração e perguntas fechadas em pontos de decisão. A configuração de idioma pode controlar respostas textuais e justificativas, enquanto as referências mantêm a língua original.
ContextGem analisa documentos individuais em profundidade, opcionalmente por lotes de parágrafos. Ele não faz sozinho busca em um acervo nem consultas entre documentos. Para esses casos, combine-o com um sistema de recuperação; o modelo e a divisão do texto afetam qualidade, tempo e custo.
Escolher LLMs locais e modelos de decisão
Via LiteLLM, é possível usar provedores de nuvem documentados e backends locais, como Ollama e LM Studio. LLMs atendem respostas abertas, diferentes tipos de campos e imagens compatíveis. Modelos menores precisam ser testados com suas instruções e documentos reais.
Modelos de decisão respondem a questões fechadas com booleanos, etiquetas ou níveis de avaliação e selecionam Aspects textuais. Retornam probabilidades e aceitam limiares configuráveis, sem gerar texto livre. Não equivalem às funções de imagem e JSON arbitrário de um LLM. Grupos de modelos distribuem tarefas por função e permitem alternativas.
Perguntas frequentes
É totalmente gratuito?
O framework é gratuito. API, hardware e operação podem gerar despesas próprias; não há inferência ilimitada incluída na licença.
Consigo extrair dados de PDF e Word?
O fluxo documentado usa Docling e Document.from_docling(result.document). Confira o conteúdo convertido e os campos encontrados.
Posso usar modelos locais com documentos privados?
Backends compatíveis incluem Ollama e LM Studio. Verifique a qualidade, as conexões e os possíveis fallbacks na nuvem.
Substitui RAG em uma coleção de arquivos?
Seu foco é a análise de cada documento. A busca no acervo e a recuperação entre arquivos exigem outras peças do sistema.
Recursos oficiais e comunidade
- Requisitos de instalação: Python 3.11–3.14 e exceções Intel Mac e Alpine/musl.
- Modelos compatíveis: opções locais e na nuvem.
- GitHub Discussions: dúvidas de implementação.
- Problemas e sugestões: erros e pedidos de recursos.
- Migração para a versão 1: alterações para projetos mais antigos.
Ferramentas parecidas
Produtividade de IA e ferramentas de documentos →
Off Grid AIFreemium
IA local para conversar, consultar arquivos e recuperar contexto de trabalho
PaddockGrátis
Computadores Linux e sandboxes para agentes de código no seu próprio servidor.
tabshGrátis
Terminais locais e tarefas de vários projetos em uma visão compartilhada
TelegramFreemium
Mensagens na nuvem para conversar, acompanhar comunidades e conectar serviços.
OpenStatusFreemium
Monitoramento e comunicação de incidentes com apoio de IA