
OvermindЕсть бесплатный тариф
Превращайте данные агентов в специализированные модели с проверяемым результатом.
ContextGem: извлечение данных из документов на Python
Извлекайте структурированные данные из документов на Python и проверяйте их по исходным фрагментам.
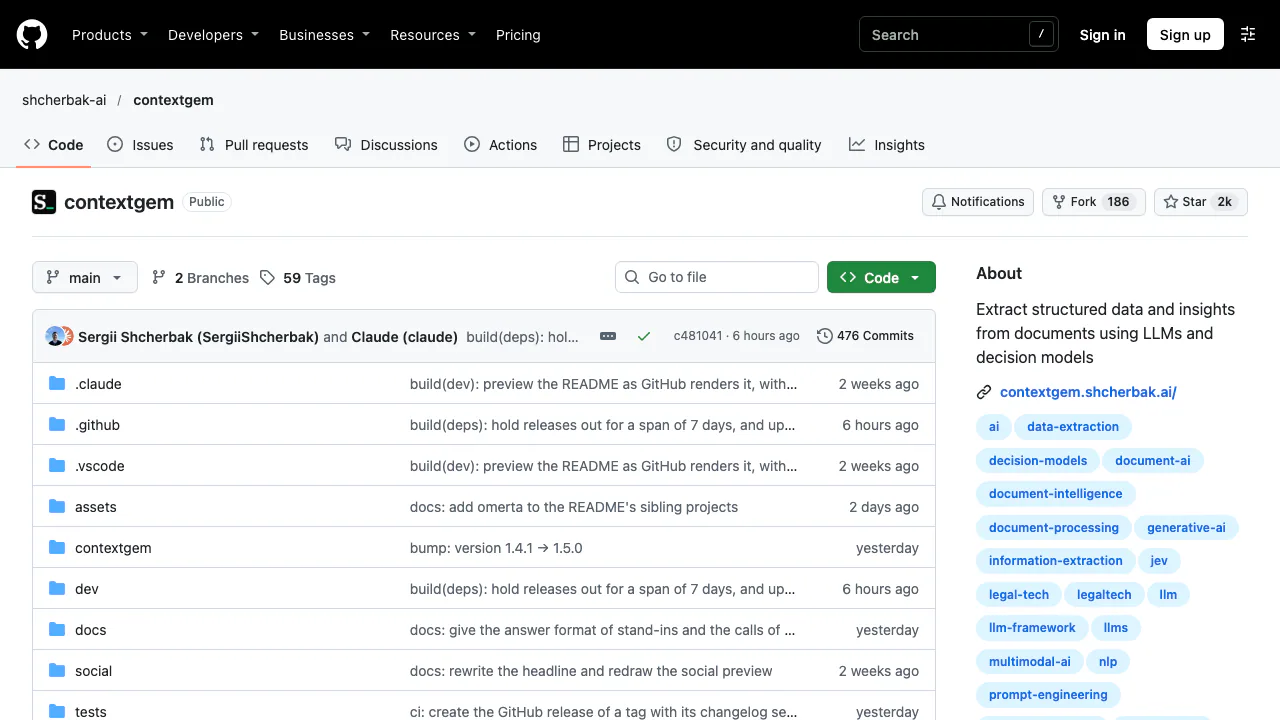
ContextGem — бесплатный фреймворк Python с открытым исходным кодом от Shcherbak AI AS. Он извлекает структурированную информацию из документов с помощью LLM и моделей принятия решений. Вы описываете нужные данные, а фреймворк формирует промпты, организует модели данных и проверяет формат результата.
Что делает ContextGem простыми словами?
Представьте, что из договоров нужно перенести сроки оплаты, условия расторжения и ежемесячные платежи в рабочую систему. Разработчик определяет поля и типы, после чего ContextGem применяет одинаковые требования к документам. Результат — не только пересказ, но и даты, числа, метки или JSON-объекты для дальнейшей обработки.
Это инструмент для разработки на Python. Потребуются настройка модели, код и проверка ответов. Сайт проекта предоставляет документацию и исходники, а не универсальную облачную форму загрузки файлов с готовым чатом.
Тематические фрагменты и типизированные значения
Aspect выбирает исходные фрагменты по теме, например условия оплаты. Concept извлекает значение или оценку: количество дней, дату либо объект с тарифами. Анализ можно выполнять по всему документу или внутри Aspect, в том числе с подтемами.
Поддерживаются строки, числа, даты, логические значения, метки, оценки и JSON-объекты. При работе с LLM можно запросить ссылки на абзацы или предложения и пояснения. Они помогают вернуться к источнику, но не гарантируют правильную интерпретацию. Значимые суммы, даты и решения нужно сверять с оригиналом и бизнес-правилами.
Как выбрать LLM или модель принятия решений
Через LiteLLM доступны документированные облачные провайдеры и локальные среды, включая Ollama и LM Studio. LLM подходят для открытых ответов, разных типов данных и поддерживаемых изображений. Небольшие модели стоит проверять на своих документах и сложных инструкциях.
Модели принятия решений отвечают на закрытые вопросы: да/нет, метка или уровень оценки, а также выбирают текстовые Aspects. Они возвращают вероятности и позволяют задавать пороги, но не генерируют свободный текст. Их возможности для изображений и произвольного JSON не равнозначны LLM. Группы моделей распределяют задачи по ролям и допускают резервные модели.
Первый рабочий процесс извлечения из PDF
- Установите
pip install -U contextgem. Для преобразования файлов используйтеpip install -U "contextgem[docling]". - Для текста создайте
Document(raw_text=...). Файл преобразуйте вызовом DoclingDocumentConverter().convert(file), затем передайтеresult.documentвDocument.from_docling(). - Опишите Aspects и Concepts, выберите типы и нужные ссылки на источники.
- Настройте
DocumentLLM: поддерживаемую модель, ключи доступа или локальную конечную точку. - Выполните
doc = llm.extract_all(doc)и прочитайтеget_concept_by_name(...).extracted_itemsу возвращённого документа. - Сравните значения и источники с известными ответами. Проверьте отсутствующие поля и разные макеты до массовой обработки.
В официальном руководстве есть полные примеры. Интеграция с Docling описывает PDF, DOCX, PPTX, XLSX и HTML с сохранением структуры и доступных ссылок на страницы. Ошибки преобразования могут повлиять на извлечение.
Стоимость, лицензия и передача документов
Проверено 29 октября 2026 года: фреймворк бесплатен по лицензии Apache 2.0; коммерческое использование подчиняется её условиям. API облачных моделей, оборудование и эксплуатация оплачиваются отдельно при необходимости. Единого тарифа за документ или общей бесплатной квоты для всех моделей здесь нет.
В политике безопасности указано, что ContextGem не собирает телеметрию. Документы и промпты передаются настроенным моделям через LiteLLM, работающий в вашей среде. Для облака проверьте правила хранения у провайдера. Для локальной конфигурации — адреса и облачные резервные маршруты. Установка зависимостей, моделей сегментации и получение ценовых данных могут требовать публичных загрузок.
Повторное использование и граница поиска по коллекции
ExtractionPipeline сохраняет темы и поля для повторного применения. Документы, процессы и поддерживаемые настройки моделей сериализуются. Методы to_dict() и to_json() упрощают передачу результата; запись в базу или создание таблицы реализует ваше приложение.
Примеры для агентов показывают извлечение метаданных при загрузке, вызываемые инструменты и закрытые вопросы в точках принятия решений. Язык вывода можно задавать для строк и пояснений; источники остаются на исходном языке.
ContextGem глубоко анализирует отдельные документы, при необходимости группами абзацев. Он сам не ищет по всему архиву и не выполняет междокументные запросы. Для этого нужен дополнительный механизм поиска. Выбор модели и разбиение текста влияют на качество, время и расходы.
Частые вопросы
Использование полностью бесплатное?
Фреймворк бесплатен. API моделей, оборудование и эксплуатация могут стоить отдельно; лицензия не включает безлимитный вывод.
Можно обрабатывать PDF и Word?
Документированный путь использует Docling и Document.from_docling(result.document). Проверяйте преобразованный текст и источники найденных данных.
Можно использовать локальную модель для закрытых документов?
Поддерживаются, например, Ollama и LM Studio. Нужно проверить качество модели, сетевые обращения и облачные резервные настройки.
Заменяет ли ContextGem RAG для архива?
Он отвечает за анализ одного документа. Поиск по коллекции и извлечение из нескольких файлов требуют других компонентов.
Официальные материалы и сообщество
- Требования к установке: Python 3.11–3.14, исключения Intel Mac и ограничения Alpine/musl.
- Поддерживаемые модели: облачные и локальные варианты.
- GitHub Discussions: вопросы по внедрению.
- Ошибки и предложения: воспроизводимые проблемы и функции.
- Переход на версию 1: изменения для интеграций на 0.x.
Похожие нейросети
ИИ для документов и продуктивности →
Off Grid AIЕсть бесплатный тариф
Локальный ИИ для общения, документов и дополнительной памяти о работе
PaddockБесплатно
Linux-компьютеры и управляемые песочницы для агентов программирования.
tabshБесплатно
Локальные сессии и задачи нескольких проектов в одном представлении
TelegramЕсть бесплатный тариф
Облачная переписка, сообщества и подключение сервисов через ботов.
OpenStatusЕсть бесплатный тариф
Мониторинг и сообщения об инцидентах с поддержкой ИИ