
Retriever AI (rtrvr.ai)مجانية جزئيًا
صف مهمة الويب وراجع البيانات والإجراءات الناتجة قبل الاعتماد عليها.
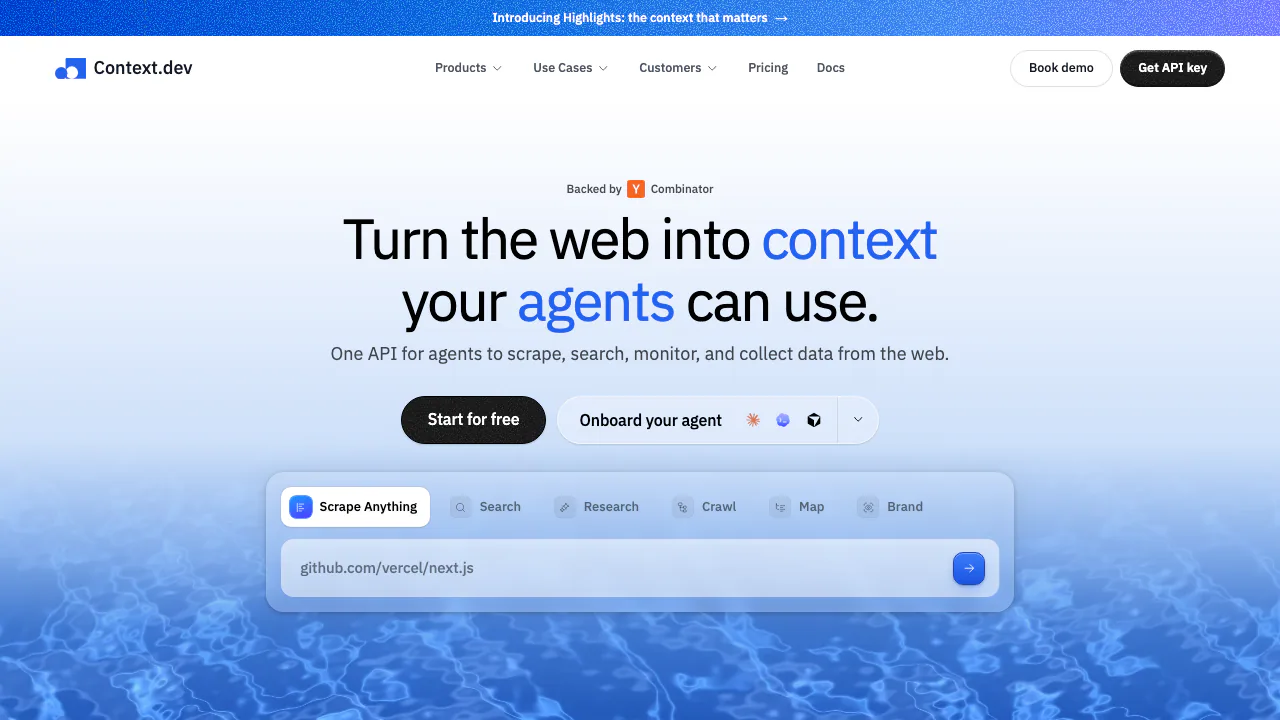
Context.dev: API استخراج بيانات الويب لوكلاء الذكاء الاصطناعي
حوّل صفحات الويب إلى نص وبيانات منظمة، وابحث عن المصادر وراقب التغييرات عبر واجهة واحدة.
شرح مبسط: ما وظيفة Context.dev؟
Context.dev هو API لاستخراج بيانات الويب. يرسل تطبيقك عنوان صفحة، فتعود إليه معلومات يمكن معالجتها، مثل Markdown أو HTML بعد التصيير أو لقطة شاشة أو حقول منظمة. تتولى الخدمة تشغيل المتصفحات والبنية الخاصة بالوكلاء الشبكيين. وMarkdown صيغة نصية تحافظ على العناوين والقوائم، ويمكن استخدامها لتزويد نموذج ذكاء اصطناعي بمحتوى الصفحة.
تشغّل الخدمة شركة Context Dev Inc.، وهي موجهة لمطوري الوكلاء وأدوات البحث وتطبيقات RAG. في RAG يسترجع التطبيق مصادر مناسبة قبل إنشاء الإجابة. يوفّر Context.dev المحتوى، بينما يبقى التخزين والفهرسة وعرض النتائج من مسؤولية تطبيقك.
اختيار المسار المناسب لجمع المعلومات
استخدم Scrape عندما تعرف رابط الصفحة. يمكنك طلب أكثر من صيغة في الاستدعاء، ومنها استخراج JSON وفق JSON Schema للحقول المطلوبة. يتضمن السعر الأساسي تصيير JavaScript والوكلاء الشبكيين؛ وقد ترفع إجراءات المتصفح والمخرجات الإضافية استهلاك الرصيد.
استخدم Map لاكتشاف روابط الموقع، ثم حدّد المسارات المفيدة قبل Crawl. يتبع Crawl الروابط ويعيد حتى 500 صفحة بصيغة Markdown في الاستدعاء، مع حدود لعدد الصفحات والعمق والمسارات. أما Batches فيعالج القوائم والمواقع الأكبر في الخلفية، وتسترد النتائج عبر الاستعلام عن الحالة أو webhook.
ابدأ بعينة صغيرة وافحص النص واحتفظ بروابط المصادر قبل إضافتها إلى فهرسك. يمكن أن يستخدم Scrape نتائج مخزنة مؤقتًا بعمر يصل إلى ثلاثة أيام افتراضيًا. اطلب التقاطًا جديدًا باستخدام maxAgeMs: 0 عندما تحتاج إلى بيانات حديثة.
البحث والإجابات ومتابعة التغييرات
يستقبل Search عبارة بحث ويعيد روابط مرتبة وعناوين وأوصافًا، ويمكن إرفاق Markdown. ويستقبل Answers مهمة بحث ومثالًا لبنية JSON، ثم يعيد نتيجة منظمة مع روابط مصادر. راجع الصفحات الأصلية للتحقق من المعلومات المهمة.
ينشئ Monitors خط أساس ثم يقارن الفحوص اللاحقة للصفحات أو خريطة الموقع أو محتوى محدد وفق جدول. يمكن رصد اختلاف النص أو التغييرات المرتبطة بالتعليمات. تحقّق من اكتمال التشغيل الأول وتوقيعات webhook، وتابع عمليات الفشل؛ فالتقاط خط الأساس لا يرسل إشعار تغيير.
يوفّر Brand معلومات الشركة وشعاراتها وألوانها انطلاقًا من النطاق. ويستخرج Styleguide الخطوط والتباعد وأنماط المكونات، ما يفيد في تخصيص تجربة الانضمام إلى التطبيقات.
تنفيذ أول طلب وربط وكيل
- أنشئ حسابًا واحفظ مفتاح API السري على الخادم.
- اتبع دليل البدء الرسمي باستخدام cURL أو SDK لـTypeScript أو Python أو Ruby أو Go أو PHP.
- أرسل POST إلى
https://api.context.dev/v1/web/scrapeمع مصادقة Bearer وurlوformats: { "markdown": true }. ويمكن تحديد المحتوى الرئيسي عبرsharedParams.mainContentOnly. - افحص
markdown.successقبل استخدامmarkdown.data. قد تتضمن استجابة HTTP 200 مخرجًا فاشلًا، لذا افحص حالة كل صيغة. - وسّع نطاق الجمع بعد التحقق من العينة.
يوضح دليل MCP ربط العملاء المتوافقين مع https://mcp.context.dev/mcp عبر OAuth. تستهلك الاستدعاءات رصيد المؤسسة المتصلة.
الرصيد المجاني والأسعار
بحسب التحقق في 15 أكتوبر 2026، توفّر Free عدد 1,000 رصيد API شهريًا دون بطاقة. الأسعار العامة الشهرية بالدولار الأمريكي هي: Developer بسعر 19، وPro بسعر 99، وGrowth بسعر 299، وScale بسعر 499. وتشمل على الترتيب 7,500 و125,000 و500,000 و1,000,000 رصيد شهري. تُسعّر Enterprise حسب الطلب. راجع الأسعار الحالية للدفع السنوي وشروط الشراء؛ الأرقام ليست أسعارًا بالريال السعودي.
يبدأ Scrape العادي برصيد واحد، أو اثنين عند استخدام إجراءات المتصفح. ويضيف استخراج JSON الناجح أربعة. لدى Logo Link حصة منفصلة، منها 10,000 طلب لمرة واحدة في Free. قد تُحتسب النتائج الناجحة جزئيًا وصفحات الهدف ذات 404. وقد تضيف Auto-Topup كتلًا مدفوعة عند تفعيلها؛ تنبيهات الإنفاق ليست حدًا صارمًا للاستهلاك. راجع حدود حسابك الفعلية في لوحة التحكم.
معالجة البيانات وحدود إعادة الاستخدام
تسمح سياسة الخصوصية باستخدام الاستعلامات والنتائج لتحسين الخدمة وتدريب النماذج، وفق القيود والاتفاقات والقواعد المعمول بها. الطلبات العادية ليست تلقائيًا بلا احتفاظ.
يتطلب ZDR تفعيل صلاحية المؤسسة وإعدادًا صريحًا لكل استدعاء مدعوم. تحقّق من X-Context-ZDR: true. لا تدعم Batches وMonitors وBrand retrieval هذا الوضع، ويُتجاوز PDF OCR عند استخدامه. يجب إدارة سجلات تطبيقك وتخزينه، والتحقق من حقوق إعادة استخدام الصفحات والصور والشعارات.
أسئلة شائعة
هل يلزم تشغيل متصفحات ووكلاء شبكيين بنفسي؟
تدير الخدمة هذه البنية ضمن Scrape. لكن عليك اختبار المواقع الفعلية وفحص جودة النتائج.
هل يمكن الحصول على بيانات منظمة بدل النص؟
نعم، يدعم Scrape استخراج JSON وفق مخطط. افحص نجاح المخرج والحقول المهمة قبل الاعتماد عليها.
هل توجد بداية مجانية؟
نعم، تتوفر 1,000 رصيد API شهريًا دون بطاقة. يتغير عدد الصفحات بحسب العمليات والخيارات.
هل يسمح الوصول عبر API بإعادة نشر كل المحتوى؟
لا يمنح الوصول ترخيصًا لمواد الأطراف الثالثة. يجب التحقق من صلاحية استخدامها وحفظ المصادر.
الموارد الرسمية
- وثائق SDK: المكتبات ومتطلبات الربط.
- حالة الخدمة: متابعة التوفر.
- التواصل الرسمي: الدعم والاستفسارات التجارية.
- حساب X الرسمي: إعلانات المنتج.
أدوات ذات صلة
قواعد بيانات الذكاء الاصطناعي وبنية السياق →
CoreSpeedمجانية جزئيًا
اتصالات بالتطبيقات وذاكرة مستمرة وموافقات للوكلاء الذين تستخدمهم بالفعل.
AIsaمدفوعة
مفتاح API واحد للوصول إلى النماذج ومصادر البيانات الخارجية.
Tavilyمجانية جزئيًا
ابحث واستخرج وازحف وحقق في الويب الحديث لوكلاء الذكاء الاصطناعي عبر API واحدة
SuperLocalMemoryمجانية
احفظ قرارات المشروع وقواعده ليسترجعها مساعدوك المتصلون في جلسات لاحقة.
Crosswalkمجانية
اجمع النشرات والمصادر والملاحظات ليقرأها مساعد الذكاء الاصطناعي الذي تستخدمه.