
Retriever AI (rtrvr.ai)Freemium
Dalle istruzioni in linguaggio naturale a dati e attività web da verificare.
Context.dev: API di web scraping per agenti IA
Un’API per raccogliere pagine, ottenere dati strutturati e aggiornare il contesto degli agenti IA.
In parole semplici: a cosa serve Context.dev?
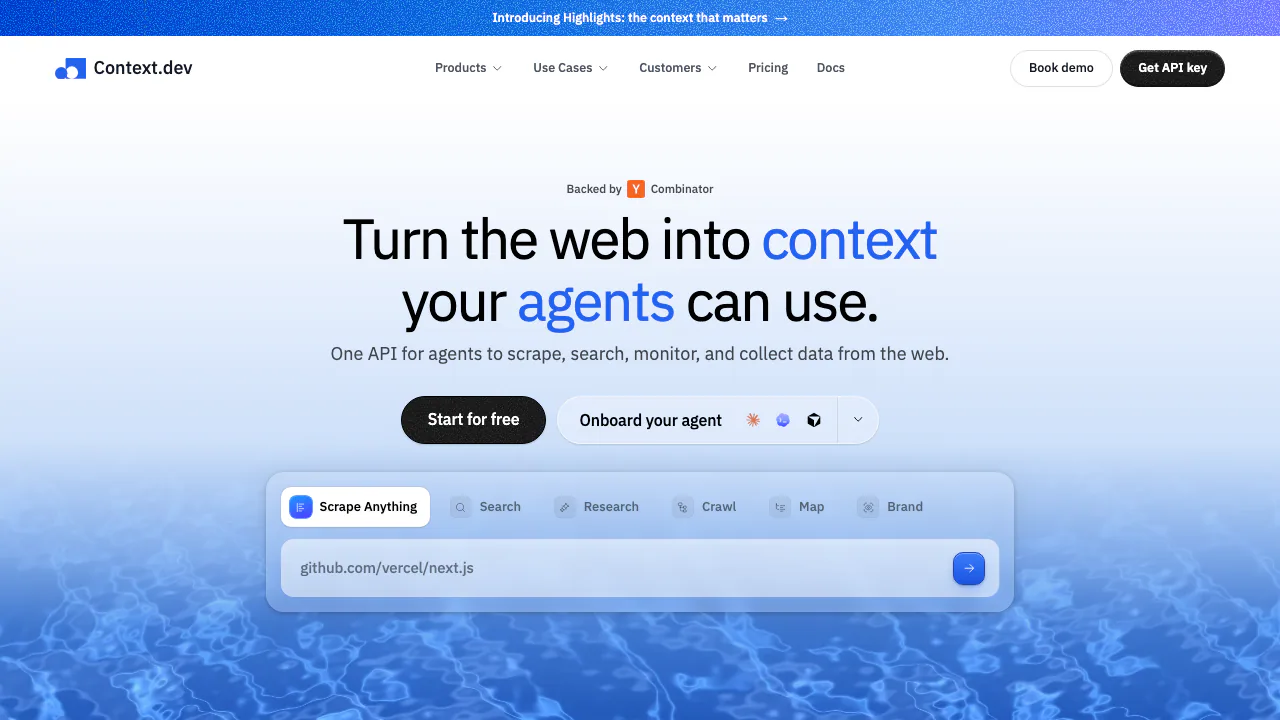
Context.dev è un’API di web scraping: il tuo programma invia un indirizzo web e riceve contenuti utilizzabili, come Markdown, HTML renderizzato, screenshot o campi strutturati. La piattaforma gestisce browser e proxy. Markdown mantiene titoli ed elenchi in un testo leggibile, utile quando un modello deve consultare una pagina.
Il servizio è gestito da Context Dev Inc. e si rivolge a sviluppatori di agenti IA, strumenti di ricerca e pipeline RAG. Nel RAG si recuperano fonti prima di generare una risposta; Context.dev fornisce il materiale web, mentre archiviazione, indicizzazione e interfaccia restano alla tua applicazione.
Dal primo URL a un risultato verificato
- Crea un account e conserva la chiave API segreta sul server.
- Segui la guida introduttiva ufficiale con cURL o un SDK TypeScript, Python, Ruby, Go o PHP.
- Invia un POST a
https://api.context.dev/v1/web/scrape, con autenticazione Bearer,urleformats: { "markdown": true }. Puoi limitare il contenuto principale consharedParams.mainContentOnly. - Controlla
markdown.successprima di usaremarkdown.data. HTTP 200 può contenere singoli output non riusciti; conserva l’ID della richiesta per le verifiche.
Scrape permette più formati nello stesso richiamo: testo per il modello, HTML per la struttura, screenshot per la verifica visiva e JSON con uno schema per i campi attesi. Rendering JavaScript e proxy sono inclusi nel prezzo base; le azioni del browser e alcune estrazioni hanno costi aggiuntivi.
Per un assistente compatibile puoi usare il server MCP ufficiale, all’indirizzo https://mcp.context.dev/mcp, con accesso OAuth. I richiami consumano i crediti dell’organizzazione collegata.
Costruire una raccolta di documenti per il RAG
Map scopre gli URL di un sito. Seleziona prima i percorsi utili, quindi usa Crawl per leggerli: una chiamata restituisce fino a 500 pagine Markdown, con controlli su profondità, percorsi e numero di pagine. Batches esegue raccolte maggiori in modo asincrono, con polling o webhook.
Prova un piccolo campione prima di indicizzare, verifica il testo principale e conserva le fonti. Scrape può riutilizzare output in cache fino a tre giorni per impostazione predefinita; maxAgeMs: 0 richiede una nuova acquisizione. La raccolta non crea automaticamente il tuo database RAG.
Dalla ricerca agli aggiornamenti del sito
Search accetta una query e restituisce URL ordinati, titoli e descrizioni, anche con Markdown. Answers parte da un incarico di ricerca e un oggetto JSON di esempio, producendo risultati strutturati con fonti. Controlla le fonti per le conclusioni importanti.
Monitors crea una base iniziale e confronta le acquisizioni successive secondo una pianificazione, rilevando differenze testuali o cambiamenti pertinenti alle istruzioni. Verifica il completamento della base, le firme dei webhook e gli errori delle esecuzioni: la prima acquisizione non genera un avviso di cambiamento.
Brand recupera dati aziendali, loghi e colori da un dominio. Styleguide aggiunge tipografia, spaziatura e stili dei componenti per personalizzare percorsi di onboarding.
Prezzi in dollari e consumo dei crediti
Verificato il 15 ottobre 2026: Free comprende 1.000 crediti API mensili senza carta. I listini pubblici mensili in USD sono Developer 19, Pro 99, Growth 299 e Scale 499, con rispettivamente 7.500, 125.000, 500.000 e 1.000.000 crediti mensili. Enterprise è su preventivo. Le condizioni annuali e di acquisto sono nella pagina prezzi; non si tratta di importi finali in euro.
Scrape parte da un credito, oppure due con azioni del browser. L’estrazione JSON riuscita aggiunge quattro crediti. Logo Link usa una quota separata, inclusi 10.000 richiami una tantum per Free. Successi parziali e pagine di destinazione 404 possono essere addebitati. Auto-Topup può aggiungere blocchi a pagamento; gli avvisi di spesa non bloccano i consumi. Controlla nel pannello i limiti effettivi del tuo account.
Dati, conservazione e riutilizzo
La privacy policy consente l’uso di query e risultati per migliorare il servizio e addestrare modelli, nei limiti delle norme e degli accordi applicabili. Le richieste standard non sono automaticamente a conservazione zero.
ZDR richiede un’abilitazione dell’organizzazione e un’opzione esplicita nelle chiamate supportate. Verifica X-Context-ZDR: true. Batches, Monitors e Brand retrieval non supportano questa modalità; PDF OCR viene saltato con ZDR. Restano da gestire i tuoi log e i diritti di riutilizzo dei materiali di terzi.
Domande frequenti
Come ottengo JSON strutturato?
Scrape può estrarre dati secondo JSON Schema. Controlla l’esito dell’output e verifica i campi che influenzano le decisioni.
Posso raccogliere un’intera documentazione?
Crawl legge fino a 500 pagine per chiamata. Per raccolte più grandi, utilizza Batches e recupera i risultati in modo asincrono.
Il piano gratuito basta per 1.000 estrazioni JSON?
Non necessariamente. I crediti gratuiti sono 1.000 al mese, ma JSON riuscito aggiunge quattro crediti al costo base.
Devo gestire personalmente i proxy?
Il servizio include proxy e rendering nel prezzo base di Scrape. Devi comunque provare i siti effettivi e controllare la qualità dei risultati.
Risorse ufficiali
- SDK: librerie e requisiti.
- Stato del servizio: disponibilità.
- Contatti: supporto e richieste commerciali.
- Profilo X ufficiale: annunci.
Strumenti correlati
Database e infrastruttura di contesto per l’IA →
CoreSpeedFreemium
Collegamenti alle app, contesto duraturo e approvazioni per i tuoi agenti.
AIsaA pagamento
Una chiave API per collegare modelli e fonti di dati agli agenti.
TavilyFreemium
Cerca, estrai, scansiona e analizza il web aggiornato per agenti IA tramite una sola API
SuperLocalMemoryGratis
Conserva regole e decisioni del progetto e recuperale dagli assistenti che hai collegato.
CrosswalkGratis
Consulta newsletter e fonti dal tuo assistente e conserva gli appunti utili.