
Retriever AI (rtrvr.ai)Freemium
Beschrijf een webtaak en controleer de tabel of uitgevoerde handelingen.
Context.dev: web scraping API voor AI-agents
Haal webpagina’s op als Markdown of JSON en geef AI-agents toegang tot bronnen en wijzigingen.
Eenvoudig uitgelegd: wat doet Context.dev?
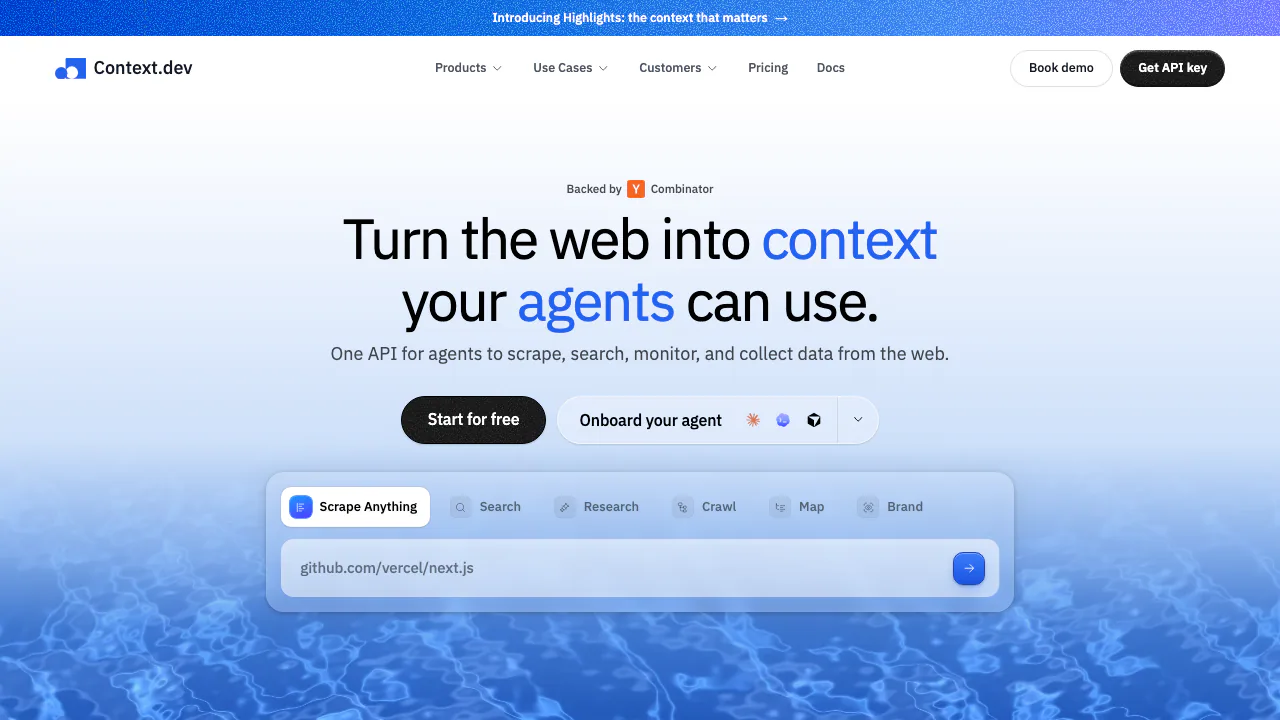
Context.dev is een web scraping API. Je toepassing stuurt een webadres en krijgt bruikbare inhoud terug: Markdown, gerenderde HTML, een screenshot of gestructureerde velden. De dienst beheert de browsers en proxy-infrastructuur. Markdown is leesbare tekst met bijvoorbeeld koppen en lijsten, geschikt om webinhoud aan een AI-model door te geven.
Context Dev Inc. levert deze dienst aan ontwikkelaars van AI-agents, onderzoekstools en RAG-toepassingen. RAG haalt relevante bronnen op voordat een model antwoordt. Context.dev verzamelt het webmateriaal; je eigen toepassing regelt opslag, indexering en presentatie.
Welke route past bij je gegevensvraag?
Gebruik Scrape voor een bekende URL. Vraag Markdown aan voor leesbare inhoud, HTML voor de paginastructuur, een screenshot voor een visuele controle of JSON-extractie met een JSON Schema voor vaste velden. JavaScript-rendering en proxy’s zijn inbegrepen in de basisprijs.
Gebruik Map om URL’s op een website te ontdekken. Selecteer daarna relevante paden en laat Crawl tot 500 pagina’s per aanroep als Markdown ophalen. Begrens diepte en omvang. Grotere verzamelingen laat je met Batches op de achtergrond verwerken; resultaten zijn via polling of webhook op te halen.
Wil je juist bronnen bij een onderwerp vinden, dan geeft Search gerangschikte URL’s, titels en beschrijvingen, eventueel met Markdown. Answers onderzoekt een taak en geeft een antwoord in een voorbeeldstructuur van JSON, met bronverwijzingen. Controleer belangrijke bevindingen bij de bron.
Eerst klein testen, daarna koppelen
- Maak een account en bewaar je geheime API-sleutel op de server.
- Kies cURL of een officiële TypeScript-, Python-, Ruby-, Go- of PHP-SDK in de snelstart.
- Stuur een POST naar
https://api.context.dev/v1/web/scrape, met Bearer-authenticatie,urlenformats: { "markdown": true }.sharedParams.mainContentOnlyricht zich op de hoofdinhoud. - Controleer
markdown.successvoordat jemarkdown.datagebruikt. Een HTTP 200 kan nog een mislukt uitvoerformaat bevatten. - Beoordeel enkele representatieve pagina’s en bewaar bron-URL’s voordat je je eigen RAG-index vult.
Scrape kan standaard uitvoer uit een cache van maximaal drie dagen gebruiken. Stel maxAgeMs: 0 in als je een nieuwe opname nodig hebt. De MCP-handleiding beschrijft hoe compatibele clients via OAuth verbinding maken met https://mcp.context.dev/mcp; aanroepen gebruiken je organisatiecredits.
Veranderingen volgen en merken verrijken
Monitors maakt eerst een basisopname en vergelijkt volgende controles op een schema. Je kunt tekstverschillen volgen of instructies geven voor relevante veranderingen. Controleer de basisrun, valideer webhookhandtekeningen en bekijk mislukte runs. De eerste basisopname verstuurt geen wijzigingsmelding.
Brand haalt bedrijfsinformatie, logo’s en kleuren op aan de hand van een domein. Styleguide voegt typografie, afstanden en componentstijlen toe. Dit kan helpen bij gepersonaliseerde productintroducties, maar geeft geen automatisch gebruiksrecht op het merk.
Gratis credits en betaalde capaciteit
Gecontroleerd op 15 oktober 2026: Free biedt maandelijks 1.000 API-credits zonder creditcard. De openbare maandprijzen in USD zijn Developer 19, Pro 99, Growth 299 en Scale 499. Daarbij horen respectievelijk 7.500, 125.000, 500.000 en 1.000.000 credits per maand. Enterprise is op aanvraag. Bekijk actuele prijzen voor jaarbetaling en afrekenvoorwaarden; dit zijn geen euro-eindprijzen.
Een gewone Scrape begint bij één credit. Browseracties maken de basis twee; geslaagde JSON-extractie voegt vier toe. Logo Link heeft een afzonderlijk tegoed, waaronder eenmalig 10.000 gratis verzoeken. Gedeeltelijk geslaagde resultaten en doelpagina’s met 404 kunnen kosten tellen. Auto-Topup kan betaalde blokken toevoegen; bestedingsmeldingen stoppen het verbruik niet automatisch. Controleer effectieve aanvraag- en gelijktijdigheidslimieten in je dashboard.
Privacy en eigen gegevensbeheer
Het privacybeleid staat gebruik van vragen en resultaten voor productverbetering en modeltraining toe, binnen toepasselijke afspraken en beperkingen. Standaardverzoeken hebben dus niet automatisch nulbewaring.
Zero data retention vraagt organisatieautorisatie en een expliciete instelling per ondersteunde aanroep. Controleer X-Context-ZDR: true. Batches, Monitors en Brand retrieval ondersteunen deze modus niet; PDF-OCR wordt onder ZDR overgeslagen. Beheer ook je eigen logboeken en de rechten voor hergebruik van bronmateriaal.
Veelgestelde vragen
Wat is het verschil tussen een scraping API en een gegevensbestand?
Je toepassing vraagt via HTTP gegevens op bij de dienst. Je moet het resultaat nog zelf controleren, opslaan en verwerken.
Kan ik kiezen welke uitvoer ik krijg?
Ja. Scrape ondersteunt onder andere Markdown, HTML, screenshots en JSON-extractie. Controleer het succes per uitvoer.
Is er een gratis startmogelijkheid?
Free bevat 1.000 maandelijkse API-credits zonder creditcard. Het aantal verwerkte pagina’s hangt af van de gekozen opties.
Krijg ik altijd de nieuwste pagina?
Niet automatisch: Scrape kan de cache gebruiken. Met maxAgeMs: 0 vraag je een verse opname aan.
Officiële bronnen
- SDK-documentatie: bibliotheken en voorwaarden.
- Dienststatus: beschikbaarheid controleren.
- Contact: ondersteuning en zakelijke vragen.
- Officieel X-account: productnieuws.
Vergelijkbare tools
AI-databases en contextinfrastructuur →
CoreSpeedFreemium
Appkoppelingen en gedeelde context voor de AI agents die je al gebruikt.
AIsaBetaald
Eén API-sleutel voor modellen en externe gegevensbronnen.
TavilyFreemium
Doorzoek, extraheer, crawl en onderzoek het actuele web voor AI-agenten via één API
SuperLocalMemoryGratis
Bewaar projectbesluiten en regels en vind ze terug via je gekoppelde AI-assistenten.
CrosswalkGratis
Laat je eigen AI nieuwsbrieven, feeds en opgeslagen notities raadplegen.