
Retriever AI (rtrvr.ai)Freemium
Décrivez une tâche web et vérifiez les données ou actions obtenues.
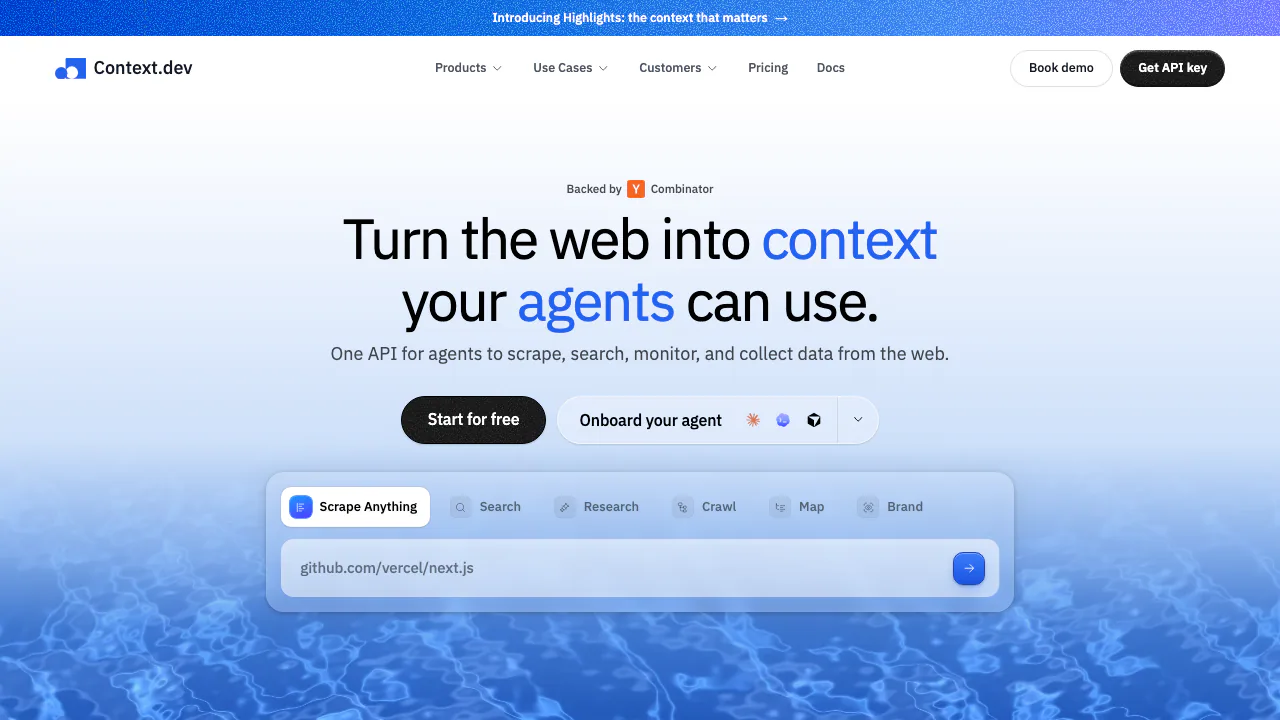
Context.dev : API de scraping web pour agents IA
Récupérez des pages en Markdown ou JSON, explorez des sites et suivez leurs changements depuis une API.
Explication simple : à quoi sert Context.dev ?
Context.dev est une API de scraping web pour les applications qui ont besoin de lire Internet. Votre programme envoie une URL et demande un résultat : texte Markdown, HTML rendu, capture d’écran ou champs structurés. Le service prend en charge l’infrastructure de navigateurs et de proxys. Markdown conserve une structure lisible, pratique pour transmettre un document à un modèle.
Exploité par Context Dev Inc., il s’adresse aux développeurs d’agents IA, d’outils de recherche et de chaînes RAG. Le RAG consiste à retrouver des sources avant de répondre. Context.dev apporte les données web ; votre application conserve la responsabilité du stockage, de l’indexation et de la restitution.
Choisir le bon parcours de collecte
Avec une URL précise, Scrape récupère les formats demandés dans un même appel. L’extraction JSON suit un JSON Schema pour les champs attendus. Le rendu JavaScript et les proxys sont compris dans le tarif de base ; certaines options consomment davantage de crédits.
Pour une documentation entière, commencez par Map afin de découvrir les URL, puis limitez les chemins à conserver. Crawl suit les liens et retourne jusqu’à 500 pages en Markdown par appel, avec des limites de profondeur et de volume. Batches traite des listes ou des sites plus importants en arrière-plan, avec interrogation du statut ou webhook.
Testez quelques pages avant d’alimenter votre propre index RAG et conservez leurs sources. Scrape peut réutiliser des sorties en cache âgées de trois jours par défaut. Utilisez maxAgeMs: 0 quand une nouvelle capture est nécessaire.
Rechercher des sources et suivre leurs évolutions
Search reçoit une requête et renvoie des URL classées, avec titres et descriptions, éventuellement accompagnées de Markdown. Answers reçoit une tâche et un exemple d’objet JSON pour produire une réponse structurée avec des sources. Vérifiez les pages citées pour les informations déterminantes.
Monitors établit une référence, puis compare des pages, sitemaps ou contenus sélectionnés selon un calendrier. La détection peut porter sur le texte ou sur les changements pertinents selon vos instructions. Contrôlez le succès de la référence, vérifiez les signatures des webhooks et surveillez les exécutions échouées : la première capture ne déclenche pas d’alerte de changement.
Brand ajoute des profils d’entreprise, logos et couleurs à partir d’un domaine. Styleguide extrait notamment la typographie, les espacements et les styles de composants pour personnaliser un parcours produit.
Effectuer un premier appel et connecter un assistant
- Créez un compte et stockez la clé API secrète côté serveur.
- Suivez le guide de démarrage avec cURL ou un SDK TypeScript, Python, Ruby, Go ou PHP.
- Envoyez un POST à
https://api.context.dev/v1/web/scrape, avec authentification Bearer,urletformats: { "markdown": true }.sharedParams.mainContentOnlypermet de cibler le contenu principal. - Vérifiez
markdown.successavant de liremarkdown.data. Un HTTP 200 ne garantit pas la réussite de chaque sortie. - Étendez ensuite la collecte avec des limites explicites.
Le guide MCP décrit la connexion des clients compatibles à https://mcp.context.dev/mcp via OAuth. Les appels utilisent les crédits de l’organisation connectée.
Crédits gratuits et coût réel des extractions
Vérification du 15 octobre 2026 : Free offre 1 000 crédits API par mois sans carte bancaire. Les tarifs publics mensuels en dollars américains sont de 19 pour Developer, 99 pour Pro, 299 pour Growth et 499 pour Scale, avec respectivement 7 500, 125 000, 500 000 et 1 000 000 crédits mensuels. Enterprise est sur devis. Consultez les tarifs actuels pour l’abonnement annuel et les conditions de paiement ; ces montants ne sont pas des prix finaux en euros.
Un Scrape standard commence à un crédit ; les actions navigateur portent la base à deux et l’extraction JSON réussie ajoute quatre. Logo Link possède son propre quota, dont 10 000 requêtes gratuites en une seule dotation. Les succès partiels et les pages cibles en 404 peuvent être facturés. Auto-Topup peut ajouter des blocs payants ; une alerte de dépense ne bloque pas les appels. Les limites effectives figurent dans votre tableau de bord.
Confidentialité et droits sur les sources
La politique de confidentialité autorise l’utilisation des requêtes et résultats pour améliorer le service et entraîner des modèles, sous réserve des règles et accords applicables.
La rétention zéro nécessite une habilitation de l’organisation et un paramètre par appel compatible. Vérifiez X-Context-ZDR: true. Batches, Monitors et Brand retrieval ne prennent pas en charge ce mode ; PDF OCR est ignoré sous ZDR. Vos propres journaux restent à gérer. L’accès API ne donne pas de licence de réutilisation des contenus ou des logos tiers.
Questions fréquentes
Faut-il gérer des navigateurs et des proxys ?
Cette infrastructure est gérée par le service et incluse dans la base de Scrape. Testez toutefois vos pages réelles et contrôlez les résultats.
Comment obtenir un objet JSON ?
Demandez le format JSON avec le schéma attendu. Vérifiez le succès de cette sortie et la qualité des champs avant de les exploiter.
Peut-on commencer gratuitement ?
Oui, avec 1 000 crédits API mensuels sans carte bancaire. Le nombre d’extractions dépend des options utilisées.
Le résultat est-il toujours une nouvelle lecture du site ?
Non. Scrape peut utiliser son cache ; demandez maxAgeMs: 0 si la fraîcheur est nécessaire.
Ressources officielles
- SDK officiels : bibliothèques et prérequis.
- État du service : disponibilité.
- Contact : assistance et besoins commerciaux.
- Compte X officiel : annonces produit.
Outils similaires
Bases de données et infrastructure de contexte IA →
CoreSpeedFreemium
Des connexions aux applications et une mémoire durable pour vos agents existants.
AIsaPayant
Un accès commun aux modèles et aux API de données pour vos agents.
TavilyFreemium
Recherchez, extrayez, explorez et analysez le Web en direct pour des agents IA via une API
SuperLocalMemoryGratuit
Retrouvez les décisions et règles de vos projets dans vos différents assistants connectés.
CrosswalkGratuit
Retrouvez newsletters, flux et notes dans votre assistant IA habituel.